検索結果 20
20 コミュニティ
1つのキーワードが1つのコミュニティです。
アカウント
見つかりません
20 を含む検索結果

# ADKの便利で実践的な使い方
## 🎨 実戦で使えるコールバックパターン集!ADKのCallback Design Patterns
コールバックの基本は分かった、でも実際どう使うの?ADKの **Callback Design Patterns** で、ログ・キャッシュ・セキュリティなど実戦パターンをマスターしましょう!💪
## 📌 タイトル
Callback Patterns(コールバックデザインパターン)
## 🔗 URL
## 🧩 概要
ADKのコールバックには、実戦で繰り返し使われる定番パターンがあります。ロギング、キャッシュ、ステート管理、セキュリティガードレール、リクエスト/レスポンス変換、条件付きスキップ、アーティファクト処理などです。
さらに、これらのパターンを効果的に使うためのベストプラクティス(単一責任、パフォーマンス、冪等性、エラーハンドリング)も定義されています。
重要な判断基準として、**エージェント横断のセキュリティガードレールにはCallbacksよりもPluginsが推奨**されています。
## 🛠 使い方
**パターン1: ロギング&モニタリング**
`logging_before_tool(ctx, tool, args)` では `ctx.invocation_id`、` を ` で記録し、`None` を返してフローを変更しません。`logging_after_model(ctx, response)` では ` の長さを ` で記録し、同様に `None` を返して観察のみ行います。
**パターン2: キャッシュ戦略**
`cache_before_tool(ctx, tool, args)` では、` と `hash(str(args))` からキャッシュキーを生成し、`ctx.state.get(cache_key)` でキャッシュを検索します。キャッシュヒットすればその値を返してツール実行をスキップし、ミスなら `None` を返して通常実行します。`cache_after_tool(ctx, tool, args, tool_ctx, result)` では、同じキャッシュキーで `ctx.state[cache_key] = result` として結果を保存し、`None` を返してフローを変更しません。
**パターン3: ステート管理**
`state_aware_callback(ctx, req)` では、`ctx.state.get("user:tier", "free")` でユーザーティアを取得し、`"premium"` であれば `req.config.system_instruction` にプレミアム向けの追加指示を動的に付加します。`None` を返してフローはそのまま続行します。
## 🏗 実践的な使い方
**本番環境での多層防御パターン:**
セキュリティガードレール(本番ではPluginsを推奨)として `security_before_model(ctx, req)` を定義します。`req.contents[-1].parts[0].text` からユーザー入力を取得し、`detect_pii()` でPIIを検出した場合は `audit_log()` で監査記録を残し、拒否メッセージ入りの `LlmResponse` を返してLLM呼び出しをスキップします。続いて `detect_injection()` でプロンプトインジェクションを検出した場合も同様にブロックします。いずれにも該当しなければ `None` を返して続行します。ツール引数のサニタイズとして `sanitize_before_tool(ctx, tool, args)` を定義し、` が `"database_query"` の場合に `args.get("query", "")` に `"DROP"` が含まれていればエラー辞書を返してツール実行をブロックします。アーティファクト保存として `save_artifact_after_agent(ctx)` を定義し、`generate_report(ctx)` でレポートを生成して `"execution_report.json", report)` で保存し、`None` を返します。
## 💡 ユースケース
- 📊 **構造化ロギング**:全実行ポイントで invocation_id 付きの構造化ログを出力
- 💾 **APIコスト削減**:before/after パターンでツール結果をキャッシュし、同じ引数の再呼び出しを防止
- 🔐 **多層セキュリティ**:PII検出、インジェクション防止、SQLサニタイズを各レイヤーに配置
- 📦 **アーティファクト管理**:実行結果やレポートをアーティファクトとして自動保存
- 🎚️ **動的振る舞い制御**:ユーザーティアやステートに応じてインストラクションを動的変更
## ⚠️ 注意点
- **単一責任の原則**:1つのコールバックに1つの目的を持たせてください(ロギングとバリデーションを混ぜない)
- **パフォーマンス**:コールバックは同期実行されるため、ブロッキングI/Oや重い処理は避けましょう
- **冪等性**:外部副作用を持つコールバックは、リトライ時に安全であるように設計してください
- **エラーハンドリング**:必ず try-except で囲み、コールバックエラーがプロセス全体をクラッシュさせないようにしましょう
- **Plugins推奨**:エージェント横断のセキュリティポリシーには、Callbacksよりも **Plugins** を検討してください
## ✨ まとめ
コールバックパターンを知ることで、ADKエージェントの実践力が格段に上がります。ログ・キャッシュ・セキュリティ・ステート管理…定番パターンを組み合わせて、堅牢でコスト効率の良いエージェントを構築しましょう。ただし、横断的なセキュリティにはPluginsの利用もお忘れなく!
#ADK# #AIAgent#
もっと見る

# OpenAI Agent SDKの便利だけど知られていない機能
🌍 複数の LLM プロバイダを 1 つのエージェントシステムで混在させたいと思ったことはありませんか?
`MultiProvider` を使えば、モデル名のプレフィックスで自動的にプロバイダをルーティングできます。
📌 タイトル:MultiProvider による接頭辞ルーティング
🔗 URL:
🧩 概要
`MultiProvider` は、モデル名のプレフィックス(例:`openai/gpt-4.1`)に基づいてリクエストを適切なプロバイダに自動ルーティングします。`openai_prefix_mode="model_id"` を設定すると `openai/...` をそのままモデル ID として扱い、`unknown_prefix_mode="model_id"` で未知のプレフィックスもモデル ID としてルーティングします。`openai_use_responses_websocket=True` で WebSocket トランスポートも有効化可能です。
🛠 使い方
```python
from agents import Agent, MultiProvider, RunConfig, Runner
provider = MultiProvider(
openai_base_url="",
openai_api_key="...",
openai_use_responses_websocket=True,
openai_prefix_mode="model_id",
unknown_prefix_mode="model_id",
)
agent = Agent(
name="Assistant",
instructions="Be concise.",
model="openai/gpt-4.1",
)
result = await
agent,
"Hello",
run_config=RunConfig(model_provider=provider),
)
```
🏗 本番システムへの組み込み方
・コストやレイテンシに応じて、エージェントごとに異なるプロバイダのモデルを割り当てる
・OpenRouter などの統合ゲートウェイと組み合わせ、`openai_prefix_mode="model_id"` でプレフィックス付きモデル名をそのまま渡す
・`RunConfig(model_provider=provider)` で実行時にプロバイダを切り替え、A/B テストを実施する
・WebSocket を有効にして、対応プロバイダでのストリーミング性能を向上させる
💡 ユースケース
🔀 タスクの難易度に応じた GPT-4.1 / GPT-5.5 の使い分け
🌐 OpenRouter 経由での複数プロバイダへのアクセス統合
💰 高コストモデルと低コストモデルのハイブリッド運用
🧪 異なるモデル間での品質比較テスト
⚠️ 注意点
デフォルトでは `openai/...` は OpenAI プロバイダのエイリアスとして扱われ、未知のプレフィックスは `UserError` を発生させます。OpenRouter など外部ゲートウェイを使う場合は、必ず `openai_prefix_mode` と `unknown_prefix_mode` を `"model_id"` に設定してください。プロバイダごとに対応する機能(ツール呼び出し、構造化出力など)が異なる点にも注意が必要です。
✨ MultiProvider で、複数のモデルを自在に組み合わせたエージェントシステムを構築しましょう。
#OpenAIAgentSDK# #AIAgent#
もっと見る

『なぜAIは高くつくのか、コストの無駄はどこで生まれるのか』というブログを投稿しました。
AIが高い原因はモデルの単価だけではない。コストの無駄がどこで生まれるか、技術的・TCO的に整理しました。
もっと見る


【気になる展覧会】
「川内理香子 LOVE, Wild Grape, Tiger, heart」
📍大田区立龍子記念館(西馬込)
📅9月12日〜11月8日
もっと見る

TL;DR: 実カルテは公開できずラベルも不完全という臨床AIベンチマークの根本問題を、完全合成データで解決した研究です。フロンティアモデルでもトップ医師の性能には届きませんでした。
タイトル: Synthetic Hospital: An Open, Verifiable, Physician-Validated Longitudinal EHR Benchmark
URL:
ポイント
🏥 医学教育教材から1,268人・5,602受診分の完全合成カルテを構築し、個人情報ゼロで公開可能に
🔗 診断・所見・時間関係をICD-10-CM/SNOMED CT/LOINCへ決定的に紐づけ、ラベルは知識グラフから機械的に導出
👨⚕️ 医師によるリアリズム検証で、実カルテとの識別精度はほぼチャンスレベルの53%
📊 10モデルを5タスクで評価。患者診断の最高スコアはKimi 2.5-thinkingの重症度加重F1 0.732で医師平均と同水準
⚠️ トップ医師(0.89)には未到達。要約タスクではどのモデルも所見の約半分を見落とし
🔁 生成モデルを変えても性能変化は0.05以下、臨床状態そのものを測るベンチマークであることを確認
臨床LLMの実力を偽りなく測れる基盤が整った意義は大きいと感じます。
#医療AI# #LLMベンチマーク#
もっと見る
【気になる展覧会】
「カルン・タカール・コレクション インド更紗 世界をめぐる物語」
📍新居浜市美術館 (新居浜)
📅7月25日〜9月27日
もっと見る

アーティゾン美術館、2027年の展覧会スケジュールが公開。ヴェネチア・ビエンナーレ帰国展、新収蔵品でたどる「いま」など
初公開となる浮世絵から、荒川ナッシュ医、新収蔵品によるコレクション展まで。各展覧会と同時開催される小企画も充実のラインアップ
もっと見る


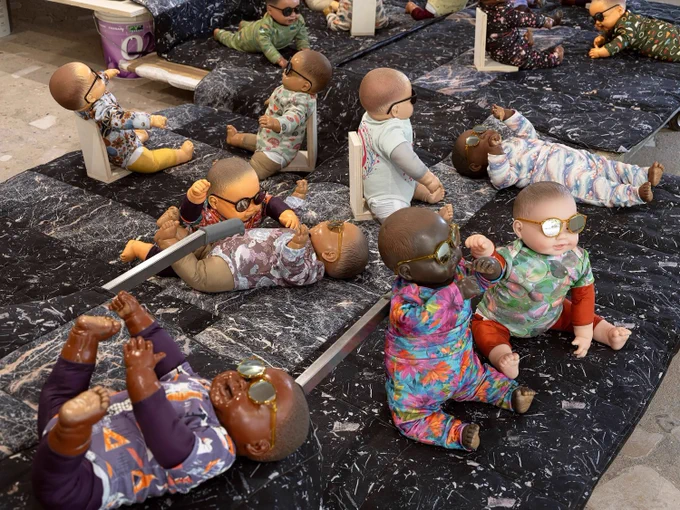

【気になる展覧会】
AOISIMON 「COMIC WORLD」
📍New Gallery(神保町)
📅10月2日〜10月18日

もし1回のフォワードパスで、まったく別の2つの文章を同時に「読み進められる」としたら。
Transformerは自己注意やMLPといった強い非線形の塊です。だから2つの文脈を1つの入力に混ぜてしまえば、出力はどちらとも無関係などこかに潰れてしまう、というのが自然な直感でした。
ところがこの論文は、その直感を覆します。2つの文章のトークン埋め込みを単純に平均して1本の入力として与えても、出てくる次トークン分布には両方の文脈の情報がはっきり残っていたのです。Pythia・Llama・Qwenなど複数のモデルで確かめたところ、正解トークンが上位10位以内に入るケースが30〜40%、上位100位まで広げると60〜65%にも達しました。
さらに興味深いのは、この「重ね合わせ」能力が学習で獲得されるのではなく、初期化直後が最も強く、事前学習が進むほど単調に弱まっていくという発見です。つまりアーキテクチャに内在する性質であり、事前学習データのわずか0.025%未満というごく軽いファインチューニングだけで、大きく回復させることもできました。この性質を使い、著者らは1回のフォワードパスから2つの独立した文章の続きを同時に生成する誘導デコード手法まで提案しています。
タイトル: Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
URL:
#LLM# #Transformer#
もっと見る
松たか子が語る映画『ナギダイアリー』。彫刻と演技、「残らない存在でいたい」という思い
深田晃司監督・脚本による映画『ナギダイアリー』が全国公開。自然豊かな町「ナギ」で創作に打ち込む彫刻家を演じた松にインタビュー
もっと見る