検索結果 AI解碼
AI解碼 コミュニティ
1つのキーワードが1つのコミュニティです。
アカウント
見つかりません
AI解碼 を含む検索結果

重點解讀台積電的玻璃核心載板投影片
台積電在 6 月 11 日的日本 JPCA Show 2026,進行主題為「AIの進化に不可欠な先端パッケージング技術」的簡報,該份簡報約40頁,當中某張標題為「Glass Substrate Development for CoWoS」的投影片流出,引發廣泛關注。
以下是對該投影片(見附圖)的重點解讀,能網路科普查到的技術細節就不多說了,要注意的是投影片上的 COP 不是 Chip-on-Package 的縮寫,而是 Coplanarity、也就是平整度 / 共面度。
▌重點結論:
1. 台積電正式宣布與 Ibiden 以及群創合作,開發玻璃核心載板(glass core substrate),結構為玻璃上下各黏合 ABF 的三層結構設計,該技術就是用於 CoPoS 的 oS。
2. 市場低估玻璃核心載板的重要性,該技術對台積電是「must have」,意即 CoPoS 中,oS 的重要性高於 CoP,這也是該技術進行測試時,先搭配既有的 CoW 而非 CoP 的原因。
3. 玻璃核心載板單價較既有 ABF 載板高出數倍,群創加工的玻璃單價非常高,為最核心的材料。除 Nvidia 外,目前已有兩家美系客戶同樣表達高度興趣。
▌與本投影片相關的產業調查:
1. 本投影片提及的玻璃核心載板由 250x250mm 切割而來,ABF 增層主要採用 Ajinomoto 的 GL107 並混搭 ABF-GCP,以 2027–2028 主流 AI 晶片 ABF 規格的 24-28 層進行測試
2. 台積電實驗時的 CoW 是測試載具(test vehicle),足以驗證採用複合材料時最具挑戰性的機械結構問題。測試結果良好意味著台積電、Ibiden 與群創已合作突破關鍵技術瓶頸。
3. 目前是由 Ibiden 負責切割 250x250mm 的玻璃核心載板。待 2H27 採用 510x515mm 做量產前模擬時,若 Ibiden 仍想降低生產複雜性以維持超高毛利率,可能會改交由更熟悉玻璃特性的群創切割。
▌流出的投影片內容是將 CoPoS 中的 oS、也就是玻璃核心載板(投影片中的 glass-SBT)與 CoW 搭配的技術驗證結果,這是為解決該投影片前一頁所提到的「Substrate mechanical and electrical Dilemma」,而這顯著凸顯了 CoPoS 中 oS 的重要性。
1. CoPoS 中,CoP 要解決的是生產效率 / 切割經濟性的問題,這與成本與售價有關;而 oS 要解決的是翹曲與耐用性問題,這牽涉到能否做出晶片,以及晶片能否運作。
2. CoP 與 oS 兩者整合相得益彰,但展望未來數年,兩者的技術定位還是有些差異。CoP 是可選的絕佳優化選項(very-nice-to-have),沒有它的代價就是晶片更貴;但 oS 是必需品(must-have), 沒有它可能連能否做出可用晶片都是問題。
3. 比較定位差異不是為了捧 oS 貶 CoP,這牽涉到客戶願意為哪個技術環節付錢的現實問題,細節下面分析。
▌投影片中含金量最高的是電源完整性(power integrity;PI)改善,這對客戶意義重大,這也代表玻璃核心載板生產穩定後,台積電獲利能力與競爭優勢可望同步提升。
1. 技術說明:玻璃核心載板薄 → TGV(through glass via)垂直導通路徑短 → 導通路徑電阻(R)跟迴路電感(L)同降 → PI 改善
2. 對客戶意義重大原因:PI 改善 → 供電更穩 → 釋出功率餘裕(power headroom)→ 可整合更多電晶體、或拉高運作時脈 → AI 晶片算力提升
3. 對客戶而言,生產效率是台積電的基本責任,客戶不會為此多付錢;但 AI 算力提升能直接轉化為客戶的競爭力與獲利,故客戶願意為此買單。這也是 Nvidia 積極看待玻璃核心載板的原因。
4. 對台積電而言,玻璃核心載板可提升良率並降低成本,同時提高 AI 晶片的算力與售價,既是降本工具,也是漲價籌碼,對獲利與競爭力都是加分。
5. 目前載板成本佔 AI 晶片 BOM 約低個位數,封裝良率造成的損失約載板成本的 5-10 倍,故即便未來玻璃核心載板成本高於目前的數倍以上,但佔 BOM 比重仍低,且可改善封裝良率造成的損失,故預期玻璃核心載板的高單價不會影響客戶採用意願。
▌簡報後的問答環節,有聽眾提問關於玻璃核心載板的 TGV 細節,台積電當場拒絕回答,因為玻璃核心載板的關鍵技術就是 TGV,核心 know-how 目前掌握在台積電與群創手中。相較下,另一個提問者的問題是關於 IVR、eDTC、與 LSI 的整合,台積電就回答了不少。
▌根據產業調查,若一切順利,台積電的目標是在 4Q28-1Q29 開始量產玻璃核心載板,以符合 Nvidia AI 晶片迭代節奏。順帶一提,許多人在傳的 Ibiden 的法說投影片,上面將玻璃核心載板時程列為 CY30,我對此的解讀是:對外向來保守謹慎的 Ibiden 將玻璃核心載板正式列為發展路線,這更確定了該技術長期趨勢。但從 Ibiden 投影片的其他細節與市場資訊不完全一致來看,例如 reticle 時程與台積電公開宣稱的差約一個世代、Rubin Ultra 載板尺寸明顯大於其在 CY26-27 標示的 90x90 等,這說明了在預測未來時,需隨時多方交叉驗證。
もっと見る


美銀:AI泡沫破裂或引發美股與美債收益率同步下跌
美銀衍生品團隊警告,AI泡沫若最終破裂,市場將呈現與近月截然不同的走勢——不是慣常的「股跌債漲」(收益率上升),而是股票與美債收益率同步下行。
10月8日《金融時報》披露OpenAI年化收入遠低於市場傳聞,納指重挫逾1%、費半跌3.4%,美債收益率同步走低,被美銀定性為「AI解倉最佳預演」。10月14日CPI超預期一度推升收益率,但CoreWeave崩跌逾15%、CDS利差擴大135個基點後,收益率漲勢迅速逆轉;15日10年期收益率再降10個基點至5.09%。
傳導邏輯:
私人AI生態(OpenAI、Anthropic等)壓力首先猛烈衝擊納指(公開市場高敞口代理標的),同時因AI資本開支放緩、電力與資源需求下降,疊加對增長與通脹的雙重壓制,將債市拉向避險模式。歷史參照為2000年互聯網泡沫,納指崩盤時10年期收益率從約6.5%降至4%中段。
信用端風險同步暴露:
CoreWeave被指為AI領域的「次級抵押貸款分級」,融資成本約9%而回報僅約1%,五年內隱含違約概率達63%;恐慌蔓延至DigitalOcean、Hut 8、Oracle等,本週AI板塊相對標普非AI成分股跑輸達840個基點。
泡沫指標顯示集中於局部而非全面(僅13隻股票BRI>0.8,權重約2.4%),但資產負債表風險更需警惕。低波動率被做市商龐大gamma與0DTE供給人為壓制。
もっと見る


【スポーツナビ】生成AIがプロ野球の試合状況を解説する新機能「AI野球解説(β版)」の提供を開始


# AIエージェント開発の意思決定ポイント
🎯 ポイント
LLMにドメイン知識を与えたい。RAG?ファインチューニング?ロングコンテキスト?
「とりあえずRAGで」と思考停止していませんか?この三択、実は知識の性質によって最適解がまったく異なります。選び間違えると、古い情報で回答し続けたり、出典を示せなかったり、トークンコストが爆発したり。正しく選ぶための判断軸を整理しましょう。
📋 概要
AIエージェントにドメイン固有の知識を持たせる方法は大きく3つあります。RAG(検索拡張生成)はベクトルDBなどから関連情報を検索してプロンプトに注入する方式。ファインチューニング(FT)はモデルの重みを追加学習で調整して知識を焼き込む方式。ロングコンテキストは大きなコンテキスト窓にドキュメントをそのまま投入する方式です。それぞれ知識の格納場所・更新サイクル・コスト構造が根本的に異なるため、ユースケースに応じて主軸を1つ選ぶ必要があります。
🔍 意思決定のポイント
判断の核心は「知識がどのくらいの頻度で変わるか」と「出典の明示が必要か」です。
📌 知識の鮮度が命なら → RAG一択。FAQや価格、在庫情報など頻繁に変わるデータは、インデックスを更新するだけで即座に反映されます。FTでは再学習に日〜週単位かかり、現実的ではありません。
📌 出典を示す必要があるなら → これもRAG。「この回答の根拠はどのドキュメントの何ページか」を提示できるのはRAGだけです。FTで焼き込んだ知識は「モデルがそう知っている」状態であり、事後に追跡不可能。説明責任が求められる環境では致命的です。
📌 出力の様式・口調を統一したいなら → FT。「常に法務文書の形式で出力する」のようなスタイルの一貫性は、RAGで例を注入しても安定しません。FTでモデルレベルに染み込ませることで、推論時の例示注入が不要になり、コンテキスト窓の節約にもなります。
📌 少数の文書を丸ごと理解させたいなら → ロングコンテキスト。契約書全体の解釈のように文書構造が重要な場合、チャンク分割で文脈が断絶するRAGよりも、全文をそのまま投入する方が精度が高くなります。
💡 要点と詳細
🔹 RAGの本質的な強みは「知識とモデルの分離」です。知識はインデックスに、推論能力はモデルに。この分離により、知識の更新がモデルの再学習を必要としません。ただし検索品質に依存するため、チャンク分割・埋め込みモデル・リランキング戦略のチューニングが品質を左右します。
🔹 FTの本質的な強みは「行動様式の安定的な変容」です。繰り返し同じ形式で出力する場面では、推論コストがRAGより低くなりえます。ただし知識の更新にはデータセット準備→学習→検証のサイクルが必要で、機動力に欠けます。
🔹 ロングコンテキストの本質的な強みは「実装の単純さ」です。ベクトルDB、検索パイプライン、チャンク分割、FTのインフラがすべて不要。ただしトークン課金がそのままコストに直結し、"Lost in the Middle"問題(窓の中盤の情報に注意が薄れる)もあるため、大量の文書には向きません。
⚖️ トレードオフ
RAGは鮮度と出典追跡に優れるが、検索パイプラインの構築・運用が必要。FTは様式の一貫性に優れるが、知識の更新が遅く出典が不透明。ロングコンテキストは実装が最も簡単だが、コストとスケーラビリティに制約あり。
🏆 実務での定石は「様式はFT、事実はRAG」のハイブリッド。FTで出力形式・口調・専門用語をモデルに染み込ませ、RAGで最新の事実情報を注入する。ロングコンテキストは、RAGのチャンク分割では失われる文脈が重要な場面で補完的に使います。
🛠️ ユースケース
🏢 社内ナレッジベースQ&A → RAG。ドキュメントは日々更新され、回答には出典の提示が求められる。
⚖️ 法務文書レビュー → FT+RAG。法務特有の口調と形式はFTで統一し、最新の判例や規制はRAGで注入。
📄 契約書の全体解釈 → ロングコンテキスト。契約書1通を丸ごと投入し、条項間の関係を把握させる。
🏥 医療情報提供 → RAG必須。出典の明示が絶対要件であり、情報の鮮度も重要。FTで焼き込んだ医療知識はハルシネーションと区別できず危険。
迷ったらRAGから始めてください。ほとんどの業務システムでは知識は更新されるものであり、出典を示す能力は信頼性の基盤です。
#AIエージェント# #ソフトウェアアーキテクチャ#
もっと見る
# AIエージェントをエンタープライズシステムに組み込む意思決定ポイント
# プロンプト変更の統制|Prompt Change Control
🎯 ポイント
プロンプトは「ちょっとした言い回しの変更」に見えて、実はシステムの振る舞いを根本から変える「設定変更」です。コードのデプロイにはCI/CDとレビューがあるのに、プロンプトの変更は誰がいつ何を変えたか追えない——そんな状態で本番運用していませんか?プロンプト変更の統制は、すべてを同じ厳格さで管理するのではなく、本番影響度に応じてレベルを分けるのが現実解です🔑
📋 概要
プロンプト変更の統制は、エージェントのシステムプロンプトやツール定義の変更に対して、どの程度の承認・テスト・バージョン管理を求めるかを制御するダイヤルです。厳格にすれば再現性と安全性が上がりますが、開発速度が落ちます。緩めれば迅速な改善・実験が可能ですが、意図しない変更が本番に入るリスクが上がります。このダイヤルの要点は、プロンプトの構成要素ごとにリスクが異なるため、統制レベルも分けるべきだということです。システムプロンプトのロール定義とFew-shot例示では、求められる統制が全く違います📋
🔍 意思決定のポイント
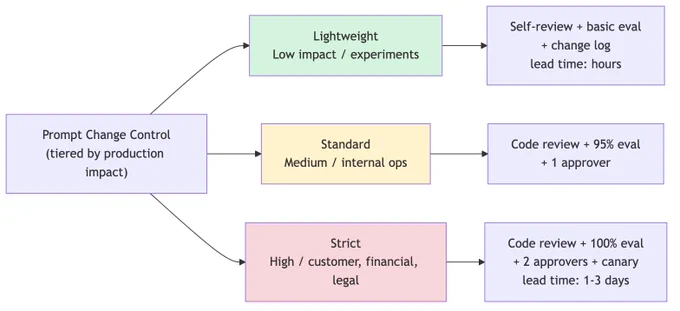
このダイヤルは「本番影響度」で3段階に分岐します。
高影響(顧客向け・金銭・法的)→ 厳格:コードレビュー+eval 100%通過+承認者2名+カナリアデプロイ
中影響(社内業務・広範囲)→ 標準:コードレビュー+eval 95%通過+承認者1名
低影響(内部実験・限定公開)→ 軽量:セルフレビュー+基本eval通過+変更ログ記録
さらにプロンプトの構成要素ごとに統制方針を分けます:
システムプロンプト(ロール・制約)→ 変更頻度は低いがリスクは高い。厳格に管理し設計判断として扱う
ツール定義(名前・説明・スキーマ)→ ツール選択精度に直結するため厳格に
Few-shot例示 → 中程度のリスク。evalで品質を確認する標準統制
コンテキスト注入テンプレート → 変更頻度が高くリスクは低〜中。軽量〜標準で対応
出力フォーマット指示 → リスクは低いが下流システムとの整合確認は必要⚡
💡 要点と詳細
統制の構成要素は5つです:
バージョン管理 — プロンプトをGitでコードと同様に管理します。差分の可視化と履歴の追跡が可能になります。「誰がいつ何を変えたか」が追跡できないと、将来の判断が困難になります。変更理由を必ず記録してください。
evalゲート — 変更後のプロンプトが既存のevalセットを通過することをデプロイの前提条件にします。evalの回帰検出率(プロンプト変更による品質低下を事前に検出できた割合)を計測し、検出できなかったケースはevalに追加して強化します。
承認プロセス — 影響度に応じた承認者のレビューです。厳格レベルでは同僚エンジニア+テックリードの2名。返金上限額など金銭に関わる記述変更は法務レビューも追加します。
カナリアデプロイ — 一部のトラフィック(目安10%)にのみ新プロンプトを適用し、24時間の品質指標を比較した上で全体展開します。A/Bテストの仕組みと共通化できます。
ロールバック手順 — 問題発生時に即座に前バージョンに戻せる仕組みです。Gitのリバートとデプロイパイプラインの連携が基本です🔬
計測すべき指標は5つ:プロンプト変更の頻度(環境ごと)、変更からデプロイまでのリードタイム(厳格レベルは1〜3営業日、軽量レベルは数時間以内が目標)、プロンプト変更起因の障害件数、evalの回帰検出率、ロールバック発生率です📈
⚖️ トレードオフ
開発速度優先(緩め)にすると、プロンプトの迅速な改善・実験が可能になりA/Bテストのサイクルが速まります。しかし「誰がいつ何を変えたか」が追跡できず、障害時に原因究明が困難になります。意図しない変更が本番に入り、品質低下やセキュリティ問題を引き起こすリスクがあります。特にシステムプロンプトのロール定義が知らないうちに変わっていた場合、影響範囲は全回答に及びます😰
再現性・安全優先(厳格)にすると、全変更が追跡可能で障害時の原因特定が容易になります。しかし変更の承認プロセスがボトルネックになり、改善のリードタイムが長くなります。小さな改善でも重い手続きが必要だとチームのモチベーションが下がり、「プロンプトを直したいけど面倒だからそのまま」という本末転倒な状態を生みます⚠️
対策は明確です:統制レベル自体を安易に下げるのではなく、evalの自動化・承認プロセスの並列化で変更リードタイムを短縮すること。そして実験環境と本番環境の統制レベルを明確に分け、実験の速度を本番の安全性と引き換えにしないことです。
🛠️ ユースケース
Zendesk顧客対応エージェント:システムプロンプトの変更はPM+エンジニアリードの承認必須。返金上限額の記述変更は法務レビューも追加。eval通過+カナリア(10%トラフィック×24時間)を経て全体展開。変更リードタイムは1〜3営業日です📞
Slack社内実験ボット:開発者がセルフレビューで変更可能。基本evalの通過は必須だが承認プロセスは省略。変更ログは自動記録され、問題発生時の原因追跡に使います。変更リードタイムは数時間以内です💬
Salesforce営業支援エージェント:ツール定義の追加・変更はコードレビュー必須。商談ステージの判定ロジックに影響するプロンプト変更はテックリードの承認が必要。大規模なプロンプト変更は段階的に実施し、影響範囲を限定します🎯
実践のコツ:初期は厳格寄りで運用を開始し、チームの習熟とevalの充実に応じて段階的に緩和してください。プロンプト変更起因の障害が発生したら、そのケースをevalに追加して再発防止を自動化する。そして大規模なプロンプト変更(ロール定義の書き換え等)は一度に行わず段階的に実施すること。一度に大きく変えると影響範囲の特定が困難になります💪
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る
AIエージェントをエンタープライズシステムに組み込むプラクティス
【シングル vs マルチエージェント】
💡 「全部入りの万能エージェント」を作ろうとしていませんか? その判断こそが、システムの成否を分ける最初の分岐点です。
🔥 解決する課題
- 単一エージェントではツール数や文脈窓の制約で複雑タスクに対応できない
- ドメインごとに異なる知識・権限・モデルを使い分けられない
- 独立タスクを直列処理して応答時間が肥大化する
- マルチ構成での副作用の競合リスクが制御不能になる
🏗️ 提案パターン
シングルエージェントは1つのLLMループが全ツールを持ち逐次処理します。ツール30個以下・単一目的・低レイテンシ要求なら最適解です。一方マルチエージェントはオーケストレータが専門ワーカーに委譲し、並列調査で時短を実現します。重要なのは「書き込みは1エージェントに集約し、他は読み取り専用」という副作用集約の原則です。コスト・レイテンシはマルチの場合シングルの数倍になる点を忘れずに。
✅ 選定条件
- 向き(シングル):単一目的、ツール少数、コスト敏感、デバッグ容易性重視
- 向き(マルチ):専門領域が分離可能、並列調査で時短、文脈窓が単一で破綻
- 不向き:副作用が多く競合リスクが高い処理をマルチで行うこと
⚠️ 落とし穴
- 「とりあえずマルチ」は複雑性・コスト・デバッグ難度を一気に上げる
- マルチ構成で複数エージェントが書き込むと競合・不整合が頻発する
- シングルで始めて、本当に破綻してからマルチに移行するのが安全
🛠️ 実装方針
1. まずシングルエージェントで構築し、ツール数・文脈窓・レイテンシの限界を実測します
2. マルチ化する場合はLangGraphやCrewAIでオーケストレータ/ワーカー構成を採用し、ワーカー間の通信は共有状態ストア(Redis等)で行います
3. 副作用の集約ルールとして「書き込みは1エージェントのみ、他は読み取り専用」をコード規約で強制します
4. A2A(Agent-to-Agent)プロトコルでエージェント間のインターフェースを標準化し、ワーカーの追加・入替を容易にします
5. シングル→マルチの移行判断基準(ツール数30超、文脈窓使用率80%超等)をダッシュボードで可視化します
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る

AIは、セキュリティエンジニアの仕事を奪うのか、実務を拡張するのか。本セミナーでは、セキュア開発、設計評価、ペネトレーションテストの各領域で、AI活用の現実解を解説します!
実際に使って見えた有効性と限界。セキュリティ技術者が考えるべきポイントをお伝えします。
もっと見る
