搜索结果 視覚推論
視覚推論 贴吧
一个关键词就是一个贴吧,路径全站唯一。
用户
未找到
包含 視覚推論 的推特

再過幾年,每一台電腦、每一台機器人,都可能是一座微型 Data Center。
傳聞 Apple 正在開發的 M7 Ultra,最高可支援 1.5TB 統一記憶體。雖然規格與上市時間尚未確認,但趨勢已經很明顯:
本地端機器只會越來越強,模型則會透過量化、蒸餾與稀疏化,變得越來越小、越來越有效率。
今天需要 Data Center 才能運行的模型,幾年後可能一台 Mac Studio、AI PC,甚至機器人就能跑。
未來大型 Data Center 仍會負責訓練 Frontier Model;但日常的 AI Agent、影像生成、資料分析與機器人決策,會有越來越多直接在本地完成。
尤其當機器人大量普及後,每台機器人都需要強大的晶片處理視覺、語音與動作,但它們不會 24 小時工作。
在充電或待機時,這些閒置算力就可以被釋放出來,處理批次推論、模型評測、影片生成等可拆分的任務,再替主人賺取收入。
當然,一萬台分散式電腦不等於一座萬卡 GPU Cluster,它們不適合共同訓練同一個超大型模型,卻可以同時完成一萬個不同的推論任務。
所以 Data Center 不會消失,但算力也不會永遠只集中在 Data Center。
上一個時代,是每個家庭都能上網。
下一個時代,可能是每個家庭都能提供算力,讓電腦與機器人在閒置時,繼續替你工作、創造被動收入。
显示更多


在長假結束前把《控制:共振》通關了,遊戲時間大概 30 個小時左右,包括主線和部分支線,從遊戲長度來說份量還是足足的。
因為核心玩法的改變(從射擊到近戰),加上遊戲場景從室內轉移到室外,除了故事、角色和世界觀上的繼承,和前作相比完全是兩個遊戲,對於一款續作來說還挺難得的。
遊戲的關卡設計和藝術風格可以說是長板中的長板。關卡方面隨著遊戲進程的推進,可以說是一關比一關精彩,尤其到最後階段的未知領域,錯綜凌亂但複雜有序的設計相當令人驚艷。搭配上遊戲標誌性的飽和色和高對比視覺藝術風格,在當下行業里絕對是滿分的水平。
戰鬥方面的成長路線我覺得還有一定商榷空間。一方面是主角技能成長在前期的爬坡階段過於緩長,以至於在相當一段時間里不得不一路平 A 過去,玩得有些吃力。另一方面是雜兵戰的設計,總兵搭配小兵的邏輯和套路能理解,但早期主角技能不足尤其是缺乏遠程技能的情況下,常常被使用遠程的雜兵給屈死,令人相當惱火。當然以上兩個情況在進入中後期,待主角成長起來後,就不是問題了,前提是你不會在前期因為熬不住而流失。
遊戲中的各種細節絕對滿足各種強迫症,無論是 NPC 的對話,還是四處散落的筆記日記錄音帶等信息,或是主線與支線里的對話與劇情,都安排得妥妥當當,有一種別樣的精緻感。
總體來說,《控制:共振》和 Remedy 其他幾款遊戲一樣,屬於長板極長,個性極為鮮明,初見可能很難愛上,而一旦進入心流就會愛不釋手的那種類型。我甚至願意稱這幫人為一群奇才,在愈發趨於保守的一眾 3A 遊戲大作里,敢於做出自我突破的遊戲藝術家。
#ControlResonant# #RemedyEntertainment#
显示更多

影片中可以看到,系統先用普通 CCTV 畫面標出顧客位置,接著切換成 3D 點雲地圖,用彩色粒子顯示人流,再用藍到紅的熱圖標出「大家視線停留最久的貨架位置」。簡單來說,它不只知道你站在哪,還能估計你的頭朝哪邊看,把注意力對應到特定商品。
🌵 這套技術到底怎麼運作?
Auki 的做法是先用手機快速掃描店面,建立「數位孿生」(digital twin),再把現有監視器畫面接到同一個空間地圖裡。系統會做姿態估計(pose estimation)和視線方向判斷,累積成「這個時段、這一天、這個月,哪些貨架被看最多」的熱圖,再和實際銷售數據對上。
官方強調這是匿名、彙總資料,不會建立個人檔案,也不會辨識你是誰,只是看「整體顧客視線落在哪」。他們說這能幫店家優化陳列:把熱門商品放到大家最常看的位置,或把容易被忽略的商品移到視線較少的角落,減少空檔。
目前已有瑞典 COOP、挪威便利商店、新加坡 FairPrice 等零售商在試用,還結合機器人做貨架盤點。
🔒 相關發展:零售業 AI 監控越來越普遍,但爭議也不少
這不是唯一一套「用攝影機分析顧客」的技術。近年零售業為了防盜,開始大量導入 AI 攝影機:
• 英國、澳洲的超市測試人臉辨識,比對「已知竊盜者」黑名單。
• 美國部分折扣超市用面部掃描抓小偷,被批評是「全民監視」。
• 有店家結合 AI 偵測「把商品塞進口袋」的行為,直接通知店員。
這些做法引發隱私疑慮,尤其在歐洲 GDPR 規範下,即使沒有記名,推論出的「注意力資料」也可能被視為個人資料。有專家指出,現有監視器只要軟體升級,就能從防盜變成行為分析,甚至未來可能結合動態定價。
Auki 這套比較特別的地方是它主打「陳列優化」而非「抓人」,而且強調用現有設備、不新增硬體。不過隨著這類空間 AI 越來越成熟,公共空間裡「被分析」的範圍確實在擴大。
未來走進超市,貨架擺設可能不再只靠經驗,而是靠「大家真正在看什麼」的數據來決定。這對店家來說是效率提升,對消費者來說則是「逛街體驗被量化」的開始。你覺得這種技術是進步,還是有點讓人毛毛的? 🤔
显示更多

有沒有發現,AI 越來越強,長相卻越來越像寵物?👀
Meta 的 Muse 配上一隻毛茸茸、臉頰紅紅的吉祥物。背後是越來越強大的 AI,呈現在你面前的,卻是一個看起來需要被照顧的小傢伙。(
我覺得這個設計方向很值得研究,尤其是正在做 AI 產品的人。
⚡️ 其實,100 年前電力公司就做過類似的事。
1926 年,美國 Alabama Power 推出 Reddy Kilowatt,把看不見、摸不得的電,畫成一個有笑臉的卡通角色,用更親切的形象鼓勵大家使用電力。(
🧠 心理學裡有個概念叫「嬰兒圖式」。
大眼睛、圓臉、小鼻子這些特徵,容易讓人覺得可愛,產生照顧的意願。這有實驗研究支持,但不能直接推論成「可愛的 AI 就一定更值得信任」。(
放到 AI Agent 身上,我的理解是:可愛的外型,可能讓人更願意靠近、嘗試,甚至把事情交給它處理。
以前用聊天機器人,你問一句,它回答一句。
接下來的 Agent,則可能需要讀你的信件、看你的行程、操作你的電腦。產品要跨過的門檻,也變成了:「你願意讓它參與多少生活?」
🐣 想像同樣一句「讓我幫你處理」,從一個冰冷的系統視窗,換成一隻會眨眼的小寵物,感受就差很多。
所以我認為,接下來 AI 的競爭,除了能力、速度、價格,也會越來越重視個性、外型,以及相處起來的感覺。
只是,可愛能讓人願意開始使用;要讓人長期放心,還是得靠每一次把事情做好,以及知道什麼時候該先問你。
显示更多


15个值得关注的AI账号:
1. @karpathy
他的推文创造的LLM叙事,你两个月后会在LinkedIn上看到。
2. @fchollet
发布关于智能、基准和AI局限的深思熟虑研究。Keras创始人+ARC-AGI。
3. @ylecun
深度学习先驱、Meta首席AI科学家;大局观研究和评论(还有drama)。
4. @AndrewYNg
AI教育传奇;实用ML建议、课程和真实应用。
5. @rasbt
发布实用ML/LLM实现、'从零开始构建'教程和书籍。
6. @dair_ai
每周ML/AI论文线程和易懂的研究解读(高质量信息流)。
7. @lilianweng
前OpenAI员工,Lil'Log风格线程优质。深度LLM研究分解。
8. @jeremyphoward
发布有趣的AI/加密新闻观点,致力于民主化实用深度学习教育。
9. @simonw
实用LLM工具、观点、实验、提示词和工程分解。Django联合创始人。
10. @_akhaliq
精选最新arXiv论文、模型发布和开源AI项目。
11. @ID_AA_Carmack
AGI/低级优化观点,让你重新思考问题。
12. @gwern
高质量长篇AI研究笔记和论文。
13. @goodside
LLM评估、提示词研究和真实能力测试。
14. @drfeifei
计算机视觉先驱;以人为中心的AI和空间智能研究。
15. @demishassabis
跟踪他的工作9年了。Demis是我对抗谷歌用AI滥用权力的希望。DeepMind CEO。
告诉我遗漏了谁,保存以备未来参考
显示更多


想建立高质量的AI信息流,从这15个账号开始!
这 15 个账号基本覆盖了:
研究 工程 教育 开源 产品 AGI 思考 AI 真实能力评测
@karpathy
他的推文经常提前定义 LLM 叙事。很多你两个月后在 LinkedIn 上看到的 AI 话题,可能他早就讲过了。
@fchollet
Keras 作者,ARC-AGI 提出者。经常分享关于智能、本质能力、Benchmark 和 AI 局限性的深度思考。
@ylecun
深度学习先驱,Meta 首席 AI 科学家。观点很宏观,也经常有对 AI 研究路线的批判和讨论。
@AndrewYNg
AI 教育领域的传奇人物。内容非常实用,覆盖机器学习建议、课程、产品落地和真实世界应用。
@rasbt
Sebastian Raschka,经常分享实用 ML / LLM 实现、“从零构建”教程,以及相关书籍内容。
@dair_ai
高频更新 ML / AI 论文线程,用通俗方式拆解前沿研究,适合快速跟进 AI 进展。
@lilianweng
前 OpenAI 成员。她的 Lil’Log 风格内容非常值得看,擅长深入拆解 LLM 研究和技术细节。
@jeremyphoward
经常分享 AI / Crypto 相关观点,也长期推动实用深度学习的普及和大众教育。
@simonw
Django 联合创始人。聚焦实用 LLM 工具、实验、提示词、Agent 和工程实践拆解。
@_akhaliq
持续整理最新 arXiv 论文、模型发布、开源 AI 项目和研究动态,信息流非常快。
@ID_AA_Carmack
关注 AGI 和底层优化问题,很多观点能让你重新思考“智能”和“工程”的本质。
@gwern
高质量长文作者,擅长 AI 研究笔记、深度 essays 和长期主义视角的技术观察。
@goodside
专注 LLM 评测、提示词研究和真实能力测试,经常能看到非常细的模型行为观察。
@drfeifei
计算机视觉先驱,关注以人为中心的 AI、空间智能和未来 AI 研究方向。
@demishassabis
Google DeepMind CEO。长期关注通用 AI 的未来方向,也是理解 DeepMind 路线的重要窗口。
大家还有要补的吗?评论区👇👇👇👇
显示更多


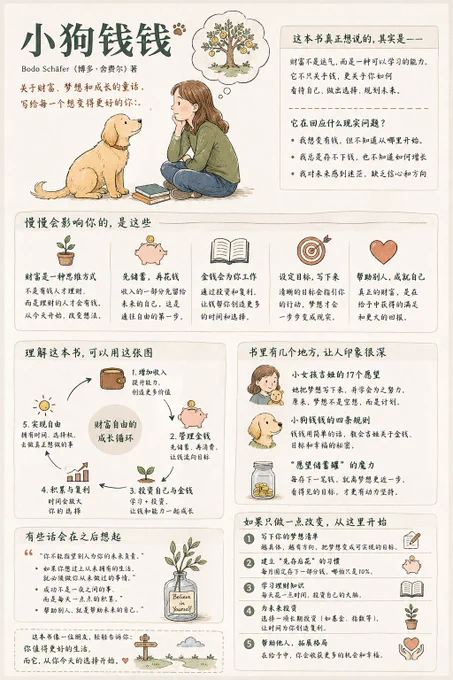
Image-2搞了一套书籍总结的图文笔记提示词,效果很稳定
提示词如下⬇️
生成一张【中等信息密度】书籍总结信息图海报,主题为《{书名}》。
⸻
🔶 Step 0(关键前置判断)
在开始生成之前,请先判断这本书更接近哪一类(可多选):
* 认知成长类(思维 / 自我提升)
* 商业 / 财富类(赚钱 / 职业 / 投资)
* 心理 / 情绪类(关系 / 内在 / 人性)
* 小说 / 故事类(叙事 / 人物 / 隐喻)
👉 然后根据类型,调整表达重点与结构侧重(不是改外观,是改内容逻辑):
类型内容侧重点
认知类模型 / 思维方式 / 误区
商业类杠杆 / 决策 / 方法
心理类情绪机制 / 人性 / 关系
小说类人物 / 冲突 / 隐喻 /主题
⸻
🎨【整体风格】
现代极简UI + 轻复古插画风
柔和浅色背景(奶油 / 米色 / 浅灰)
低饱和配色(深绿 / 深蓝 / 棕色)
👉 气质关键词:
* 安静
* 有内容
* 可以慢慢读
⸻
🧩【核心原则(非常重要)】
❗不要使用固定模块标题
❗不要强行凑“结构完整”
请根据书的类型与内容,自然组织信息:
👉 可以:
* 合并 / 删除模块
* 调整顺序
* 改写所有小标题
* 强化某一部分(例如小说就弱化“方法论”)
👉 目标:
更像“一个读懂的人在讲”,而不是“整理笔记”
⸻
🟡【内容模块(按“信息类型”动态组合)】
以下不是模板,而是素材池👇
👉 请按书籍类型自由选择 + 重组
⸻
① 开场(一定要有)
* 书名(视觉中心)
* 作者
* 一句话洞察(必须像人话)
👉 根据类型调整语气:
* 认知类 👉 “你以为是A,其实是B”
* 商业类 👉 “问题不在努力,而在杠杆”
* 心理类 👉 “很多痛苦,其实来自…”
* 小说类 👉 “这是一个关于……的故事”
👉 插图要有“隐喻意义”
⸻
② 把这本书讲清楚(核心理解)
不要写“核心思想”,可以这样表达:
* “这本书真正想说的,其实是…”
* “如果只讲一件事,那就是…”
内容包含:
* 核心观点(Core Thesis)
* 它在回应什么现实问题(Problem)
👉 根据类型变化:
* 小说 👉 可以写“故事的底层主题”
* 心理 👉 强调“为什么人会这样”
⸻
③ 最值得带走的东西(重点区)
标题风格要自然,例如:
* “读完之后,很难不改变的几个点”
* “慢慢会影响你的,是这些”
根据类型调整内容👇
⸻
👉 认知类(偏模型)
* 思维误区
* 认知升级点
* 决策方式
👉 商业类(偏行动)
* 杠杆
* 赚钱逻辑
* 策略选择
👉 心理类(偏感受)
* 情绪机制
* 关系洞察
* 内在模式
👉 小说类(偏理解)
* 人物选择
* 冲突
* 象征意义
⸻
每个要点:
* 一个短句观点(必须像人说话)
* 1–2句解释
* 小图标
⸻
④ 一个“关键结构”(视觉核心)
标题自然表达,例如:
* “所有内容,其实围绕这个结构”
* “理解这本书,可以用这张图”
根据类型自动变化👇
类型推荐结构
认知思维模型 / 决策路径
商业杠杆系统 / 赚钱闭环
心理情绪循环 / 行为模式
小说人物关系 / 冲突结构 / 命运轨迹
⸻
⑤ 书里的例子 / 片段(更像讲故事)
标题可以是:
* “书里有几个地方,让人印象很深”
* “这些片段,其实说明了什么”
根据类型变化👇
* 商业 / 认知 👉 案例
* 心理 👉 场景 / 情绪
* 小说 👉 剧情片段
每条:
* 一句话 + 图标
* 要有画面感
⸻
⑥ 一些会留下来的句子(金句区)
标题风格:
* “有些话会在之后想起”
* “值得慢慢读的几句话”
👉 留白感要强(视觉重点)
⸻
⑦ 可以带走的改变(行动区)
标题:
* “如果只做一点改变”
* “你可以从这里开始”
根据类型调整👇
类型行动方式
认知思考方式改变
商业具体行动
心理觉察 / 关系改变
小说人生感悟(轻行动)
要求:
* 3–5 条
* 必须具体 / 可执行 / 可感知
⸻
🎯【设计细节】
* 自适应网格布局(不要死板对称)
* 卡片化信息(留白优先)
* 图文比例约 6:4
* 插图统一风格(手绘 / 线性)
* 层级清晰(重要信息更大)
⸻
✍️【语言风格(决定质量)】
✅ 要:
* 像人讲书
* 有理解、有筛选
* 有一点“顿悟感”
❌ 不要:
* “本书讲了…”
* “定义是…”
* 空话 / 套话 / 过度总结
⸻
📦【输出要求】
* 中文(可少量英文点缀)
* 信息密度中等
* 适合社交媒体传播(小红书 / 推特 / 海报)
⸻
显示更多



一天迁移 5000 万行 Ruby 代码,抵一个团队两个多月。这是 Anthropic 新旗舰 Claude Fable 5 干的。又慢又贵,但能啃硬骨头。它从今天起免费 13 天(6/10–6/22)。下面这些看完再上手,别浪费窗口。
1/ 它是什么:Fable 5 就是 Mythos 5 加了一道更严的安全护栏,底层性能一样。100 万 token 上下文,单次输出 128K,知识截止 2026 年 1 月,模型串 claude-fable-5。现在对所有人开放的最强公开旗舰,不过还是 preview。
2/ 跑分:SWE-Bench Pro 80.3%。Opus 4.8 才 69.2%,GPT 5.5 是 58.6%,Gemini 3.1 Pro 54.2%。三篇实测都印证同一条规律:任务越长越复杂,它领先越多。主场是大活,不是改一行代码。
3/ 真实战绩,是生产不是 demo。Stripe 一天跑完 5000 万行全库迁移。Datasette Agent 做完既定目标,还顺手发现并修掉了底层 LLM 库的 4 个 bug。@Mnilax 揪出 Opus 数月没看见的 bug,某钱包解析器 9 个,另一项目 4 个。都是得把整个文件握在工作记忆里才看得见的那种。
4/ 视觉这块被低估了。它能只凭截图重建一个 Web 应用的源码。能用纯像素 harness 从头通关《宝可梦 火红》,没有地图,也没有状态解析。《杀戮尖塔》记忆实验里比 Opus 4.8 多进步 3 倍。截图转代码、图表转数字,这部分值回票价。
5/ 价格:输入 $10、输出 $50 每百万 token,正好是 Opus 的 2 倍。Simon 实测一天烧了 $110.42,其中 89.9% 砸在一个 Agent 项目上。重活吃掉绝大部分预算,这才是它该干的事。喂它琐事,只会烧光额度还零结果。
6/ 用法变了,这条最重要。旧的「逐个喂小活、全程握方向盘」会把它锚在过时模式上。官方四条建议:直接交超出旧模型边界的大活;effort 默认拉 xhigh 或 high;重写旧 skill 和 CLAUDE.md;从「派任务」转向「给目标」,说清楚完成长什么样、怎么验证。
7/ 核心方法论:别再逐字 prompt,给它两类循环。一句话配方是「给模型一个评估指标,让它爬坡」。一类是自纠错内循环,给 rubric,让它跑、收反馈、自我修正。一类是跨 session 记忆外循环,让它自己管上下文。Claude Code 里对应 /goal,CMA 的 Outcomes 会自动 spawn 一个 grader 子智能体打分。
8/ 一个反直觉的点:别让模型自评自己的输出,效果差。换成独立上下文窗口里的 verifier 子智能体来打分。
9/ 记忆的五步:fail 记录错误,investigate 搞清原因,verify 变成已验证事实,distill 提炼规则,consult 直接查规则而不是重推。三代模型恰好卡在不同台阶。Sonnet 4.6 停在第 1 步。Opus 4.7 停在第 3 步,验证覆盖率中位只有 17% 左右。Fable 5 走完全程,最强一次到 73%。
10/ 最硬的一个数:Parameter Golf 挑战里,Fable 5 对训练 pipeline 的改进大约是 Opus 4.7 的 6 倍。行为差异也值得说。它敢押注结构性大改,扛过一次量化回退,最后冲到最大收益,作者说它像敢走高方差路径的研究者。Opus 4.7 拿到首胜后就只重复低方差的老套路。
11/ 一定要懂的护栏机制,叫静默回退。命中网络安全、生物化学、蒸馏这三类,请求会被悄悄回退给较弱的 Opus 4.8。大约 5% 触发,95% 以上的会话从不碰到。API 新增了「命中护栏」通知,把它当路由信息看就行:被标记的活,其实是 Opus 在答。也要留意误报,某个 benchmark 70% 的提示被 flag,Rust 里的 unsafe {}、公开生物数据都可能误触。
12/ 该用还是别用。该用:跨文件重构、全库迁移、长上下文审计、截图重建源码,以及需要跨 session 记忆复利的连续任务。配置上 effort 拉 xhigh,开持久记忆,给它目标加 rubric 让它自驱。别用:改一行、总结邮件这种短确定性活,Opus 或 Sonnet 更便宜;上面三类被标记的活;还有对延迟和成本敏感的交互场景。
13/ 现在就做一件事:13 天里,把你最值钱、最高 effort、一直不敢交出去的大活先排进来。再送你一条能直接套的审代码 prompt:「以从未见过这套代码的资深工程师视角审查整库,别加功能别为品味重构,只找真正的错误:竞态、吞掉的异常、掩盖失败的类型强转、死配置、只在 happy path 成立的假设。每条给出文件行号、原因、影响范围和最小安全修复。」
你打算拿这 13 天先啃哪块硬活?
显示更多


