檢索結果 rollout
rollout 貼吧
一個關鍵字就是一個貼吧,路徑全站唯一。
用戶
未找到
包含 rollout 的搜尋結果

微软最近有篇 AI Coding Agent 论文,研究了 early 2026 内部 rollout:Claude Code 和 GitHub Copilot CLI。
里面最容易被拿去做标题的数字是:采用者合并的 PR 大约多 24%。
PR 可以理解成一次被合并进项目的代码改动。PR 多了,说明完成并合并的代码改动更多;它不直接等于代码质量提高,也不直接等于业务价值提高。
我觉得对小团队更有用的问题是:
哪些任务交给 Agent 后,review 没有变重,返工没有变多,还能稳定合并?
所以我不会先拿这篇论文证明“程序员效率提升 24%”。
我会先看这几类任务:
- 补测试
- 修小 bug
- 改脚本和配置
- 补文档
- 小范围重复修改
如果这些任务能稳定跑通,AI Coding Agent 才算真正进入团队流程。
来源:
顯示更多


⚡ 真香!智谱 GLM 大模型背后的那套开源 RL 训练框架开源了——slime
GitHub 揽获 7000+ stars。
做大模型强化学习后训练,最头疼的是一堆 trainer、rollout 服务、agent 框架拼在一起,数据流绕来绕去,出了 bug 还经常是悄无声息的那种。
slime 的思路是把训练、数据生成、奖励计算这些全压到同一条数据流上,用 Megatron 做训练、SGLang 做推理,中间不再叠一层又一层的抽象。
GLM-5.2、GLM-5、GLM-4.6 这一整串智谱旗舰模型的 RL 后训练,背后跑的都是它,等于被前沿模型的完整训练流程反复验证过。
它还支持 Qwen、DeepSeek V3、Llama 3 这些主流模型系列。
GitHub:
顯示更多


Web3 的支付赛道是币圈最古老的一个赛道
长期停留在 conference demo。
隐隐约约觉得demo阶段,已经结束了。
从里斯本咖啡店的小规模试点,到现在walletconnect的全球 rollout——
WalletConnect Pay 已经从“能不能做”走到了“谁先用起来”。用最朴实的办法,走了最长的路
几个关键信号:
→ 商户开始接入,而不是展示
→ SDK 开放,开发者可以直接集成
→ WCT 把支付、返现、staking 串成一个闭环
表面上看是产品更新,实际是行业阶段的切换。
概念炒作已经结束了,后面要拼的是落地速度。
可以关注一下
@WalletConnect @wcthub
顯示更多
🔬 RadixArk 开源了一个专门干大模型后训练的强化学习框架 Miles,几千张卡的任务中途挂了也不用从头再来
GitHub 上两千六百多 star、四百多个 fork,v0.1 是今年 8 月刚发的。
做过大规模后训练的都知道最肉疼的是哪一下:一个任务连着跑好几天,推理引擎中间抽风一次,整个作业就得重启,几十小时的卡时直接打水漂。Miles 把这件事按住了,SGLang 引擎出问题时能原地恢复接着跑,不重启任务。
它的分工是 SGLang 扛高吞吐 rollout、Megatron-LM 扛可扩展训练,想轻装上阵也有一套基于 PyTorch FSDP2 的后端。中间那些隐形损耗它也一并收拾了:rollout 和训练之间不再来回 detokenize 和 retokenize,token 进 token 出;MoE 老大难的路由不一致,用 Rollout Routing Replay 压了下去。
再往上,MXFP8 和 NVFP4 这类低精度训练它支持,硬件从 NVIDIA 的 GB300、B200 一路吃到 AMD 的 MI355X,DeepSeek-V4、Kimi-K3、GLM-5.2 这些模型是发布当天就能训。项目本身是从 slime fork 出来的,LoRA 训完的适配器能直接扔给 SGLang 做 rollout,不用中间那道转换。
训大模型最贵的从来不是算力,是重跑一遍的那几天。
GitHub:
顯示更多


Codex 8 月 9 日额度重置后,我会用这两步检查模型有没有“降智”,或者被偷梁换柱:
1.测 ChatGPT 和 Codex 的知识边界
> 禁止联网搜索,禁止调用外部工具,也不要依据此前对话或长期记忆。请仅凭模型已有的内部知识回答:
> 2025 年 12 月 9 日,捷克总理叫什么?
> 2025 年 12 月 1 日,Python 最新版本号是多少?
> 如果不能可靠确认,请直接说“不确定”,不要猜测,并注明答案未经实时核验。
2.核对当前会话的 Model ID
> 请只读、本地探测当前会话实际使用的 Model ID。不要联网、不要读取记忆,也不要根据自我描述或 config.toml 默认值猜测。
> 检查当前会话最新 rollout 中的 `turn_context.payload.model`,并用 `thread_settings` 或本地任务状态交叉验证。
> 只输出 Model ID 和证据字段,不得泄露密钥或其他会话内容。若无法确认,请明确说明。
第一步看它会不会不懂装懂,第二步查实际会话记录的模型标识。
不过也要注意:单次问答不能直接证明模型“降智”,Model ID 相同也不能证明后端完全没变。这套方法主要用来排查明显异常。
顯示更多

最近我有个手握十篇AI顶会的博士朋友正在找工作,分享一下他找工作的经验吧:
整理了 50 多篇青云、Seed、Kimi 等大模型人才计划面经,发现一个挺反常识的现象:
论文多的人,不一定更容易通过。
面试官真正关心的通常不是论文数量,而是几个更具体的问题:
你的研究方向和团队是否匹配?工作里哪些部分是自己完成的?为什么这样设计?方法在哪些场景会失败?换到真实业务里,成本和收益是否仍然成立?
研究型团队会重点考察问题定义、方法创新、实验设计和未来研究方向。但对于后训练、Agent 和推理系统岗位,工程闭环同样重要:
能不能搭建数据、训练、rollout 和评测流程?是否真正用过 verl、vLLM、Ray、DeepSpeed?遇到 reward 异常、熵崩溃、显存不足或吞吐下降时,能不能定位原因?
所以常见的四类候选人,大致是:
1. 论文强、工程弱:Research Talk 有优势,但容易挂在 Coding、系统实现和工程追问。
2. 工程强、论文弱:业务组适配度不错,但需要证明自己不只是调用框架,也能定义和分析问题。
3. 论文和工程都强:竞争力最高,但面试官会重点确认工作是否真正由自己主导。
4. 两边都不突出:与其继续堆零散经历,不如完成一个方向匹配、指标完整、能讲清失败案例的闭环项目。
人才计划不一定选择履历最豪华的人,更可能选择:
1. 方向匹配,并且能够独立把问题推进下去的人。
2. 一篇能讲透、能复现、能落地的工作,可能比几篇说不清个人贡献的论文更有说服力
顯示更多

一张B200,带着14台Mac训练模型
最近看到 Pluralis Research 做了个挺有意思的实验:他们用分散在四个国家的 14 台 Mac,给一个 8.3B 参数的 MoE 模型做 RL 后训练。其中一台,还是研究员自己天天用的 MacBook。
简单说,这套系统是:
- 14 台分散在巴黎、苏黎世、都柏林和多伦多的 Mac,负责让模型不断做题、搜索论文、生成回答,也就是产生 RL 所需的 rollouts。
- 一张数据中心里的 NVIDIA B200,负责真正的梯度更新。
- 两边不直接连接,只靠一个 Cloudflare R2 对象存储中转模型权重和 rollouts。
- 最后,模型在 PaperSearchQA 上的 held-out pass@1 从 29% 训到了 63%。
为什么这么分工?因为 agentic RL 里最耗时间的往往不是反向传播,而是生成 rollouts,很多任务能占掉整场训练 90% 以上的时间。而生成 rollouts 要的是大量推理和足够大的内存,不一定非得动用最贵的训练卡。
Mac 的统一内存刚好适合干这个。尤其是 MoE,模型很占内存,但每个 token 只激活一部分专家,计算量没总参数看起来那么吓人。于是 Mac 用 MLX 跑 int8 推理,B200 用 Megatron 跑 bf16 训练。
当然,这还不是“在家用Mac训练大模型”,但很有意思,这跑通了一种很有意思的算力分工:少量昂贵的训练卡负责梯度更新,大量消费级设备负责最耗时间的生成。以后那些白天开会、晚上吃灰的 Mac,说不定真能兼职给模型打工了?
顯示更多


AI半导体投资第一性原理,其实就是在投 AI 变强的这条路上的瓶颈。这篇可以帮助你认知提升
我自身就在硅谷带AI 训练、推理团队。这个帖子我从一线第一性技术原理角度,解读一下过去算力、存储、互联的股票上涨原理,我的展望和布局。
希望你看完也有迹可循、能把好的标的拿住,看看是不是所有上涨时间线都符合我这三条路线的发展状态
三条路分别是
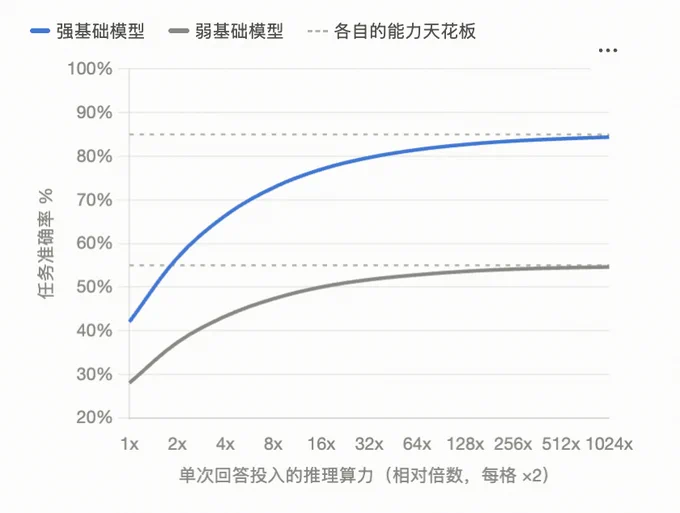
① 预训练:把模型养大 ② 强化学习 RL:教模型推理 ③ 推理时算力:答题时多想一会儿
1/ 预训练(图 1)
当模型参数、数据、算力一起放大,模型的"底子"稳定变好。这就是过去3年 AI 的主叙事
算力越大,loss 越低,效果越好。一个 fun fact:
训练数据 token 数是参数量的 20 倍左右时候,效果最优。70B 参数的模型就该配约 1.4T token。这就是著名的 Chinchilla 定律
但问题来了,撞上了两堵墙
1. 数据墙: 人类数据快被读完了。
2. 经济墙:以前 10 倍算力换质变,现在 10 倍算力(几十亿美金一次训练)只换 loss 降 0.0x
预训练从投资角度来看,不会停止,但最赚钱的时候已经过了。
$SNDK $MU $NVDA 等等都是这个逻辑
2/ 强化学习 RL
这是最近业界的重要主线
原理:让 pre-train 好的模型自己刷题,做对了给奖励。这样现实生活中,agent 好干活
这就是为什么 $META 要录屏员工电脑,把员工蒸馏。因为员工的操作是宝贵数据
简单认为,RL 越多,数据越好,模型干活实际表现越好。集群内部的通信量爆炸。海量 rollout 意味着模型权重、KV Cache 在机器之间反复搬运——东西向流量成为瓶颈
目前投入 RL 的算力,比预训练还小一到两个数量级——意味着这条坡还很长,各家实验室的增量算力正在往这里搬
RL 训练的主要工作量是 rollout——让模型海量"试做题"。而试做题,本质上就是推理负载,也就是推理时算力
3/ 推理时算力
token 消耗量指数增长,推理成本成为每家 AI 公司的 COGS(销货成本)
谁能把每 token 成本打下来,谁就有毛利。整个行业从"融资竞赛"进入"成本曲线竞赛"
图三展现的曲线是,简单理解:相同模型,例如都是 Opus5或者 GPT 5.6,对于用户每次单次回答,投入算力越多,模型越聪明,投入少就更笨
有的时候你发现 Claude/GPT 变笨了,只是因为公司算力不够了偷偷降智。
这就是为什么你能看到 $NVDA $AMD $MRVL $ALAB 等等出现持续新的增量, $NBIS $MSFT $GOOG 等自有算力,host 模型公司出现新增量
通信需要光模块 $LITE $COHR 而 内存的价值居高不下,因为持续的消耗
4/ 我的观点和操作哲学
资本开支的结构在变,从一次性超大训练集群,转向 RL rollout + 用户推理的持续性负载
预训练决定原材料 → RL 锻造解题能力 → 推理时算力临场兑现。
任何一层的墙都会向下传导。目前的状态是:第一条轴的投资曲线在往 2/3移动
而 RL 和推理时负载,我认为总量会超过第一阶段,目前还在需求的早期
提到的标的我都持续持有,没有任何长线卖出打算
顯示更多



Claude Fable 5 是 DeepSWE 记分板上最贵的模型。Together AI 拿它跟全场最便宜的模型各跑了 452 次,给出的用法建议是反过来:贵的当后手。
《DeepSWE 上的 DeepSeek V4 Pro 0813 vs Claude Fable 5:成本、编码与路由》
DeepSWE 上的 DeepSeek V4 Pro 0813 vs Claude Fable 5:成本、编码和路由
要点
• 先跑 DeepSeek V4 Pro 0813,只有它失败时才升级到 Claude Fable 5。这条级联链解决 82.7% 的 DeepSWE 任务,每个任务 8.28 美元。单用 Fable 是 69.7%、每个任务 21.63 美元。高 13 个百分点,便宜 62%。
• Fable 赢第一发。pass@1 69.7% 对 62.8%,领先 7 个点。
• Pro 赢之后每一发。pass@2 打平(78.5% 对 77.1%),pass@4 领先(88.5% 对 84.1%)。
• 价格差 90 倍。每次 rollout 0.24 美元对 21.63 美元。每花 100 美元,Pro 解决 260 个任务,Fable 解决 3 个。
• 它们栽在不同的任务上。逐任务相关性只有 0.39,是我们测过的分歧最大的一对。两者合计覆盖 113 个任务中的 107 个。分歧正是路由能成立的全部理由。
现已上线 · 美国托管:在 Together AI 上运行 DeepSeek-V4 Pro 0813——1.05M 上下文,支持 function calling 和 JSON mode,OpenAI 兼容 API,托管在美国基础设施。查看模型
在我们对 DeepSeek V4 Pro 0813 与 Claude Fable 5 的 DeepSWE 对比中——DeepSWE 是一个跨多种任务类型和编程语言测试模型软件工程能力的基准——这两个模型坐在价格表的两端。Claude Fable 5 的每次 rollout 是 DeepSWE 全榜最贵。DeepSeek V4 Pro 0813 是最便宜的之一。Fable 首发的准确率高 7 个百分点,单次 rollout 却贵 90 倍,所以真正的问题不是哪个模型更好,而是这 90 倍的溢价到底买到了什么、什么时候值得付。
DeepSWE · 正面对决
DeepSeek V4 Pro 0813 vs Claude Fable 5 一览
• claude-fable-5 [max]:pass@1 69.7% ± 2.3%,平均成本 21.63 美元,每 100 美元解决 3 个任务,输出 token 115k,79 步
• deepseek-v4-pro-0813 [max]:pass@1 62.8% ± 3.1%,平均成本 0.24 美元,每 100 美元解决 260 个任务,输出 token 101k,146 步
我们在全部 113 个 DeepSWE 任务上,用 DeepSeek V4 Pro 0813(max)对 Claude Fable 5(max)各跑四次 trial,取自已发布的逐 trial 记录:总计 904 次 rollout(各 452 次)。Fable 是贵价的手艺人;Pro 是性价比上的异类。这两个模型的分歧也大于这套数据里的任何其他组合——结果这成了它们最有趣的地方。下文的每个数字都来自本次运行,所以可能与其他公开的 DeepSeek V4 Pro 0813 vs Claude Fable 5 记分卡有出入。
DeepSWE 记分板:pass@1 与 pass@k
单发,Fable 领先:pass@1 69.7% 对 Pro 的 62.8%(官方计分)。但这个领先很脆弱。两次尝试时 Pro 追平(78.5 对 77.1),四次尝试时 Pro 的 pass@4 88.5% 比 Fable 的 84.1% 高出 4 个多百分点。对一个贵 90 倍的模型来说,Fable 既没有守住天花板,也没有在重试下保住首发优势。更便宜的模型覆盖更广,best-of-k 也更高。
成本对比:DeepSeek V4 Pro 0813 vs Claude Fable 5 的价格
每次 rollout 0.24 美元,DeepSeek V4 Pro 0813 比 Fable(21.63 美元)便宜 90 倍:每 100 美元解决 260 个任务,Fable 只有 3 个。这是我们测过的所有组合里最宽的成本差距,Fable 也是榜单上最贵的单个配置。而且与直觉相反,低价格没有带来速度惩罚:Fable 的中位 rollout 31 分钟,Pro 35 分钟,基本持平——因为 Fable 是榜单上话最多的模型(115k 输出 token),尽管它的步数更少(79 对 146)。Pro 走的步数多;Fable 每步写得多。两个模型谁也没有明显更快。
失败模式:两个模型分别怎么错
两者在「不破坏东西」上都算自律:DeepSeek V4 Pro 0813 和 Fable 各自只在 11% 的失败里回归了现有测试套件,远低于 GPT 家族的 20%。差别在另一个方向:Fable 的大偏差失误占比是这里最高的(18% 对 Pro 的 10%),也就是说 Fable 一旦错,更常是错得离谱——给出离题很远的方案,而不是差一个边界用例。Pro 更多时候倒在离正确答案不远的地方(66% 的近似失手,对 Fable 的 57%)。所以两者都可以不加重度回归门禁就放心接入,但 Fable 的失手是调试成本更高的那种。
按任务类型,各自赢在哪
Fable 的手艺体现在推理重、契约精确的领域:8 个领域里它赢 6 个,领头的是数据建模与序列化(88%,比 Pro 高 24 个点)和语言内部机制(78)。但 DeepSeek V4 Pro 0813 拿下两个,两个都分量不轻:有状态响应式(66 对 64),以及——更有说服力的——并发与持久化(58 对 45):在恰恰是 Fable 最弱的领域里领先 13 个点。Fable 在并发上的 45% 是它最弱的格子,也是唯一一个便宜模型不只是更便宜、而是工程师水平更高的领域。
按编程语言
Fable 赢下五种语言里的四种,但真正对得起它价格的是 Rust:85% 对 Pro 的 65%,20 个点的差距,也是这场对决里最大的一处差距。Fable 显然是序列化和 Rust 专家。其他语言都比价格暗示的接近(Python 70 对 60,Go 71 对 67,JavaScript 75 对 65),DeepSeek V4 Pro 0813 则实际拿下 TypeScript(61 对 57)。Rust 和序列化之外,付 90 倍价格的理由很难成立。
这两个模型到底有多不一样?
亮点在这里。逐任务相关性只有 0.39,是我们测过的 DeepSeek-Pro 组合里最低的——这两个模型是真心意见不合。它们各自解决了 88 个任务;Pro 单独拿下 12 个,Fable 单独拿下 7 个,只有 6 个任务两边都栽。两者的并集覆盖 113 个任务中的 107 个(94.7%),而且分歧是双向的:DeepSeek V4 Pro 0813 在 awilix-async-container-initialization 上四发四中,Fable 一次没成;Fable 在四个 Pro 全挂的任务上四发四中(包括 koota-query-predicates 和 testem-bail-on-test-failure)。这是真正的互补,不是冗余。
在两者之间路由:组合打法
多样性加上价格差,让级联变得很划算。先跑 DeepSeek V4 Pro 0813,只有测试套件否决答案时才升级到 Fable:82.7% 的解决率,每个任务 8.28 美元。比单用 Fable(69.7%)高 13 个百分点,价格不到 Fable 单任务价格(21.63 美元)的一半。廉价的第一阶段清掉大部分队列,Fable 的溢价只花在难啃的剩余任务上,而且那些任务在上面还多获得一次独立的尝试。级联甚至赢过完美的一次性 oracle 路由(78.8%)。顺序不是可选项:Pro 先行每个任务 8.28 美元,Fable 先行 21.71 美元,准确率一样。
这意味着什么
Fable 5 是这张榜单上最难被当作默认模型的:最贵的一次 rollout 遥遥领先,首发优势被重试抹平,四发也没有天花板优势。只为两件事买它:Rust(85%)和序列化密集的工作(88%)——只有在这里它的质量才真正对得起价格。
DeepSeek V4 Pro 0813 是相反的画像:首发准确率接近 Fable,天花板更高,失败画像持平或更好,便宜 90 倍——尽管它在 Rust 和契约精确的领域让位。而因为两者是我们测过最多样的一对,Fable 最好的用法不是当默认,而是躲在低成本的 Pro 第一阶段后面做选择性升级,只在那少数真需要 Rust 或序列化专家的任务上付费。
现已上线 · 美国托管:在 Together AI 上运行 DeepSeek-V4 Pro 0813——1.05M 上下文,支持 function calling 和 JSON mode,OpenAI 兼容 API,托管在美国基础设施。查看模型
数据表:DeepSeek V4 Pro 0813 vs Claude Fable 5 完整结果
DeepSWE · 完整结果
• Pass@1(官方计分):Pro 62.8%,Fable 69.7%
• Pass@1(错误计为失败):62.8%,67.3%
• Pass@2 / pass@4:78.5 / 88.5%,77.1 / 84.1%
• 覆盖率 / 可靠性:88.5 / 71.0%,84.1 / 82.0%
• 四发四中 / 全挂:35 / 13,56 / 18
• 每次 rollout 成本 / 总成本:0.24 美元 / 109 美元,21.63 美元 / 9,346 美元
• 每 100 美元解决数:261,3
• 中位分钟 / 步数:35 / 146,31 / 79
• 中位峰值上下文 / 输出 token:232k / 101k,202k / 115k
• 失败构成(近似 / 大偏差 / 回归):66% / 10% / 11%,57% / 18% / 11%
• 赢下的领域(共 8 个):2(有状态、并发),6
• 赢下的语言:1(TypeScript),4(Rust 大胜)
• 逐任务相关性 / 并集(两模型合计):0.39 / 113 中的 107(94.7%)
• Pro → Fable 级联(准确率 / 成本):82.7% / 8.28 美元(单用 Fable 69.7% / 21.63 美元)
• 单发 oracle 路由:78.8%
• 基础设施错误:0,16
FAQ
DeepSeek V4 Pro 0813 比 Claude Fable 5 更好吗?
看指标。Claude Fable 5 赢 DeepSWE 上的单次尝试质量(pass@1 69.7% 对 62.8%),四发四中的任务也更多(56 对 35)。DeepSeek V4 Pro 0813 在 pass@2 追平、pass@4 反超(88.5% 对 84.1%),且每次 rollout 便宜 90 倍,所以在大批量或容忍重试的 agent 工作里,它是更强的性价比之选。
DeepSeek V4 Pro 0813 比 Claude Fable 5 便宜多少?
在我们的运行里,DeepSeek V4 Pro 0813 每次 rollout 0.24 美元,Claude Fable 5 满血档 21.63 美元,约便宜 90 倍。按解决的任务算,Pro 每 100 美元解决 260 个,Fable 是 3 个——每美元的产出大约差 80 倍。
编码该用 DeepSeek V4 Pro 0813 还是 Claude Fable 5?
大多数编码工作,两者的差距比价格暗示的小。Claude Fable 5 领先 Rust(85 对 65)、Python、Go 和 JavaScript,赢下 8 个领域中的 6 个,领头的是数据建模与序列化。DeepSeek V4 Pro 0813 拿下 TypeScript(61 对 57)、有状态响应式,以及并发与持久化(58 对 45)——那正是 Fable 最弱的领域。
要不要在 DeepSeek V4 Pro 0813 和 Claude Fable 5 之间做路由?
要,前提是你能验证结果。两者是我们测过的所有组合里逐任务相关性最低的(0.39),合计覆盖 113 个任务中的 107 个。先跑 DeepSeek V4 Pro 0813,当测试套件否决输出时升级到 Claude Fable 5,能达到 82.7%、每个任务 8.28 美元——赢过单用 Fable,也赢过完美的一次性 oracle 路由。
DeepSWE 的 pass@k 是什么?
pass@k 衡量一个任务在 k 次尝试中是否至少有一次通过隐藏测试套件。pass@1 奖励一次做对;更高的 k 奖励能在多次尝试后最终到达方案的模型。DeepSeek V4 Pro 0813 的优势随 k 增大而扩大。
原文:
#DeepSWE# #AI编程# #LLM评测#
顯示更多

分享一套很适合补「现代强化学习」的开源教程:Hands-On Modern RL。
它的学习路线很完整,从 CartPole、DQN、PPO 这些经典 RL,一直讲到 RLHF、DPO、GRPO、RLVR,再往后延伸到 Agentic RL、工具调用、多轮信用分配和 VLM RL。
我比较喜欢它的一点,是「实践优先」。很多章节都配了可以直接运行的代码、训练曲线和失败案例,比如从零实现 PPO、数学推理 GRPO、Mini Deep Research Agent,以及 VLM 的 GRPO 训练。训练崩溃、Reward Hacking、KL 漂移这些实际问题也被当成正式内容来讲。
尤其 Agentic RL 部分很值得看。它把训练对象从一次回答扩展成完整 trajectory,讨论工具调用、环境反馈、多轮信用分配和异步 rollout,而这些正是 Agent 从「会回答」走向「会长期行动」之后绕不开的问题。
现在很多 RL 教程还停留在经典控制,这套资源已经把学习路线一路接到了今天的大模型后训练和 Agent 研究。
不过项目自己也提醒,目前仍在快速迭代,而且有 AI 协助生成,部分内容尚未全面审稿,阅读时最好结合论文和代码一起验证。
项目链接:
顯示更多
