検索結果 テスト管理
テスト管理 コミュニティ
1つのキーワードが1つのコミュニティです。
アカウント
見つかりません
テスト管理 を含む検索結果


# AIエージェントをエンタープライズシステムに組み込む意思決定ポイント
# プロンプト変更の統制|Prompt Change Control
🎯 ポイント
プロンプトは「ちょっとした言い回しの変更」に見えて、実はシステムの振る舞いを根本から変える「設定変更」です。コードのデプロイにはCI/CDとレビューがあるのに、プロンプトの変更は誰がいつ何を変えたか追えない——そんな状態で本番運用していませんか?プロンプト変更の統制は、すべてを同じ厳格さで管理するのではなく、本番影響度に応じてレベルを分けるのが現実解です🔑
📋 概要
プロンプト変更の統制は、エージェントのシステムプロンプトやツール定義の変更に対して、どの程度の承認・テスト・バージョン管理を求めるかを制御するダイヤルです。厳格にすれば再現性と安全性が上がりますが、開発速度が落ちます。緩めれば迅速な改善・実験が可能ですが、意図しない変更が本番に入るリスクが上がります。このダイヤルの要点は、プロンプトの構成要素ごとにリスクが異なるため、統制レベルも分けるべきだということです。システムプロンプトのロール定義とFew-shot例示では、求められる統制が全く違います📋
🔍 意思決定のポイント
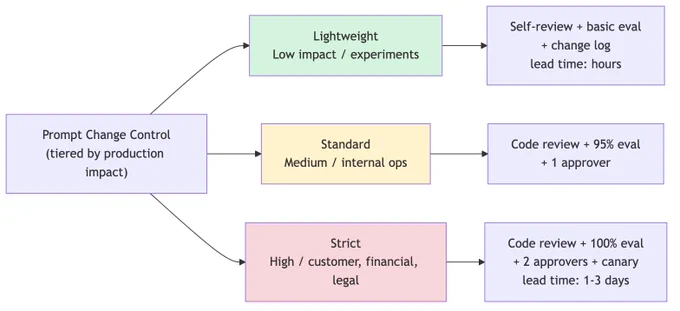
このダイヤルは「本番影響度」で3段階に分岐します。
高影響(顧客向け・金銭・法的)→ 厳格:コードレビュー+eval 100%通過+承認者2名+カナリアデプロイ
中影響(社内業務・広範囲)→ 標準:コードレビュー+eval 95%通過+承認者1名
低影響(内部実験・限定公開)→ 軽量:セルフレビュー+基本eval通過+変更ログ記録
さらにプロンプトの構成要素ごとに統制方針を分けます:
システムプロンプト(ロール・制約)→ 変更頻度は低いがリスクは高い。厳格に管理し設計判断として扱う
ツール定義(名前・説明・スキーマ)→ ツール選択精度に直結するため厳格に
Few-shot例示 → 中程度のリスク。evalで品質を確認する標準統制
コンテキスト注入テンプレート → 変更頻度が高くリスクは低〜中。軽量〜標準で対応
出力フォーマット指示 → リスクは低いが下流システムとの整合確認は必要⚡
💡 要点と詳細
統制の構成要素は5つです:
バージョン管理 — プロンプトをGitでコードと同様に管理します。差分の可視化と履歴の追跡が可能になります。「誰がいつ何を変えたか」が追跡できないと、将来の判断が困難になります。変更理由を必ず記録してください。
evalゲート — 変更後のプロンプトが既存のevalセットを通過することをデプロイの前提条件にします。evalの回帰検出率(プロンプト変更による品質低下を事前に検出できた割合)を計測し、検出できなかったケースはevalに追加して強化します。
承認プロセス — 影響度に応じた承認者のレビューです。厳格レベルでは同僚エンジニア+テックリードの2名。返金上限額など金銭に関わる記述変更は法務レビューも追加します。
カナリアデプロイ — 一部のトラフィック(目安10%)にのみ新プロンプトを適用し、24時間の品質指標を比較した上で全体展開します。A/Bテストの仕組みと共通化できます。
ロールバック手順 — 問題発生時に即座に前バージョンに戻せる仕組みです。Gitのリバートとデプロイパイプラインの連携が基本です🔬
計測すべき指標は5つ:プロンプト変更の頻度(環境ごと)、変更からデプロイまでのリードタイム(厳格レベルは1〜3営業日、軽量レベルは数時間以内が目標)、プロンプト変更起因の障害件数、evalの回帰検出率、ロールバック発生率です📈
⚖️ トレードオフ
開発速度優先(緩め)にすると、プロンプトの迅速な改善・実験が可能になりA/Bテストのサイクルが速まります。しかし「誰がいつ何を変えたか」が追跡できず、障害時に原因究明が困難になります。意図しない変更が本番に入り、品質低下やセキュリティ問題を引き起こすリスクがあります。特にシステムプロンプトのロール定義が知らないうちに変わっていた場合、影響範囲は全回答に及びます😰
再現性・安全優先(厳格)にすると、全変更が追跡可能で障害時の原因特定が容易になります。しかし変更の承認プロセスがボトルネックになり、改善のリードタイムが長くなります。小さな改善でも重い手続きが必要だとチームのモチベーションが下がり、「プロンプトを直したいけど面倒だからそのまま」という本末転倒な状態を生みます⚠️
対策は明確です:統制レベル自体を安易に下げるのではなく、evalの自動化・承認プロセスの並列化で変更リードタイムを短縮すること。そして実験環境と本番環境の統制レベルを明確に分け、実験の速度を本番の安全性と引き換えにしないことです。
🛠️ ユースケース
Zendesk顧客対応エージェント:システムプロンプトの変更はPM+エンジニアリードの承認必須。返金上限額の記述変更は法務レビューも追加。eval通過+カナリア(10%トラフィック×24時間)を経て全体展開。変更リードタイムは1〜3営業日です📞
Slack社内実験ボット:開発者がセルフレビューで変更可能。基本evalの通過は必須だが承認プロセスは省略。変更ログは自動記録され、問題発生時の原因追跡に使います。変更リードタイムは数時間以内です💬
Salesforce営業支援エージェント:ツール定義の追加・変更はコードレビュー必須。商談ステージの判定ロジックに影響するプロンプト変更はテックリードの承認が必要。大規模なプロンプト変更は段階的に実施し、影響範囲を限定します🎯
実践のコツ:初期は厳格寄りで運用を開始し、チームの習熟とevalの充実に応じて段階的に緩和してください。プロンプト変更起因の障害が発生したら、そのケースをevalに追加して再発防止を自動化する。そして大規模なプロンプト変更(ロール定義の書き換え等)は一度に行わず段階的に実施すること。一度に大きく変えると影響範囲の特定が困難になります💪
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る
# AIエージェントをソフトウェアに組み込むプラクティス
# プロンプトの成果物化
🎯 プロンプトの一文字を変えただけで本番障害。変更履歴もロールバック手段もありませんでした。
プロンプトはコードと同等以上のリスクを持つ成果物です。バージョン管理・テスト・段階デプロイの対象にしましょう。
🔥 解決する課題
LLMベースのシステムでは、プロンプトの些細な変更がモデル出力を大きく変えます。プロンプトをコード中のリテラル文字列として管理していると、変更追跡ができず障害の切り分けが困難になります。回帰テストの仕組みがなく品質変化を定量評価できません。問題が起きても「前のプロンプトに戻す」にコードデプロイが必要です。規制領域では「どのバージョンのプロンプトでどの判断がなされたか」の監査が求められますが、プロンプトがコード内に散在しているとこの紐づけが困難です。
💡 提案パターン
プロンプトを独立した成果物としてバージョン管理し、変更時にはCIで回帰テスト(評価ハーネス)を実行します。本番環境ではカナリアリリース(5〜10%)で段階的にロールアウトし、品質低下を検知したら即座にロールバックします。実行時ログにはプロンプトIDとバージョンを記録し、事後監査で「この判断はどのプロンプトに基づくか」を示せる設計にします。プロンプトとモデルの互換性も記録し、モデル更新時に再評価が必要なプロンプトを特定できるようにします。
✅ 選定条件
使うとき:
- プロンプトの変更履歴と実行時バージョンの記録が求められる(規制領域・品質管理)
- プロンプトが複数箇所から参照され、一元管理が必要
- A/Bテストや段階的ロールアウトを行いたい
使わないとき:
- プロンプトが1〜2個で変更頻度も低い個人プロジェクトやPoC
- 出力品質の変動が許容される探索的用途
⚠️ 落とし穴
- テンプレート変数にユーザ入力が入る場合、インジェクション対策としてエスケープやサニタイズが必要です
- プロンプト解決を外部APIに依存しすぎると可用性リスクが増します。起動時フェッチ+ローカルキャッシュも検討しましょう
- プロンプトは行指向フォーマット(YAML/Markdown)で保存してください。巨大な1行JSONではdiffレビューが困難です
🔧 実装方針
- プロンプトをYAML等の行指向フォーマットで管理し、テンプレート・変数定義・モデル互換性・評価ベースラインを一つのファイルに集約します
- ランタイムではレジストリからプロンプトIDで解決し、カナリア対象なら確率的にカナリア版を返す仕組みを組み込みます
- 実行時ログにプロンプトIDとバージョンを必ず記録し、事後監査で「どの判断がどのプロンプトに基づくか」を追跡可能にします
- プロンプト変更時にはCIで評価ハーネスを自動実行し、品質の回帰を検知してからカナリアリリースで段階的にロールアウトします
#AIエージェント# #ソフトウェアアーキテクチャ#
もっと見る

# AIエージェント開発の意思決定ポイント
# プロンプト制御 vs コード/ポリシー制御 🛡️
🎯 ポイント
エージェントの振る舞いを制約する手段として、プロンプトで「お願い」するか、コードで「壁」を作るか。この違いは「確率的な遵守」と「決定論的な強制」の違いに直結します。
「個人情報を出力しないでください」とプロンプトに書いても、プロンプトインジェクションで上書きされたり、コンテキストの膨張で指示の効力が揺らいだりします。正規表現で検出してブロックする処理は、LLMの判断に関係なく確実に動作します。問題は「どの制約をコードに引き上げるか」の判断です。
📋 概要
プロンプト制御はLLMへのシステムプロンプトや指示文に制約を記述し、振る舞いを誘導する方式です。Few-shot例示、ネガティブ指示、ロール設定などが典型的な手法です。コード/ポリシー制御は制約を実行可能なコード(条件分岐、正規表現、スキーマ検証)またはポリシーエンジン(OPA/Rego、Cedar等)で実装し、LLMの入出力や操作を強制的に制御する方式です。
🔍 意思決定のポイント
**failure_cost** と **accountability** の2つで判定します。
📊 **制約の種類ごとの判定**:
コード/ポリシーで強制すべきもの:
- 🔒 境界・法的制約(個人情報の出力禁止、金額上限、禁止操作)
- 🔒 不可逆操作の制限(削除、送金、公開)
- 🔒 出力形式の強制(JSONスキーマ、値域の検証)
プロンプトで誘導すべきもの:
- 💬 応答の品質・様式(口調、丁寧さ、専門用語の使用)
- 💬 文脈依存の判断指針(どのような場合に何を優先するか)
💡 要点と詳細
🟢 **プロンプト制御の強み**は柔軟性と表現力です。自然言語で記述するため、微妙なニュアンスや文脈依存の振る舞いを指示できます。「法務向けでは正式な表現、エンジニア向けでは技術用語OK」のような条件付き様式が自然に表現でき、変更もデプロイなしにプロンプトを書き換えるだけです。弱点は信頼性の低さで、プロンプトインジェクション・コンテキスト膨張・モデル更新で制約が破れるリスクがあります。版管理・テスト・監査も困難です。
🟡 **コード/ポリシー制御の強み**は確定性と監査性です。制約はコードとして版管理され、ユニットテストで検証され、監査証跡として残ります。「この出力がなぜブロックされたか」はポリシーの版とルールIDで一意に特定できます。プロンプトインジェクションやモデル更新の影響を受けません。ポリシーエンジンを使えばルール変更もデプロイなしで反映可能です。弱点は表現力の限界で、「丁寧に応答する」のような質的な制約はコードで表現できません。
⚖️ トレードオフ
| 観点 | プロンプト制御 | コード/ポリシー制御 |
|---|---|---|
| 信頼性 | 確率的(破れるリスクあり) 🔴 | 決定論的 🟢 |
| 表現力 | 高い(ニュアンス可) 🟢 | 低い(条件→判定に限定) |
| 監査性 | プロンプト履歴の追跡が必要 | 版管理+監査証跡 🟢 |
| インジェクション耐性 | 脆弱 | 影響を受けない |
| 変更速度 | プロンプト書換のみ | ポリシー更新 or デプロイ |
| 開発コスト | 低い | インフラ+スキルが必要 |
🛠️ ユースケース
🔵 **プロンプト制御が向くケース**: 応答トーン・様式の誘導、文脈依存の判断指針、制約違反の影響が軽微なケース。
🔴 **コード/ポリシー制御が向くケース**: 個人情報・金融データの出力制御、不可逆操作の制限、規制対象の処理、出力形式の厳密な検証。
📌 **デフォルト戦略**: 「境界(壊してはならない制約)はコード、誘導(望ましい振る舞い)はプロンプト」が定石です。迷ったら「この制約が破られたとき、どれだけ痛むか」を自問してください。痛みが大きいならコードで強制、小さいならプロンプトで誘導します。最も実用的な構成はポリシー強制+プロンプト誘導の二層構造です。コード/ポリシーで境界を決定論的に強制しつつ、プロンプトでLLMの振る舞いを境界の内側で誘導します。プロンプトの誘導が失敗してもポリシーが最終防壁として機能します。
#AIエージェント# #ソフトウェアアーキテクチャ#
もっと見る
🧩 「外側は裁量、内側は決定論」。プロンプトだけで手順を守らせると脆い——という課題を、Skillsと埋め込み型インタプリタを統合し、実行可能なコードで解くアプローチです。
タイトル: Building workflows for agents with Skills and Interpreter
URL:
📝 概要
本記事は、再利用可能な振る舞いパッケージ「Skills」と、エージェントのハーネスと並んで動く埋め込み型TypeScriptランタイム「Interpreter」を統合したInterpreter Skillsを解説します。SKILL.mdが「いつ使うか」を、index.tsが「どう実行するか」を担い、エージェントは適用判断と入力だけを決め、モジュールが決定論的な実行を担います。
❓ 解決する課題
エージェントは裁量的な判断は得意でも、決定論的な手順の遂行は苦手です。プロンプトだけの手順遵守は脆く、ステップを飛ばしたり順序を入れ替えたりします。300以上の項目を処理するような複雑な多段ルーチンでは、コンテキストをまたいで一貫性を保たせると「コンテキスト不安」が生じていました。
💡 方法論と提案手法
・Skillsは段階的開示を用い、コンパクトなスキル一覧を見て関連するものだけ詳細を読み、プロンプトから分離してバージョン管理・共有可能な単位にします
・Interpreterはデフォルトでアクセスが制限され、ファイルシステム・ネットワーク・ツール・サブエージェントは明示的に公開した分だけ使えます
・スキルモジュールはサブエージェントをコードからプログラム的に生成・管理し、モデル介在のステップでなくコードから複雑なタスクグラフを編成します
・パースやフィルタ、グルーピングといったローカル操作はTypeScriptコードで表し、ツール面を絞ってモデルが扱いやすくします
🎯 ユースケース
GitHubのIssue・PR・ディスカッションを取得し、項目ごとにサブエージェントで要約を作り、別のサブエージェントで分類・クラスタリングするトリアージなど、状態の多い多段ワークフローに向きます。
📊 評価と意義
・「概ね指示に従ったか」ではなく「期待した関数を呼んだか」という具体的な問いを立てられ、必要な手順が正しい入力で実行されたかを測定できます
・モデルは一度呼び出すだけで、モジュールがワークフロー全体を決定論的に編成し、コンパクトな構造化オブジェクトを返します
・モデルは戦略的制御を保ちつつ、重要な手順はレビュー可能・テスト可能なコードで実行され、エージェントの作業をバージョン管理・テスト・コードレビューといったソフトウェア工学の実践へ移行させます
#AIエージェント# #DevTools#
もっと見る

# ADK 2.0の便利だけど知られていない機能
🌍 エージェントに「スキル」として再利用可能な機能モジュールを簡単に追加できたら、開発効率が大きく上がると思いませんか?
ADK 2.0のスキル機能は、
📌 タイトル:エージェント向けスキル (Skills)
🔗 URL:
🧩 概要
スキルは を使ってエージェントにスキルをラップして提供できます。
🛠 使い方
スキルはSKILL.mdファイルとして定義し、エージェントに読み込ませます。
```python
from adk import Agent
from adk.skills import SkillToolset
# ファイルシステムからスキルを読み込み
skill_toolset = SkillToolset(
skill_path="./skills/data_analysis"
)
agent = Agent(
name="analyst",
model="gemini-3.5-flash",
tools=[skill_toolset],
instruction="データ分析スキルを使って質問に回答してください。"
)
```
SKILL.mdのフロントマターにはスキルの名前、説明、バージョンなどのメタデータを記述し、本文にエージェントへの具体的な指示を記載します。L3リソースとして外部ファイルやスクリプトを参照することも可能です。
🏗 本番システムへの組み込み方
・スキルを独立したディレクトリとして管理し、バージョン管理とテストを容易にする
・共通スキル(データ検索、レポート生成など)をチーム横断で再利用できるスキルライブラリを構築する
・L3リソースを活用して、スキルに必要なデータやスクリプトをバンドルする
・スキルのフロントマターにバージョンを記載し、互換性を管理する
💡 ユースケース
📊 データ分析スキルを複数のエージェントで共有して使い回す
📝 レポート生成のテンプレートとロジックをスキルとしてパッケージ化する
🔌 外部API連携のノウハウをスキルとして標準化し、チームで共有する
🧩 複雑なワークフローをスキルの組み合わせとして構成する
⚠️ 注意点
スキル機能は実験的(Experimental)なステータスです。Python v1.25.0以降、TypeScript v0.6.1以降、Go v1.2.0以降で利用できますが、APIや仕様が変更される可能性があります。本番環境への導入時はバージョン固定を推奨します。また、
✨ スキルを活用することで、エージェントの機能を再利用可能なモジュールとして整理でき、開発と保守の効率が大幅に向上します。まずは小さなスキルから試してみてください。
#ADK# #AIAgent#
もっと見る


AIエージェント時代のテスト駆動開発(TDD)の話
一年前のセッションなので、今聴くとせやな
従来のTDDは決定的な出力を前提にするが、AIは同じ入力でも出力がばらつくのでこの前提が崩れる
ゆえに評価はpass/fail の二値をやめ、スコア・レーティング・満足度・挙動(推論・ツール選択・判断)で測る。
AI版SDLCは5段階
①企画/spec(AIが本当に効く箇所を見極める)
②実験(小データで小さく検証)
③大規模eval(数百〜数千のテストで評価)
④リリース管理(AIとアプリのデプロイを分離)
⑤可観測性(本番のエッジケースをトレース)
肝はループ、テスト作成→eval→プロンプト/ロジック修正→リグレッション確認
1つ直すと別が壊れるのを検知する
魔法のように自己改善するエージェントは幻想。複雑なほど地道な可観測性が必要
もっと見る


MagicPod、モバイルとWebブラウザのテストを1プロジェクトで管理・一括実行できる「ミックスプラットフォームテス...
