検索結果 全額返金保証公演
全額返金保証公演 コミュニティ
1つのキーワードが1つのコミュニティです。
アカウント
見つかりません
全額返金保証公演 を含む検索結果

#全額返金保証公演#
ありがとうございました!
私たちはまだまだこれからです。
負けません!もっと良い公演にする!
でも今日は今日で楽しかったあ😂💗
teamSスキだ!みんなスキだー!!ありがとう!!
#愛を君に愛を僕に#
もっと見る


6月8日(水)
「愛を君に、愛を僕に」アルバム発売!
名古屋市内の駅にポスターの掲示が🥹💗
たくさんの方の目に留まりますように!
ぜひ見に来てください!👀💙
#愛を君に愛を僕に#
#SKE48teamSオリジナル新公演#
#全額返金保証公演#
もっと見る


【地下1階理美容コーナー】
#リファ# の #シャワーヘッド# って本当にいいの❓
そんなお客様へ朗報‼️
なんと、今ならご購入後3️⃣0️⃣日以内なら全額返金保証がついてきます‼️
ご使用後でもご満足頂けなかったら全額返金‼️
詳しくは店頭販売員にお尋ねください🎶
#LABI池袋本店#
もっと見る


・
《あと1人、、!!!》
薄毛治療のオンラインクリニック、本日中にカウンセリングを受けていただける方
💰治療費2ヶ月分0円、にします!!!!
▼2ヶ月0円で治療する
・治療継続ごとに割引を受けることができ、月々の負担が減る
・減薬サポートを受けることができる
・全額返金保証がある
他社との違いの詳細はカウンセラーにも聞いてね、最近くりえみも問診はいってますw
もっと見る


# AIエージェントをエンタープライズシステムに組み込む意思決定ポイント
# プロンプト変更の統制|Prompt Change Control
🎯 ポイント
プロンプトは「ちょっとした言い回しの変更」に見えて、実はシステムの振る舞いを根本から変える「設定変更」です。コードのデプロイにはCI/CDとレビューがあるのに、プロンプトの変更は誰がいつ何を変えたか追えない——そんな状態で本番運用していませんか?プロンプト変更の統制は、すべてを同じ厳格さで管理するのではなく、本番影響度に応じてレベルを分けるのが現実解です🔑
📋 概要
プロンプト変更の統制は、エージェントのシステムプロンプトやツール定義の変更に対して、どの程度の承認・テスト・バージョン管理を求めるかを制御するダイヤルです。厳格にすれば再現性と安全性が上がりますが、開発速度が落ちます。緩めれば迅速な改善・実験が可能ですが、意図しない変更が本番に入るリスクが上がります。このダイヤルの要点は、プロンプトの構成要素ごとにリスクが異なるため、統制レベルも分けるべきだということです。システムプロンプトのロール定義とFew-shot例示では、求められる統制が全く違います📋
🔍 意思決定のポイント
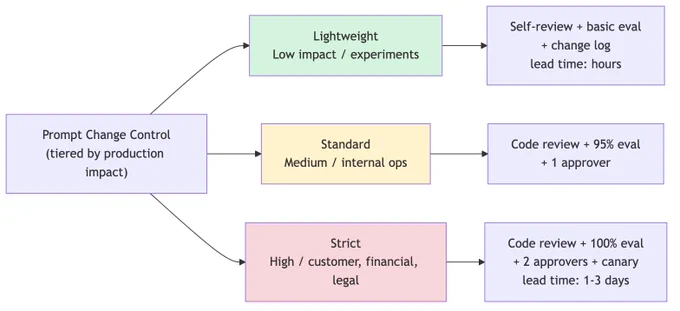
このダイヤルは「本番影響度」で3段階に分岐します。
高影響(顧客向け・金銭・法的)→ 厳格:コードレビュー+eval 100%通過+承認者2名+カナリアデプロイ
中影響(社内業務・広範囲)→ 標準:コードレビュー+eval 95%通過+承認者1名
低影響(内部実験・限定公開)→ 軽量:セルフレビュー+基本eval通過+変更ログ記録
さらにプロンプトの構成要素ごとに統制方針を分けます:
システムプロンプト(ロール・制約)→ 変更頻度は低いがリスクは高い。厳格に管理し設計判断として扱う
ツール定義(名前・説明・スキーマ)→ ツール選択精度に直結するため厳格に
Few-shot例示 → 中程度のリスク。evalで品質を確認する標準統制
コンテキスト注入テンプレート → 変更頻度が高くリスクは低〜中。軽量〜標準で対応
出力フォーマット指示 → リスクは低いが下流システムとの整合確認は必要⚡
💡 要点と詳細
統制の構成要素は5つです:
バージョン管理 — プロンプトをGitでコードと同様に管理します。差分の可視化と履歴の追跡が可能になります。「誰がいつ何を変えたか」が追跡できないと、将来の判断が困難になります。変更理由を必ず記録してください。
evalゲート — 変更後のプロンプトが既存のevalセットを通過することをデプロイの前提条件にします。evalの回帰検出率(プロンプト変更による品質低下を事前に検出できた割合)を計測し、検出できなかったケースはevalに追加して強化します。
承認プロセス — 影響度に応じた承認者のレビューです。厳格レベルでは同僚エンジニア+テックリードの2名。返金上限額など金銭に関わる記述変更は法務レビューも追加します。
カナリアデプロイ — 一部のトラフィック(目安10%)にのみ新プロンプトを適用し、24時間の品質指標を比較した上で全体展開します。A/Bテストの仕組みと共通化できます。
ロールバック手順 — 問題発生時に即座に前バージョンに戻せる仕組みです。Gitのリバートとデプロイパイプラインの連携が基本です🔬
計測すべき指標は5つ:プロンプト変更の頻度(環境ごと)、変更からデプロイまでのリードタイム(厳格レベルは1〜3営業日、軽量レベルは数時間以内が目標)、プロンプト変更起因の障害件数、evalの回帰検出率、ロールバック発生率です📈
⚖️ トレードオフ
開発速度優先(緩め)にすると、プロンプトの迅速な改善・実験が可能になりA/Bテストのサイクルが速まります。しかし「誰がいつ何を変えたか」が追跡できず、障害時に原因究明が困難になります。意図しない変更が本番に入り、品質低下やセキュリティ問題を引き起こすリスクがあります。特にシステムプロンプトのロール定義が知らないうちに変わっていた場合、影響範囲は全回答に及びます😰
再現性・安全優先(厳格)にすると、全変更が追跡可能で障害時の原因特定が容易になります。しかし変更の承認プロセスがボトルネックになり、改善のリードタイムが長くなります。小さな改善でも重い手続きが必要だとチームのモチベーションが下がり、「プロンプトを直したいけど面倒だからそのまま」という本末転倒な状態を生みます⚠️
対策は明確です:統制レベル自体を安易に下げるのではなく、evalの自動化・承認プロセスの並列化で変更リードタイムを短縮すること。そして実験環境と本番環境の統制レベルを明確に分け、実験の速度を本番の安全性と引き換えにしないことです。
🛠️ ユースケース
Zendesk顧客対応エージェント:システムプロンプトの変更はPM+エンジニアリードの承認必須。返金上限額の記述変更は法務レビューも追加。eval通過+カナリア(10%トラフィック×24時間)を経て全体展開。変更リードタイムは1〜3営業日です📞
Slack社内実験ボット:開発者がセルフレビューで変更可能。基本evalの通過は必須だが承認プロセスは省略。変更ログは自動記録され、問題発生時の原因追跡に使います。変更リードタイムは数時間以内です💬
Salesforce営業支援エージェント:ツール定義の追加・変更はコードレビュー必須。商談ステージの判定ロジックに影響するプロンプト変更はテックリードの承認が必要。大規模なプロンプト変更は段階的に実施し、影響範囲を限定します🎯
実践のコツ:初期は厳格寄りで運用を開始し、チームの習熟とevalの充実に応じて段階的に緩和してください。プロンプト変更起因の障害が発生したら、そのケースをevalに追加して再発防止を自動化する。そして大規模なプロンプト変更(ロール定義の書き換え等)は一度に行わず段階的に実施すること。一度に大きく変えると影響範囲の特定が困難になります💪
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る
# AIエージェントをエンタープライズシステムに組み込む意思決定ポイント
# HITL vs HOTL vs 全自動
🎯 ポイント
エージェントに「全部任せる」か「全部聞いてくる」か — この二択で設計していませんか?実は人間の関与度にはHITL(都度承認)、HOTL(監視+例外介入)、全自動の三段階があり、操作のリスクと実績に応じて段階的に自動化レベルを引き上げるのが基本戦略です。さらに、一度決めたら固定ではなく「運転免許」のように昇格・降格する動的運用が鍵になります🔑
📋 概要
HITL(Human-in-the-Loop)は、エージェントの各操作に対して人間が都度承認する方式です。不可逆で影響が大きい操作 — Workdayでの給与変更、Salesforceでの大型商談のステージ変更、本番DBへの書き込み — に適用します。HOTL(Human-on-the-Loop)は、エージェントが自動実行しつつ人間が監視し、異常時のみ介入する方式です。一定の実績があり、操作のリスクが中程度の場合に有効です。全自動は、操作が可逆かつ影響範囲が限定的で、エージェントの精度が十分に検証されている場合に適用します。
🔍 意思決定のポイント
判断フローは「可逆性」→「影響範囲」→「実績」→「件数」の順で進みます。
操作は可逆か? → 不可逆ならHITLが基本です。可逆なら次へ。
影響範囲は? → 外部顧客・金銭・法的効力に直結するならHITL。社内のみならHOTL以上を検討できます。
エージェントの実績は十分か? → 導入初期・実績不足ならHITLから開始。過去の承認率が95%以上ならHOTLへの昇格を検討します。
処理件数は人手で対応可能か? → 日次50件以下ならHITLが現実的。100件超ならHOTLまたは条件付き全自動を検討しましょう。
最後の確認:異常検知とロールバックの仕組みがあるか? → なければHITLに留めるべきです⚡
💡 要点と詳細
HITLの適用範囲は「不可逆×高影響」の操作です。規制要件により「人間が承認した」エビデンスが必須の場合(金融取引、医療判断、法的文書の発行)、副作用が外部顧客に直接影響する場合(顧客向けメール送信、契約書の自動生成、請求処理)、そして導入初期で出力品質の実績データがまだ蓄積されていない場合に選択します。
HOTLは「中リスク×実績あり」の操作に最適です。Jiraチケットの優先度変更、Slackへの社内通知、ServiceNowのインシデント分類など。異常検知の仕組み(信頼度スコア、異常値アラート)で逸脱をリアルタイムに検知し、ロールバック手段で誤操作を事後修正できることが前提条件です。
全自動は「可逆×低影響×高精度」の操作に限定します。社内ナレッジの検索と要約、ログの自動分類、ダッシュボード更新など。エラー率が1%未満で安定していること、即時性が求められ人間の介入がSLA違反につながる場合(リアルタイムのカスタマーサポート初期応答など)が適用条件です。
最も強力な運用パターンはリスクベースの動的切り替えです。操作の種類・金額・影響範囲に応じて自動的にモードを切り替えます。例えば10万円未満の経費承認は全自動、10〜100万円はHOTL、100万円超はHITLとします🎚️
⚖️ トレードオフ
HITLの最大の罠は承認疲れ(Approval Fatigue)です。全操作をHITLにした結果、承認者が形骸的に全件承認し、ゲートとして機能しなくなります。低リスク操作への繰り返し承認で「OKを押す作業」が機械的になり、本当に重要な承認も見逃す。「全件承認」は「承認なし」と同じくらい危険です。
全自動への早すぎる移行も危険です。十分な実績データなしに全自動化し、エッジケースでの誤操作が顧客影響を引き起こすケースが後を絶ちません。特にZendeskの顧客応答やShopifyの注文処理で問題になりやすい。
見落としがちなのは降格ルールの未定義です。全自動に昇格した後にモデル変更や精度劣化が発生した場合、HOTL→HITLへの巻き戻しルールがなければ、問題が長期化します。昇格ルールと降格ルールはセットで定義してください⚠️
🛠️ ユースケース
EC受注処理エージェント:注文・在庫確認は全自動(可逆×低影響)、発送手配はHOTL(2週間の実績で承認率95%超なら昇格)、返金処理はHITL(金銭操作は常に承認必要)、高額注文(100万円超)はHITLでドライラン付き。金額と操作種別でモードを動的に切り替えます🛒
開発支援エージェント(CI/CD連携):コード分析とテスト実行は全自動(開発環境限定)、PR作成はHOTL(信頼度スコア連動)、ステージングデプロイはHITL、本番デプロイはHITL+ドライラン必須。サンドボックスでは全自動まで許容しますが、本番影響のある操作は制限します🔧
社内ナレッジ検索アシスタント:検索は全自動、回答生成もHOTL(出力ガードレール付き)、文書編集はHITL、削除はHITLでドライランのみ。読取中心のワークフローなので高い自律性で運用可能です📚
実践のコツ:昇格条件を数値で定義してください。「承認率95%以上を2週間継続」「重大エラー0件」など、曖昧さのない基準を設定する。降格トリガーも事前に決める。「重大エラー1件で即座にHITLに戻す」「承認率が90%を下回ったらHOTLに降格」。昇格履歴はすべて監査証跡として記録してください💪
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る

# AIエージェント開発の意思決定ポイント
🎯 **ポイント**
全部のタスクに最強モデルを使っていませんか?「Yes/Noの分類」にフラグシップモデルを使うのは、引っ越しにジャンボジェットを飛ばすようなものです。モデル階層化は、コストと品質のバランスを「定数」から「関数」に変える実践的な戦略です。
📋 **概要**
モデル階層とは、タスクの種類や難易度に応じて小型・中型・大型のどのクラスのLLMを使うかを制御するダイヤルです。AIエージェントシステムでは、1回のセッション内に分類・抽出のような定型処理と、推論・計画のような高度な処理が混在します。すべてを大型モデルで処理すれば品質は安定しますが、月間コストが桁違いに膨張します。実運用では全リクエストの概ね60〜80%が小型・中型モデルで十分処理でき、大型モデルが本当に必要なのは残りの20〜40%です。
🔍 **意思決定のポイント**
このダイヤルは2つの駆動変数で決めます。
🔹 **コスト感度(cost_sensitivity)** — コスト感度が高いほど小型モデルへの振り分けを増やします。全リクエストを大型モデルで処理する場合と比べ、60%を小型(コスト1/10)、20%を中型(コスト1/3)、20%を大型で処理すると、コストは概ね30%程度まで削減できます。
🔹 **リクエスト価値(request_value)** — 価値の高いリクエストほどエスカレーション閾値を下げ、早めに上位モデルを使います。逆にコスト感度が高い場合は閾値を上げ、本当に必要な場合のみエスカレーションします。
まずはタスク種別による静的ルーティングから始めるのが実践的です。分類・タグ付け・抽出は小型、要約・翻訳は中型、推論・計画・コード生成は大型。そこに信頼度ベースのエスカレーション(構造化出力のパースエラー率、回答拒否率などで判定)を重ねます。
💡 **要点と詳細**
📊 モデル階層数は2〜3層が運用しやすいです。4層以上は管理コストが増大します。エスカレーション閾値は信頼度0.7〜0.85が目安で、リクエスト価値が高いほど下げます。
ルーター方式はまずルールベースで始めましょう。LLMをルーターに使うとルーティング自体にコストがかかり、小型モデル1回分に匹敵することもあります。リクエスト量が少ないうちは入力長やキーワードベースのルールで十分です。
障害時には逆方向のフォールバック(大型→中型→小型)も有効です。サーキットブレーカが開いた場合に軽量モデルに切り替えることで、品質は落ちてもサービスを継続できます。縮退レベルをレスポンスのメタデータに含め、クライアント側で品質低下の可能性を表示するのが望ましいです。
⚖️ **トレードオフ**
📉 小型モデルに偏りすぎると — 複雑な推論タスクで「もっともらしいが間違っている」回答が増えます。計画の途中で矛盾が発生し実行フェーズで失敗、コード生成では構文は正しいが論理的に誤ったコードが生成されます。失敗コストが高いタスクでは、エラー修正コストが節約額を上回ることになります。
📈 大型モデルに偏りすぎると — 単純な分類タスクに100倍のコストをかけ、応答時間が数秒に膨張します。大型モデルのレート制限に達しやすくなり、全リクエストが429エラーの影響を受けるリスクもあります。月間コストの予算超過はサービスの継続性を脅かします。
🛠️ **ユースケース**
📞 **カスタマーサポート** — 質問分類・FAQ回答・感情分析は小型モデル(全体の約70%)、技術的な問題の診断は中型〜大型、返金ポリシー判断は大型モデル。分類結果に応じて適切な層にルーティングします。
📊 **データ分析パイプライン** — フォーマット変換は小型、数値統計はコード(LLM不要)、パターン分析・異常検知の解釈とエグゼクティブサマリは大型。パイプラインの大部分は小型モデルとコードで処理できます。
🔄 **障害時フォールバック** — 通常は大型モデルで推論し、プロバイダ障害時に中型→小型と段階的にダウングレード。全プロバイダ障害なら静的フォールバック。可用性と品質のバランスを動的に調整する構成です。
信頼度の定義は測定可能な指標に落としましょう。「なんとなく自信がない」では運用できません。モデル更新時はルーティング比率の再検証もお忘れなく。
#AIエージェント# #ソフトウェアアーキテクチャ#
もっと見る
# AIエージェント開発の意思決定ポイント
🎯 **ポイント**
全部のタスクに最強モデルを使っていませんか?「Yes/Noの分類」にフラグシップモデルを使うのは、引っ越しにジャンボジェットを飛ばすようなものです。モデル階層化は、コストと品質のバランスを「定数」から「関数」に変える実践的な戦略です。
📋 **概要**
モデル階層とは、タスクの種類や難易度に応じて小型・中型・大型のどのクラスのLLMを使うかを制御するダイヤルです。AIエージェントシステムでは、1回のセッション内に分類・抽出のような定型処理と、推論・計画のような高度な処理が混在します。すべてを大型モデルで処理すれば品質は安定しますが、月間コストが桁違いに膨張します。実運用では全リクエストの概ね60〜80%が小型・中型モデルで十分処理でき、大型モデルが本当に必要なのは残りの20〜40%です。
🔍 **意思決定のポイント**
このダイヤルは2つの駆動変数で決めます。
🔹 **コスト感度(cost_sensitivity)** — コスト感度が高いほど小型モデルへの振り分けを増やします。全リクエストを大型モデルで処理する場合と比べ、60%を小型(コスト1/10)、20%を中型(コスト1/3)、20%を大型で処理すると、コストは概ね30%程度まで削減できます。
🔹 **リクエスト価値(request_value)** — 価値の高いリクエストほどエスカレーション閾値を下げ、早めに上位モデルを使います。逆にコスト感度が高い場合は閾値を上げ、本当に必要な場合のみエスカレーションします。
まずはタスク種別による静的ルーティングから始めるのが実践的です。分類・タグ付け・抽出は小型、要約・翻訳は中型、推論・計画・コード生成は大型。そこに信頼度ベースのエスカレーション(構造化出力のパースエラー率、回答拒否率などで判定)を重ねます。
💡 **要点と詳細**
📊 モデル階層数は2〜3層が運用しやすいです。4層以上は管理コストが増大します。エスカレーション閾値は信頼度0.7〜0.85が目安で、リクエスト価値が高いほど下げます。
ルーター方式はまずルールベースで始めましょう。LLMをルーターに使うとルーティング自体にコストがかかり、小型モデル1回分に匹敵することもあります。リクエスト量が少ないうちは入力長やキーワードベースのルールで十分です。
障害時には逆方向のフォールバック(大型→中型→小型)も有効です。サーキットブレーカが開いた場合に軽量モデルに切り替えることで、品質は落ちてもサービスを継続できます。縮退レベルをレスポンスのメタデータに含め、クライアント側で品質低下の可能性を表示するのが望ましいです。
⚖️ **トレードオフ**
📉 小型モデルに偏りすぎると — 複雑な推論タスクで「もっともらしいが間違っている」回答が増えます。計画の途中で矛盾が発生し実行フェーズで失敗、コード生成では構文は正しいが論理的に誤ったコードが生成されます。失敗コストが高いタスクでは、エラー修正コストが節約額を上回ることになります。
📈 大型モデルに偏りすぎると — 単純な分類タスクに100倍のコストをかけ、応答時間が数秒に膨張します。大型モデルのレート制限に達しやすくなり、全リクエストが429エラーの影響を受けるリスクもあります。月間コストの予算超過はサービスの継続性を脅かします。
🛠️ **ユースケース**
📞 **カスタマーサポート** — 質問分類・FAQ回答・感情分析は小型モデル(全体の約70%)、技術的な問題の診断は中型〜大型、返金ポリシー判断は大型モデル。分類結果に応じて適切な層にルーティングします。
📊 **データ分析パイプライン** — フォーマット変換は小型、数値統計はコード(LLM不要)、パターン分析・異常検知の解釈とエグゼクティブサマリは大型。パイプラインの大部分は小型モデルとコードで処理できます。
🔄 **障害時フォールバック** — 通常は大型モデルで推論し、プロバイダ障害時に中型→小型と段階的にダウングレード。全プロバイダ障害なら静的フォールバック。可用性と品質のバランスを動的に調整する構成です。
信頼度の定義は測定可能な指標に落としましょう。「なんとなく自信がない」では運用できません。モデル更新時はルーティング比率の再検証もお忘れなく。
#AIエージェント# #ソフトウェアアーキテクチャ#
もっと見る
「2XKO」,積極的な開発を12月に終了。本日までのゲーム内購入を全額返金し,9月9日のパッチで全チャンピオンをアンロック
理由としては,継続的なサービス維持につながるほどプレイヤーが定着しなかったことが挙げられている
もっと見る


【話題】日本人ママさん、ベトナム航空機で窓にヒビが入る恐怖体験
→航空会社に“全額返金”を求める
果たして返金を求めるのが妥当なのかどうかが議論に
もっと見る
