検索結果 制御システム
制御システム コミュニティ
1つのキーワードが1つのコミュニティです。
アカウント
見つかりません
制御システム を含む検索結果

📢「制御システム関連のサイバーインシデント事例」の第12集・第13集を公開しました。
本資料は制御システムのセキュリティリスク分析ガイドで示す、過去の攻撃事例をベースにしたシナリオでのリスク分析の実践に活用いただけます。
#制御システム ##セキュリティ#
もっと見る


# Claude Agent SDKの便利で実践的な使い方
🛡 プロンプトインジェクション対策・認証情報プロキシ・最小権限で多層防御を構築しましょう。
セキュアデプロイメントは、分離技術・認証情報プロキシ・ネットワーク制御でエージェントの安全な本番運用を実現するガイドです。
📌 タイトル:AI エージェントの安全なデプロイ
🔗 URL:
🧩 概要
sandbox-runtime / Docker / gVisor / Firecracker の分離技術、認証情報プロキシパターン、ネットワーク・ファイルシステム制御を組み合わせた多層防御を提供します。
🛠 使い方
分離強度に応じて技術を選択:単一開発者/CI は sandbox-runtime、マルチテナントは gVisor/Firecracker。認証情報は Envoy / mitmproxy / LiteLLM で境界外注入します。
🏗 実践的な使い方
・認証情報プロキシパターン:API キーをエージェント境界外のプロキシで注入し、エージェントは認証情報を見ずに API 呼び出しします。`ANTHROPIC_BASE_URL` でルーティング。
・最小権限:必要ディレクトリのみ読み取り専用マウント、`.env`・`~/.aws/credentials`・`*.pem` を除外、`--network none` + Unix ソケットプロキシでネットワーク制限。
・クラウドではプライベートサブネット + クラウドファイアウォールでプロキシ以外の送信を全ブロックし、許可リスト強制・認証情報注入・全トラフィックログを実現します。
💡 ユースケース
🔐 認証情報のエージェント境界外管理
🌐 ネットワーク制限による外部送信の防止
🏢 マルチテナント環境での強分離
⚠️ 注意点
信頼できないコンテンツ(README、Web ページ、ユーザー入力)にはプロンプトインジェクションが含まれる可能性があります。ネットワーク制御は最後の防衛線として必ず設定してください。
#ClaudeAgentSDK# #AI#
もっと見る


1日5分の呼吸プロトコルが、メンタルという名のOSを瞑想より深くアップデートする。
大げさじゃない。先に説明する。
気分の落ち込みや慢性的な緊張は、精神的な弱さの問題ではない。自律神経(呼吸・心拍・血圧を自動制御するシステム)が交感神経(緊張・警戒モード)側に傾いたままの、構造的な機能不全だ。
多くの人はこれを瞑想で鎮めようとする。だが2023年、スタンフォード大学がその前提を検証した。
Balbanらの研究(2023年、Cell Reports Medicine)は、1日5分×1ヶ月のcyclic sighing(生理的ため息と呼ばれる呼吸法)と、同じ5分間のマインドフルネス瞑想を比較。
気分の改善幅は、cyclic sighing群が瞑想群を上回った。安静時呼吸数の低下幅も大きかった。
理由は構造にある。cyclic sighingは、鼻から深く吸い、もう一度短く吸い足し、口からゆっくり長く吐く、二段階の吸気を持つ。
二段階目で肺胞(肺の中の小さな袋)が再膨張し、続く長い呼気で肺が伸展。その伸展信号が迷走神経(副交感神経の主幹)を活性化させ、心拍を落とす。
瞑想が意識で緊張を鎮める間接策なのに対し、これは肺というハードウェアに直接信号を送り、自律神経を書き換える。
▼1日5分・cyclic sighingの実装
・鼻から深く1回吸う
・鼻からもう一度短く吸い足す(肺胞を再膨張させる一手)
・口からゆっくり長く吐き切る(吸う時間の倍以上が目安)
・これを5分間、繰り返す
私は5分×1ヶ月みたいに時間と期間を決めてやっていない。ストレスが襲ってきたときに単発で撃つ。速攻で筋肉の強張りが取れ、眉間の皺が取れる感覚がある。
それを1日の中に散りばめ、もう半年以上実践している。瞑想を試行錯誤していた時より余程安定している。
呼吸は単なる生存のための行為ではなく、ストレスをデバッグする強制介入だ。
もっと見る
AIエージェントをエンタープライズシステムに組み込むプラクティス
【非同期ジョブ+負荷制御】
💡 「全部リアルタイム」は破綻する。長時間処理をジョブ化し、優先度キューで負荷を制御すれば、スパイクにも耐えるエージェント基盤が手に入ります。
🔥 解決する課題
- 数十秒〜数分のエージェント処理でHTTPタイムアウトが発生する
- スパイク時に全ユーザーのレイテンシが悪化し、サービスが崩壊する
- 低優先度のバッチ処理がリアルタイム対話の品質を巻き添えにする
- LLM呼び出しコストがスパイク時に制御不能になる
🏗️ 提案パターン
リクエスト受信時にジョブIDを即時返却し、処理をバックグラウンドキューに投入します。進捗はSSE/WebSocketでストリーム通知し、完了時にWebhookやSlackでコールバックします。優先度キューでリアルタイム対話を最優先にし、バックグラウンド処理は後回しにします。さらに「オンライン知性」と「オフラインバッチ知性」を分離し、夜間バッチで大型モデルによる重い分析を実行、日中はその結果を即座に参照する構成が効果的です。
✅ 選定条件
- 向き:処理が数十秒超、大量並列処理、スパイクのあるマルチテナント環境
- 不向き:会話的・数秒で完結する対話(ジョブ化のオーバーヘッドが体験を損なう)
⚠️ 落とし穴
- DLQ(Dead Letter Queue)を用意しないと、失敗ジョブがサイレントに消える
- オフラインバッチの結果鮮度を管理しないと、古い分析結果で誤った判断を招く
- テナント別クォータを設けないと、特定テナントの暴走が全体に波及する
🛠️ 実装方針
1. メッセージキュー(SQS / RabbitMQ / Kafka)でジョブを受け付け、即座にジョブIDを返却するAPIを構築します
2. ワークフローエンジン(Temporal / AWS Step Functions)でジョブの進捗管理・リトライ・DLQを一元化します
3. 優先度キューでリアルタイム対話とバックグラウンド処理を分離し、テナント別クォータ(Token Bucket / Sliding Window)を設定します
4. SSE/WebSocketで進捗をストリーム通知し、完了時はWebhook/Slackコールバックで結果を届けます
5. 夜間バッチ(Airflow等)で大型モデルによる重い分析を実行し、結果ストア(Redis / DynamoDB)経由で日中のオンラインエージェントが即座に参照できるようにします
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る

# AIエージェントをエンタープライズシステムに組み込む意思決定ポイント
# プロンプト変更の統制|Prompt Change Control
🎯 ポイント
プロンプトは「ちょっとした言い回しの変更」に見えて、実はシステムの振る舞いを根本から変える「設定変更」です。コードのデプロイにはCI/CDとレビューがあるのに、プロンプトの変更は誰がいつ何を変えたか追えない——そんな状態で本番運用していませんか?プロンプト変更の統制は、すべてを同じ厳格さで管理するのではなく、本番影響度に応じてレベルを分けるのが現実解です🔑
📋 概要
プロンプト変更の統制は、エージェントのシステムプロンプトやツール定義の変更に対して、どの程度の承認・テスト・バージョン管理を求めるかを制御するダイヤルです。厳格にすれば再現性と安全性が上がりますが、開発速度が落ちます。緩めれば迅速な改善・実験が可能ですが、意図しない変更が本番に入るリスクが上がります。このダイヤルの要点は、プロンプトの構成要素ごとにリスクが異なるため、統制レベルも分けるべきだということです。システムプロンプトのロール定義とFew-shot例示では、求められる統制が全く違います📋
🔍 意思決定のポイント
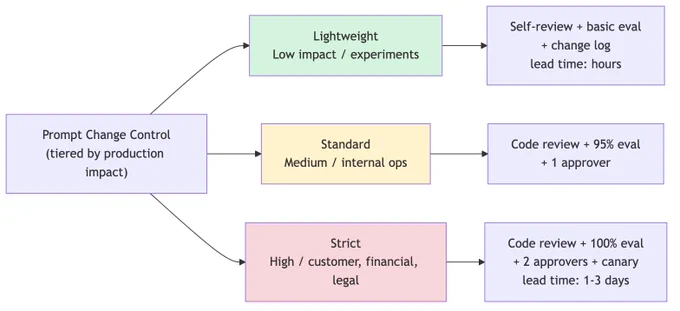
このダイヤルは「本番影響度」で3段階に分岐します。
高影響(顧客向け・金銭・法的)→ 厳格:コードレビュー+eval 100%通過+承認者2名+カナリアデプロイ
中影響(社内業務・広範囲)→ 標準:コードレビュー+eval 95%通過+承認者1名
低影響(内部実験・限定公開)→ 軽量:セルフレビュー+基本eval通過+変更ログ記録
さらにプロンプトの構成要素ごとに統制方針を分けます:
システムプロンプト(ロール・制約)→ 変更頻度は低いがリスクは高い。厳格に管理し設計判断として扱う
ツール定義(名前・説明・スキーマ)→ ツール選択精度に直結するため厳格に
Few-shot例示 → 中程度のリスク。evalで品質を確認する標準統制
コンテキスト注入テンプレート → 変更頻度が高くリスクは低〜中。軽量〜標準で対応
出力フォーマット指示 → リスクは低いが下流システムとの整合確認は必要⚡
💡 要点と詳細
統制の構成要素は5つです:
バージョン管理 — プロンプトをGitでコードと同様に管理します。差分の可視化と履歴の追跡が可能になります。「誰がいつ何を変えたか」が追跡できないと、将来の判断が困難になります。変更理由を必ず記録してください。
evalゲート — 変更後のプロンプトが既存のevalセットを通過することをデプロイの前提条件にします。evalの回帰検出率(プロンプト変更による品質低下を事前に検出できた割合)を計測し、検出できなかったケースはevalに追加して強化します。
承認プロセス — 影響度に応じた承認者のレビューです。厳格レベルでは同僚エンジニア+テックリードの2名。返金上限額など金銭に関わる記述変更は法務レビューも追加します。
カナリアデプロイ — 一部のトラフィック(目安10%)にのみ新プロンプトを適用し、24時間の品質指標を比較した上で全体展開します。A/Bテストの仕組みと共通化できます。
ロールバック手順 — 問題発生時に即座に前バージョンに戻せる仕組みです。Gitのリバートとデプロイパイプラインの連携が基本です🔬
計測すべき指標は5つ:プロンプト変更の頻度(環境ごと)、変更からデプロイまでのリードタイム(厳格レベルは1〜3営業日、軽量レベルは数時間以内が目標)、プロンプト変更起因の障害件数、evalの回帰検出率、ロールバック発生率です📈
⚖️ トレードオフ
開発速度優先(緩め)にすると、プロンプトの迅速な改善・実験が可能になりA/Bテストのサイクルが速まります。しかし「誰がいつ何を変えたか」が追跡できず、障害時に原因究明が困難になります。意図しない変更が本番に入り、品質低下やセキュリティ問題を引き起こすリスクがあります。特にシステムプロンプトのロール定義が知らないうちに変わっていた場合、影響範囲は全回答に及びます😰
再現性・安全優先(厳格)にすると、全変更が追跡可能で障害時の原因特定が容易になります。しかし変更の承認プロセスがボトルネックになり、改善のリードタイムが長くなります。小さな改善でも重い手続きが必要だとチームのモチベーションが下がり、「プロンプトを直したいけど面倒だからそのまま」という本末転倒な状態を生みます⚠️
対策は明確です:統制レベル自体を安易に下げるのではなく、evalの自動化・承認プロセスの並列化で変更リードタイムを短縮すること。そして実験環境と本番環境の統制レベルを明確に分け、実験の速度を本番の安全性と引き換えにしないことです。
🛠️ ユースケース
Zendesk顧客対応エージェント:システムプロンプトの変更はPM+エンジニアリードの承認必須。返金上限額の記述変更は法務レビューも追加。eval通過+カナリア(10%トラフィック×24時間)を経て全体展開。変更リードタイムは1〜3営業日です📞
Slack社内実験ボット:開発者がセルフレビューで変更可能。基本evalの通過は必須だが承認プロセスは省略。変更ログは自動記録され、問題発生時の原因追跡に使います。変更リードタイムは数時間以内です💬
Salesforce営業支援エージェント:ツール定義の追加・変更はコードレビュー必須。商談ステージの判定ロジックに影響するプロンプト変更はテックリードの承認が必要。大規模なプロンプト変更は段階的に実施し、影響範囲を限定します🎯
実践のコツ:初期は厳格寄りで運用を開始し、チームの習熟とevalの充実に応じて段階的に緩和してください。プロンプト変更起因の障害が発生したら、そのケースをevalに追加して再発防止を自動化する。そして大規模なプロンプト変更(ロール定義の書き換え等)は一度に行わず段階的に実施すること。一度に大きく変えると影響範囲の特定が困難になります💪
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る
# AIエージェントをエンタープライズシステムに組み込む意思決定ポイント
# temperature|Temperature
🎯 ポイント
temperatureを「とりあえず0.7」で全ステップ共通にしていませんか?
実はタスクの性質によって最適値は大きく異なり、1つのエージェント内でもステップごとに切り替えるのが正解です。意図分類は0、ツール選択は0〜0.1、回答生成は0.3〜0.5、アイデア出しは0.7〜1.0。この使い分けが品質と安定性を両立させる鍵です🎛️
📋 概要
temperatureはLLMの出力の確率分布をどの程度「なます」かを制御するパラメータです。高いほど多様で創造的な出力になり、低いほど再現性が高く決定論的な出力になります。エンタープライズのエージェント設計では、一律の設定ではなく、処理ステップの性質に応じたきめ細かい制御が求められます。「正確さが必要な場所」と「多様性が必要な場所」を明確に区別し、それぞれに適切な値を設定することで、品質の安定と表現の豊かさを同時に実現できます。
🔍 意思決定のポイント
このダイヤルは「タスクの性質」で決めます。
事実抽出・分類・判定・コード生成 → 低temperature(0〜0.2)。正確性と再現性が最優先
要約・報告書・顧客対応ドラフト → 中temperature(0.3〜0.7)。安定性と自然さのバランス
ブレインストーミング・バリエーション生成・創作 → 高temperature(0.7〜1.0)。多様性重視
重要なポイントとして、temperatureとtop_pを同時に大きく動かすと出力が不安定になります。片方を固定し片方で調整するのが基本です。また、本番とテストで同一のtemperature設定を使ってください。テスト時だけ0にすると、本番で初めて出力のぶれに気づくことになります⚡
💡 要点と詳細
エージェント内でのステップ別temperature設定の考え方:
意図分類ステップ — temperature=0。ここがぶれると後続の全処理が狂うため、決定論的に分岐させます。
情報検索・ツール選択ステップ — temperature=0〜0.1。正確なツール呼び出しが最優先です。
回答生成ステップ — temperature=0.3〜0.5。自然な文章だが安定した品質を維持します。
提案・アイデア出しステップ — temperature=0.7〜1.0。多様性を重視し、幅広い選択肢を提示します。
計測すべき指標は、出力一貫性(同一入力N回の一致率、分類タスクなら95%以上を目標)、幻覚率(事実と異なる記述の発生頻度)、ユーザー満足度(特に顧客対応の文面品質)、eval成功率の分散(temperatureが高いほどevalがぶれる)です📊
⚖️ トレードオフ
temperatureが高すぎると、出力のばらつきが大きくなり品質の安定性が下がります。幻覚(hallucination)の発生確率も上がる傾向があり、事実に基づく回答が求められるエンタープライズ用途では致命的です。同じ質問に対して毎回違う回答が返ってくるのは、業務システムとしては信頼を損ないます😰
一方、temperatureが低すぎると、表現が画一的になりユーザーに「機械的」と感じさせます。顧客対応の文面が毎回同じテンプレート感だと、パーソナライズされた対応を期待する顧客の満足度は下がります。また最適解以外の選択肢を探索できないため、局所最適に陥りやすくなります⚠️
🛠️ ユースケース
ServiceNow ITヘルプデスク:チケット分類(temperature=0)→ ナレッジ検索(0)→ 回答生成(0.3)の3段構成。分類と検索は正確性最優先、回答だけ自然な文章にする設計です。分類精度が不安定な場合、temperatureではなくプロンプトを改善してください📚
Shopify商品説明生成:商品属性の構造化抽出(0)→ 説明文の複数バリエーション生成(0.8)→ 品質チェック(0)。創造的な部分だけtemperatureを上げ、前後の構造化処理は決定論的に固定します🎯
Slackブレスト支援ボット:全ステップでtemperature=0.9。多様なアイデアを出すことが目的なので、安定性より多様性を全面的に優先します🔧
実践のコツ:まずtemperature=0でevalを作成しベースラインの品質を確認してから、必要に応じて上げてください。分類精度が不安定な場合はtemperatureを動かすのではなくプロンプト改善で対処し、顧客対応の文面が画一的と指摘されたら0.1〜0.2刻みで段階的に上げてください。幻覚率が許容範囲を超えたら、temperatureを下げるか事実検証ステップを挟むのが定石です💪
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る

AIエージェントをエンタープライズシステムに組み込むプラクティス
【シングル vs マルチエージェント】
💡 「全部入りの万能エージェント」を作ろうとしていませんか? その判断こそが、システムの成否を分ける最初の分岐点です。
🔥 解決する課題
- 単一エージェントではツール数や文脈窓の制約で複雑タスクに対応できない
- ドメインごとに異なる知識・権限・モデルを使い分けられない
- 独立タスクを直列処理して応答時間が肥大化する
- マルチ構成での副作用の競合リスクが制御不能になる
🏗️ 提案パターン
シングルエージェントは1つのLLMループが全ツールを持ち逐次処理します。ツール30個以下・単一目的・低レイテンシ要求なら最適解です。一方マルチエージェントはオーケストレータが専門ワーカーに委譲し、並列調査で時短を実現します。重要なのは「書き込みは1エージェントに集約し、他は読み取り専用」という副作用集約の原則です。コスト・レイテンシはマルチの場合シングルの数倍になる点を忘れずに。
✅ 選定条件
- 向き(シングル):単一目的、ツール少数、コスト敏感、デバッグ容易性重視
- 向き(マルチ):専門領域が分離可能、並列調査で時短、文脈窓が単一で破綻
- 不向き:副作用が多く競合リスクが高い処理をマルチで行うこと
⚠️ 落とし穴
- 「とりあえずマルチ」は複雑性・コスト・デバッグ難度を一気に上げる
- マルチ構成で複数エージェントが書き込むと競合・不整合が頻発する
- シングルで始めて、本当に破綻してからマルチに移行するのが安全
🛠️ 実装方針
1. まずシングルエージェントで構築し、ツール数・文脈窓・レイテンシの限界を実測します
2. マルチ化する場合はLangGraphやCrewAIでオーケストレータ/ワーカー構成を採用し、ワーカー間の通信は共有状態ストア(Redis等)で行います
3. 副作用の集約ルールとして「書き込みは1エージェントのみ、他は読み取り専用」をコード規約で強制します
4. A2A(Agent-to-Agent)プロトコルでエージェント間のインターフェースを標準化し、ワーカーの追加・入替を容易にします
5. シングル→マルチの移行判断基準(ツール数30超、文脈窓使用率80%超等)をダッシュボードで可視化します
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る

AIエージェントをエンタープライズシステムに組み込むプラクティス
【セマンティックレイヤー -- 組織知識グラフと指標定義の一元化】
💡 「売上を教えて」とAIに聞いたら、税込?税抜?受注ベース?入金ベース? -- 定義が曖昧なまま回答するAIは、正確に間違える最悪のツールです。指標と組織の「意味」を一元管理し、ハルシネーションを定義済みの事実で置き換えます。
🔥 解決する課題
- 数値/用語のハルシネーション:「売上」の定義が曖昧なまま回答し実際と異なる数値を生成する
- 指示語の解決不能:「私のチーム」「先月」等の曖昧な参照を正確に解決できない
- 組織階層スコープの欠如:部署・プロジェクトに応じたデータ範囲の制御ができない
🏗️ 提案パターン
BIのセマンティックレイヤー(dbt Semantic Layer / Cube等)でメトリクス定義を一元管理します。「売上 = 受注金額の税抜合計、期間はFY基準」のように厳密に定義します。組織グラフはSCIM/HRIS(Workday等)から同期し、「私のチームの売上」を「ユーザーの所属部署メンバーの受注金額合計」と自動解決します。自然言語の曖昧性をハルシネーションではなく定義済みの事実で解決する仕組みです。
✅ 選定条件
- 採用する場合:分析支援・組織横断の業務・権限依存の処理、指標や用語の定義が重要な業務
- 採用しない場合:定義が固まっていない探索的な領域(定義の整備が先)
⚠️ 落とし穴
- 定義の維持コスト:メトリクス定義と組織グラフの鮮度を保つ運用フローが必要です
- 定義の粒度:細かすぎると管理が破綻し、粗すぎると曖昧性が残ります。利用頻度の高い指標から段階的に整備します
- 組織変更への追従:部署再編・異動が頻繁な組織ではSCIM同期の頻度とタイミングが重要になります
🛠️ 実装方針
1. dbt Semantic Layer / Cubeでメトリクス定義(「売上 = 受注金額の税抜合計、期間はFY基準」等)を一元管理し、エージェントの第一級コンテキスト源として接続します
2. Workday / OktaからSCIM同期で組織グラフ(人・部署・プロジェクト・役職・権限)をNeo4j / Amazon Neptuneに構築します
3. 自然言語→定義済みメトリクス/関係へのマッピングレイヤーを実装し、「私のチームの売上」を「所属部署メンバーの受注金額合計」と自動解決します
4. 利用頻度の高い指標から段階的に定義を整備し、定義の鮮度を保つ定期レビューの運用フローを確立します
5. 組織グラフの変更検知(部署再編・異動)をSCIM同期のWebhookで即時反映し、スコープ制御の遅延を最小化します
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る

# AIエージェントをエンタープライズシステムに組み込む意思決定ポイント
# ツール露出数|Tool Exposure
🎯 ポイント
エージェントに使えるツールを「とりあえず全部渡す」設計になっていませんか?
実はLLMが一度に見渡せるツール数には認知的な限界があり、10〜20が安定ゾーン、30を超えると選択精度が有意に落ちます。ツールが多いほどモデルは「正しいツールを選ぶ」という認知負荷に晒され、誤選択やトークン浪費が増えていきます。SaaS連携が増えるエンタープライズ環境では、この制御が品質の生命線です🎛️
📋 概要
ツール露出数とは、エージェントに一度に見せるツール(関数・API)の数を制御する程度のことです。多すぎるとモデルの選択精度が落ち、少なすぎるとユーザーの要求に応えられません。「どんな要求にも対応できる」と「正確にツールを選べる」は本質的にトレードオフの関係にあり、業務ドメインやユースケースに応じて意図的に設計する必要があります。ツールの「量」だけでなく、ツール説明(description)の「質」も選択精度に直結する点を見落とさないでください。
🔍 意思決定のポイント
このダイヤルは「ツール数の規模」と「ツール説明の品質」の2軸で決めます。
ツール数が10〜20 → 静的定義で十分。グルーピングで管理可能
ツール数が20〜30 → ドメイン別のサブエージェント分割を検討
ツール数が30超 → Tool RAG(動的選択)またはルーター+サブエージェント+Tool RAGのハイブリッド構成が必須
ツール数を減らす前に、まずツール説明の品質を見直すことが重要です。名前が動詞+名詞で一意か、「いつ使うか・使わないか」が明記されているか、引数の型・制約・デフォルト値が明示されているか。ここが曖昧だとツールを絞っても誤選択は減りません⚡
💡 要点と詳細
ツール数が増えた場合の3つの対処パターンがあります:
Tool RAG(動的選択) — ユーザーの発話をベクトル検索し、関連ツール上位N件だけをプロンプトに注入します。SalesforceやServiceNowのようにAPIが数百に及ぶSaaS連携では必須に近い手法です。
サブエージェント分割 — 業務ドメインごとにサブエージェントを分け、ルーターが振り分けます。「人事系(Workday)」「ITヘルプデスク(ServiceNow)」「営業支援(Salesforce)」のように明確に分割できるケースで有効です。
ハイブリッド — ルーターでドメイン分割した上で、各サブエージェント内でもTool RAGを使う二段構成です。超大規模統合で採用されます。
計測すべき指標は、ツール選択正答率(正しいツールが呼ばれた割合)、ツール未選択率(適切なツールがあるのに「できません」と回答した割合)、誤選択によるエラー率、そしてツール説明のトークン消費量です。ツール説明がコンテキストの20%を超えたら、Tool RAGへの移行を本格検討してください📊
⚖️ トレードオフ
ツールを多く公開しすぎると、モデルの選択精度が低下します。名前や説明が似たツールが増えるほど誤選択の頻度が上がり、ツール説明のトークン消費がコンテキスト予算を圧迫します。ユーザーの要求に対応できる幅は広がりますが、「間違ったツールを選ぶ」リスクが確実に増大します😰
一方、ツールを絞りすぎると、ユーザーが「できるはずのこと」を断られる場面が増えます。体験品質が低下し、エージェント導入の価値が問われます。さらにツール追加のたびに分割設計の見直しが必要になり、開発速度も落ちます。重要なのは選択正答率90%を維持しつつ、fallback率5%以下を目指すバランスです⚠️
🛠️ ユースケース
Slack社内統合ボット:初期はITヘルプデスク(5ツール)から始め、HR・経費・施設と段階的に追加します。15ツールを超えた時点でTool RAGを導入し、選択精度を維持します。最終的に30ツール超の統合も、ルーター+Tool RAGのハイブリッドで安定運用できます📚
Zendesk顧客対応エージェント:FAQ検索・チケット作成・ステータス確認・エスカレーションの4ツールに絞り、選択精度95%以上を維持します。顧客対応では誤ったツール呼び出しが直接的な体験毀損につながるため、少数精鋭が正解です🎯
Jira+Confluence+GitHub開発支援:各サービス5〜8ツール、合計20前後。サービスごとにサブエージェントを分割し、ルーターが「これはJiraの話か、GitHubの話か」を判断して振り分けます。ツール追加は該当サブエージェント内で完結するため、他に影響を与えません🔧
実践のコツ:ツール選択正答率が90%を下回ったらツール数の削減かTool RAG導入を検討し、新ツール追加のたびに既存ツールとの名前・説明の重複をチェックしてください。調整は週次のeval結果をもとに行い、一度に大幅な変更は避けるのが安全です💪
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る
