検索結果 CICD
CICD コミュニティ
1つのキーワードが1つのコミュニティです。
アカウント
見つかりません
CICD を含む検索結果

# Claude Codeの機能と実践的な使い方
🚀 PRやIssueで「@/claude」とメンションするだけで、修正・実装・レビューが自動で走る。Claude CodeはCIの中で動くAI同僚になります。
📌 タイトルと機能のURL
タイトル: GitHub Actions
URL:
📝 概要
Claude Code GitHub Actionsは、Claude CodeをGitHubワークフローに統合する公式アクションです。任意のPRやIssueで「@/claude」とメンションすると、Claudeがコードを分析してプルリクエストを作成したり、機能を実装したり、バグを修正したりします。Claude Agent SDKの上に構築されており、定型作業の自動化に向いています。
🔧 機能の説明
・コメント内の「@/claude」メンションに応答するインタラクティブモードと、プロンプトを与えて即実行する自動化モードを、設定に応じて自動判別します。
・リポジトリルートのCLAUDE.mdを尊重し、プロジェクト標準やコードパターンに沿って動作します。
・コードはGitHubのランナー上で実行され、デフォルトでSonnetを使用します(Opus 4.8も指定可能)。
・直接Claude APIに加え、Amazon BedrockやGoogle Vertex AIでの利用にも対応します。
🛠 実践的な使い方
・最も簡単な導入は、ターミナルでclaudeを起動し「/install-github-app」を実行する方法です。GitHubアプリとシークレットの設定をガイドしてくれます(リポジトリ管理者権限が必要)。
・手動セットアップでは、Claude GitHubアプリ(
・アクションは「anthropics/claude-code-action@v1」を使用します。「prompt」で指示を、「claude_args」でCLI引数を渡せます。
・claude_argsの例: --max-turns 5 / --model claude-sonnet-4-6 / --mcp-config /path/to/config.json
・コメント例: 「@/claude implement this feature based on the issue description」「@/claude fix the TypeError in the user dashboard component」
🎯 ユースケース
・IssueにメンションしてそのままPRを自動作成し、要件をコードに落とし込む。
・PR上で「@/claude このセキュリティ問題をレビューして」と定型レビューを依頼する。
・schedule(cron)トリガーで、前日のコミットやオープンIssueの日次サマリーを自動生成する。
・code-reviewプラグインを組み込み、PRの更新ごとにスキルを自動実行する。
⚠️ 注意点
・APIキーは絶対にリポジトリに直接コミットせず、必ずGitHub Secrets(secrets.ANTHROPIC_API_KEY)で参照してください。
・GitHub Actionsの実行時間とAPIトークンの両方でコストが発生します。--max-turnsやタイムアウトで暴走を防ぎましょう。
・反応しない場合は、コメントが「/claude」ではなく「@/claude」になっているか、アプリ導入とシークレット設定を確認します。
・v1.0はベータから破壊的変更があり、mode削除・direct_prompt→prompt・各CLIオプションのclaude_args移行が必要です。
#ClaudeCode# #CICD#
もっと見る

「CI/CDのYAML、もう手で書きたくない」——その願いを叶えにきた研究です⚙️ 自然言語の説明から、リポジトリに合ったパイプラインを自動生成します。
タイトル: AutoPipelineAI: Context-Aware CI/CD Pipeline Generation from Natural Language
URL:
⚙️ 概要
本研究は、自然言語の説明からCI/CDパイプライン構成を自動生成するシステム「AutoPipelineAI」を提案しています。LLMを活用し、リポジトリの構造を解析したうえで、GitHub ActionsやGitLab CI/CD向けのプラットフォーム固有スクリプトを生成し、検証とフィードバックで品質を担保します。
❓ 解決する課題
現代の開発では、テストやデプロイを自動化するCI/CDパイプラインが欠かせませんが、その設定は難しく時間のかかる作業です。
・GitHub ActionsやGitLab CI/CDなど、プラットフォームごとに異なる構文を理解する必要があります
・その複雑さが設定ミスや生産性の低下を招きます
・特にDevOps経験の浅い開発者にとっては、大きな参入障壁になっていました
💡 方法論と提案手法
AutoPipelineAIは、3つの主要コンポーネントで構成されます。
・リポジトリ認識型の解析:プロジェクト構造を分析し、どんな言語・依存・構成かという文脈を理解します
・LLMによる変換:開発者の自然言語による意図を、対象プラットフォーム固有の構成へ翻訳します
・自動検証とフィードバック:生成したパイプラインの正確さと使いやすさを確認し、必要に応じて修正します
単に文章をYAMLに変換するのではなく、リポジトリの文脈を取り込んでターゲット環境に合った構成を作る点が「Context-Aware(文脈認識)」たる所以です。
🌍 ユースケース / 実験結果
評価は、実務に直結する観点で行われました。
・precision(精度)指標
・構成の妥当性(configuration validity)
・手作業に対する労力削減(effort reduction)
これらを通じて、「リポジトリ認識・自然言語駆動のCI/CD生成が、実用的で有望なパラダイムである」という初期的な証拠が示されました。DevOps専任がいない小規模チームのオンボーディングコストを下げる効果が期待されます。
#CICD# #DevOps#
もっと見る


【インフラ構築やCI/CDの認知負荷を、GKE AutopilotとPlatform Engineeringで低減】
#GKE# #findy_tools#
🔗


技術書を写経するコスパの良さを感じている。『GitHub CI/CD実践ガイド』という書籍を3周したんだけど、CI/CDを完全に極めた。
そんな勘違いをしたくなるくらい、「理解できてる感」「操れてる感」が爆発的に高まっているので自分でもびっくり。
今までAIでワークフローファイルを読み書きする時は、説明とコードを照らし合わせて、どこがどう対応してるかを理解するのに時間がかかっていた。
だけど今は出力を見て「あーはいはい、そういうことね」とスッと頭に入ってくる。3周もしたのでさすがに見覚えのある記述ばかり。
理解すること自体にエネルギーを割かなくて済む分、出力に対して疑問や違和感を持つだけの余裕が生まれた。
普段はAIにコードを書かせるとしても、自分で手を動かして慣れておくことには大きな意味があるな。
基礎的な理解に使う思考体力を温存できるので、その分もっと高度なことを考えられる。
もっと見る

AIによる開発効率化を提案する場面があったんだけど、現状を聞けば聞くほど「AI以前の提案」ばかりになってしまう。テストコードやCI/CDの整備、権限の設定など。
AIに大胆に仕事を任せるためにも、決定的に制御できる部分はAIではなく仕組みとして固めておきたい。
でも、AIどころかIT全然わかってないですみたいな人たちからすると、そこら辺も丸っとAIにお任せできるイメージを持っているようで、提案が期待値を下回ってしまう申し訳ない感じになってしまった。
エンジニアの自分からすると、AIによって開発の進め方がガラッと変わって、まさに革命が起きている感覚がある。
だけど、AIをガチの魔法だと思っている人にとっては、まだまだなんだなと。
もっと見る
# AIエージェントをエンタープライズシステムに組み込む意思決定ポイント
# プロンプト変更の統制|Prompt Change Control
🎯 ポイント
プロンプトは「ちょっとした言い回しの変更」に見えて、実はシステムの振る舞いを根本から変える「設定変更」です。コードのデプロイにはCI/CDとレビューがあるのに、プロンプトの変更は誰がいつ何を変えたか追えない——そんな状態で本番運用していませんか?プロンプト変更の統制は、すべてを同じ厳格さで管理するのではなく、本番影響度に応じてレベルを分けるのが現実解です🔑
📋 概要
プロンプト変更の統制は、エージェントのシステムプロンプトやツール定義の変更に対して、どの程度の承認・テスト・バージョン管理を求めるかを制御するダイヤルです。厳格にすれば再現性と安全性が上がりますが、開発速度が落ちます。緩めれば迅速な改善・実験が可能ですが、意図しない変更が本番に入るリスクが上がります。このダイヤルの要点は、プロンプトの構成要素ごとにリスクが異なるため、統制レベルも分けるべきだということです。システムプロンプトのロール定義とFew-shot例示では、求められる統制が全く違います📋
🔍 意思決定のポイント
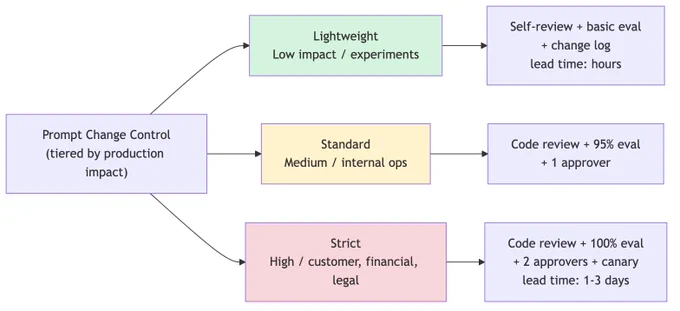
このダイヤルは「本番影響度」で3段階に分岐します。
高影響(顧客向け・金銭・法的)→ 厳格:コードレビュー+eval 100%通過+承認者2名+カナリアデプロイ
中影響(社内業務・広範囲)→ 標準:コードレビュー+eval 95%通過+承認者1名
低影響(内部実験・限定公開)→ 軽量:セルフレビュー+基本eval通過+変更ログ記録
さらにプロンプトの構成要素ごとに統制方針を分けます:
システムプロンプト(ロール・制約)→ 変更頻度は低いがリスクは高い。厳格に管理し設計判断として扱う
ツール定義(名前・説明・スキーマ)→ ツール選択精度に直結するため厳格に
Few-shot例示 → 中程度のリスク。evalで品質を確認する標準統制
コンテキスト注入テンプレート → 変更頻度が高くリスクは低〜中。軽量〜標準で対応
出力フォーマット指示 → リスクは低いが下流システムとの整合確認は必要⚡
💡 要点と詳細
統制の構成要素は5つです:
バージョン管理 — プロンプトをGitでコードと同様に管理します。差分の可視化と履歴の追跡が可能になります。「誰がいつ何を変えたか」が追跡できないと、将来の判断が困難になります。変更理由を必ず記録してください。
evalゲート — 変更後のプロンプトが既存のevalセットを通過することをデプロイの前提条件にします。evalの回帰検出率(プロンプト変更による品質低下を事前に検出できた割合)を計測し、検出できなかったケースはevalに追加して強化します。
承認プロセス — 影響度に応じた承認者のレビューです。厳格レベルでは同僚エンジニア+テックリードの2名。返金上限額など金銭に関わる記述変更は法務レビューも追加します。
カナリアデプロイ — 一部のトラフィック(目安10%)にのみ新プロンプトを適用し、24時間の品質指標を比較した上で全体展開します。A/Bテストの仕組みと共通化できます。
ロールバック手順 — 問題発生時に即座に前バージョンに戻せる仕組みです。Gitのリバートとデプロイパイプラインの連携が基本です🔬
計測すべき指標は5つ:プロンプト変更の頻度(環境ごと)、変更からデプロイまでのリードタイム(厳格レベルは1〜3営業日、軽量レベルは数時間以内が目標)、プロンプト変更起因の障害件数、evalの回帰検出率、ロールバック発生率です📈
⚖️ トレードオフ
開発速度優先(緩め)にすると、プロンプトの迅速な改善・実験が可能になりA/Bテストのサイクルが速まります。しかし「誰がいつ何を変えたか」が追跡できず、障害時に原因究明が困難になります。意図しない変更が本番に入り、品質低下やセキュリティ問題を引き起こすリスクがあります。特にシステムプロンプトのロール定義が知らないうちに変わっていた場合、影響範囲は全回答に及びます😰
再現性・安全優先(厳格)にすると、全変更が追跡可能で障害時の原因特定が容易になります。しかし変更の承認プロセスがボトルネックになり、改善のリードタイムが長くなります。小さな改善でも重い手続きが必要だとチームのモチベーションが下がり、「プロンプトを直したいけど面倒だからそのまま」という本末転倒な状態を生みます⚠️
対策は明確です:統制レベル自体を安易に下げるのではなく、evalの自動化・承認プロセスの並列化で変更リードタイムを短縮すること。そして実験環境と本番環境の統制レベルを明確に分け、実験の速度を本番の安全性と引き換えにしないことです。
🛠️ ユースケース
Zendesk顧客対応エージェント:システムプロンプトの変更はPM+エンジニアリードの承認必須。返金上限額の記述変更は法務レビューも追加。eval通過+カナリア(10%トラフィック×24時間)を経て全体展開。変更リードタイムは1〜3営業日です📞
Slack社内実験ボット:開発者がセルフレビューで変更可能。基本evalの通過は必須だが承認プロセスは省略。変更ログは自動記録され、問題発生時の原因追跡に使います。変更リードタイムは数時間以内です💬
Salesforce営業支援エージェント:ツール定義の追加・変更はコードレビュー必須。商談ステージの判定ロジックに影響するプロンプト変更はテックリードの承認が必要。大規模なプロンプト変更は段階的に実施し、影響範囲を限定します🎯
実践のコツ:初期は厳格寄りで運用を開始し、チームの習熟とevalの充実に応じて段階的に緩和してください。プロンプト変更起因の障害が発生したら、そのケースをevalに追加して再発防止を自動化する。そして大規模なプロンプト変更(ロール定義の書き換え等)は一度に行わず段階的に実施すること。一度に大きく変えると影響範囲の特定が困難になります💪
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る
# ADKの便利で実践的な使い方
🧪 エージェントのプロンプトを変更したら、品質が下がっていないか確認していますか?ADKのEvaluation機能を使えば、テストファイル方式とデータセット方式の2つのアプローチでエージェントの品質を体系的に検証できます。CIに組み込めば、プロンプト変更の回帰テストも自動化できます。
📌 タイトル:Evaluation 概要
🔗 URL:
🧩 概要
ADKは、エージェントのパフォーマンスを評価するための2つの主要な方法を提供します。**テストファイル方式**は`.test.json`ファイルに単一セッション(複数ターン可)を記述し、ユニットテストのように高速に反復できます。**Evalset方式**は複数セッション・多数のターンを含む統合テスト向けです。一部の評価基準(レスポンス品質、安全性、マルチターン品質など)はVertex Gen AI Evaluation Service APIを必要とします。評価基準として`tool_trajectory_avg_score`、`response_match_score`、`hallucinations_v1`、`safety_v1`などの組み込みメトリクスが利用可能です。
🛠 使い方
テストファイルには、ユーザークエリ、期待されるツール使用軌跡、期待されるレスポンスを記述します。
評価の実行方法は3つあります。
**Web UI**での対話的な評価:
```bash
adk web path/to/agents_dir
```
**pytest**との統合:
`AgentEvaluator.evaluate()` を `await` で呼び出し、`agent_module` に評価対象のエージェントモジュール名(例: `"home_automation_agent"`)、`eval_dataset_file_path_or_dir` にテストファイルのパス(例: `"tests/integration/fixture/test.test.json"`)を指定します。
**CLI**での実行:
```bash
adk eval --config_file_path=
```
評価基準のしきい値は`test_config.json`で設定します。
```json
{
"criteria": {
"tool_trajectory_avg_score": 1.0,
"response_match_score": 0.8
}
}
```
デフォルトでは、ツール軌跡は100%一致を要求し、レスポンスマッチングは80%の類似度を許容します。
🏗 実践的な使い方
**エージェント更新時の回帰テスト**: プロンプトやツール定義を変更するたびに、既存のテストファイルを使って回帰テストを実行します。`tool_trajectory_avg_score`でツール選択の正確性を、`response_match_score`でレスポンスの品質を定量的に検証できます。品質低下を早期に検出できるため、安心してプロンプトの改善を繰り返せます。
**テストファイル方式で高速イテレーション**: 開発中は`.test.json`ファイルを使ったユニットテスト的なアプローチが最適です。単一セッションの期待値を記述し、pytestで自動実行すれば、コード変更のたびに数秒で品質を確認できます。エッジケースごとにテストファイルを追加していくことで、テストカバレッジを段階的に拡充できます。
**データセット方式でバッチ評価**: 本番に近い複雑なシナリオは、Evalset方式で多数のセッションをまとめて評価します。マルチターンの会話フローや、異なるユーザーパターンを網羅的にテストでき、統合テストとして機能します。
**CIパイプラインへの統合**: `adk eval`コマンドをCIに組み込めば、プロンプト変更のプルリクエストごとに自動で品質チェックが実行されます。しきい値を下回った場合はCIを失敗させることで、品質低下したプロンプトのマージを防げます。
💡 ユースケース
🔄 プロンプト変更時の回帰テスト自動化
⚡ テストファイル方式での高速な開発イテレーション
📊 データセット方式での網羅的なバッチ評価
🔗 CI/CDパイプラインへの品質ゲート統合
⚠️ 注意点
- 一部の評価基準(レスポンス品質、安全性、マルチターン品質など)はVertex Gen AI Evaluation Service API(有料のGoogleサービス)が必要です。
- テストファイルのしきい値は厳しすぎると偽陰性が増え、緩すぎると品質低下を見逃します。初期値から段階的に調整してください。
- LLMベースの評価基準(`hallucinations_v1`など)はジャッジモデルの判断にばらつきがあるため、`num_samples`で複数回サンプリングすることを推奨します。
✨ ADKのEvaluation機能を活用すれば、エージェントの品質管理を「感覚」から「定量的な基準」に変えられます。まずはテストファイル方式で始めて、CI統合へと進めてみてください!
#ADK# #AIAgent#
もっと見る

# AIエージェント開発の意思決定ポイント
🎯 ポイント
税額計算をLLMにやらせていませんか?
AIエージェント開発で最もよくある間違いの一つは、コードで一瞬で解ける処理をLLMに推論させてしまうことです。トークンの浪費、結果の不安定、デバッグ困難。逆に、自然言語の解釈まで全部if-elseで書こうとして、エッジケースの爆発に溺れるのも同じくらい危険。LLMとコード、どちらに任せるかの線引きを明確にしましょう。
📋 概要
AIエージェントの各処理ステップについて「LLMに自然言語で推論させるか、従来のコードやツールに委譲するか」という設計判断です。LLMは確率的で同じ入力に異なる出力を返す可能性がありますが、曖昧な入力の解釈や未知のケースへの対応に優れます。コードは決定論的で常に同じ結果を返し、テストも容易ですが、事前に想定していないケースには対応できません。この非対称性を正しく活用することが、信頼性とコスト効率を決定づけます。
🔍 意思決定のポイント
判定のヒューリスティックは単純です:「if-elseで書けるか?」
📌 ルール・手順・アルゴリズムで完全に記述できる → コードに委譲。税額計算、在庫集計、日付比較、スキーマ検証、フォーマット変換。これらをLLMに任せるのはトークンの浪費であり、しかも誤る可能性があります。LLMは算術演算や正確な文字列操作が苦手です。
📌 入力が自然言語で意図の解釈が必要 → LLMに推論させる。ユーザーの曖昧な要求を構造化する処理はLLMの得意分野。「明日の会議をリスケして」の「明日」がいつで「リスケ」が何を意味するかの解釈はif-elseでは対応しきれません。
📌 分類のカテゴリが動的に変わる、判断基準が文脈依存 → LLM。事前にすべてのケースを列挙できない場合、コードではエッジケースの爆発が起きます。
📌 生成・要約・翻訳など創造性を伴う処理 → LLM。これらはコードでは実現できません。
📌 計算結果の誤りが許されない → コード必須。金融計算、権限判定、在庫管理。確率的なLLMに任せるべきではありません。
💡 要点と詳細
🔹 LLMは「何をすべきか」の判断に優れ、コードは「どうやるか」の実行に優れます。この非対称性がエージェントシステムの設計原則です。LLMが計画・分類・解釈を担当し、コードが計算・検証・実行を担当する分業が最も一般的で効果的な構成です。
🔹 見極めの基準は「入力が決まれば出力が一意に決まるか」です。一意に決まるなら、それはコードの仕事です。計算、検索、フォーマット変換、バリデーション、データベース操作はすべてコードに分類されます。
🔹 LLMに任せすぎた場合の典型症状:同じ入力で異なる結果が返り「前回と結果が違う」というクレーム。トークン消費量が想定を大幅超過し、分析するとコードで代替可能な処理に費やされている。テストのフレーク率が高くCI/CDが不安定。
🔹 コードに任せすぎた場合の典型症状:新しいタイプのリクエストが来るたびに分類ルールやパーサーの追加が必要で開発速度が低下。if-elseの積み重ねが肥大化し保守困難。想定外の入力に一律エラーを返し、本来対応可能な要求を棄却。
⚖️ トレードオフ
LLMは柔軟性と汎用性を得る代わりに、再現性・コスト・デバッグ容易性を犠牲にします。コードは決定論性と効率性を得る代わりに、柔軟性を犠牲にし、新しいケースへの対応にコード追加が必要です。
🏆 デフォルトは「決定論的に解ける処理はコードに委譲」。LLMはコストが高く、結果が不安定で、デバッグが困難です。LLMに任せるのは「コードでは解けない」処理に限定するのが原則。これは「確率的な判断をLLMに、決定論的な制御をコードに」という設計思想の根幹です。
🛠️ ユースケース
🧮 経費精算ボット → ハイブリッド。領収書画像からの情報抽出と経費カテゴリの判定はLLM。税額計算、合計算出、経費規定との照合はコード。
🔍 カスタマーサポート → ハイブリッド。ユーザーの問い合わせ意図の分類はLLM。注文状況の検索、返金処理の実行、在庫確認はコード(API/DB呼び出し)。
📊 データ分析アシスタント → ハイブリッド。「先月の売上を地域別に比較して」の意図解釈はLLM。実際のクエリ生成・実行・集計はコード。結果の要約と解釈はLLM。
⚠️ アンチパターン:LLMに「123 × 456を計算して」と聞く。LLMは算術が苦手で間違えることがあります。こんな処理は`123 * 456`の1行で確実に正解が出ます。
#AIエージェント# #ソフトウェアアーキテクチャ#
もっと見る

# AIエージェント開発の意思決定ポイント
🎯 ポイント
税額計算をLLMにやらせていませんか?
AIエージェント開発で最もよくある間違いの一つは、コードで一瞬で解ける処理をLLMに推論させてしまうことです。トークンの浪費、結果の不安定、デバッグ困難。逆に、自然言語の解釈まで全部if-elseで書こうとして、エッジケースの爆発に溺れるのも同じくらい危険。LLMとコード、どちらに任せるかの線引きを明確にしましょう。
📋 概要
AIエージェントの各処理ステップについて「LLMに自然言語で推論させるか、従来のコードやツールに委譲するか」という設計判断です。LLMは確率的で同じ入力に異なる出力を返す可能性がありますが、曖昧な入力の解釈や未知のケースへの対応に優れます。コードは決定論的で常に同じ結果を返し、テストも容易ですが、事前に想定していないケースには対応できません。この非対称性を正しく活用することが、信頼性とコスト効率を決定づけます。
🔍 意思決定のポイント
判定のヒューリスティックは単純です:「if-elseで書けるか?」
📌 ルール・手順・アルゴリズムで完全に記述できる → コードに委譲。税額計算、在庫集計、日付比較、スキーマ検証、フォーマット変換。これらをLLMに任せるのはトークンの浪費であり、しかも誤る可能性があります。LLMは算術演算や正確な文字列操作が苦手です。
📌 入力が自然言語で意図の解釈が必要 → LLMに推論させる。ユーザーの曖昧な要求を構造化する処理はLLMの得意分野。「明日の会議をリスケして」の「明日」がいつで「リスケ」が何を意味するかの解釈はif-elseでは対応しきれません。
📌 分類のカテゴリが動的に変わる、判断基準が文脈依存 → LLM。事前にすべてのケースを列挙できない場合、コードではエッジケースの爆発が起きます。
📌 生成・要約・翻訳など創造性を伴う処理 → LLM。これらはコードでは実現できません。
📌 計算結果の誤りが許されない → コード必須。金融計算、権限判定、在庫管理。確率的なLLMに任せるべきではありません。
💡 要点と詳細
🔹 LLMは「何をすべきか」の判断に優れ、コードは「どうやるか」の実行に優れます。この非対称性がエージェントシステムの設計原則です。LLMが計画・分類・解釈を担当し、コードが計算・検証・実行を担当する分業が最も一般的で効果的な構成です。
🔹 見極めの基準は「入力が決まれば出力が一意に決まるか」です。一意に決まるなら、それはコードの仕事です。計算、検索、フォーマット変換、バリデーション、データベース操作はすべてコードに分類されます。
🔹 LLMに任せすぎた場合の典型症状:同じ入力で異なる結果が返り「前回と結果が違う」というクレーム。トークン消費量が想定を大幅超過し、分析するとコードで代替可能な処理に費やされている。テストのフレーク率が高くCI/CDが不安定。
🔹 コードに任せすぎた場合の典型症状:新しいタイプのリクエストが来るたびに分類ルールやパーサーの追加が必要で開発速度が低下。if-elseの積み重ねが肥大化し保守困難。想定外の入力に一律エラーを返し、本来対応可能な要求を棄却。
⚖️ トレードオフ
LLMは柔軟性と汎用性を得る代わりに、再現性・コスト・デバッグ容易性を犠牲にします。コードは決定論性と効率性を得る代わりに、柔軟性を犠牲にし、新しいケースへの対応にコード追加が必要です。
🏆 デフォルトは「決定論的に解ける処理はコードに委譲」。LLMはコストが高く、結果が不安定で、デバッグが困難です。LLMに任せるのは「コードでは解けない」処理に限定するのが原則。これは「確率的な判断をLLMに、決定論的な制御をコードに」という設計思想の根幹です。
🛠️ ユースケース
🧮 経費精算ボット → ハイブリッド。領収書画像からの情報抽出と経費カテゴリの判定はLLM。税額計算、合計算出、経費規定との照合はコード。
🔍 カスタマーサポート → ハイブリッド。ユーザーの問い合わせ意図の分類はLLM。注文状況の検索、返金処理の実行、在庫確認はコード(API/DB呼び出し)。
📊 データ分析アシスタント → ハイブリッド。「先月の売上を地域別に比較して」の意図解釈はLLM。実際のクエリ生成・実行・集計はコード。結果の要約と解釈はLLM。
⚠️ アンチパターン:LLMに「123 × 456を計算して」と聞く。LLMは算術が苦手で間違えることがあります。こんな処理は`123 * 456`の1行で確実に正解が出ます。
#AIエージェント# #ソフトウェアアーキテクチャ#
もっと見る