
Jimmy狐狸
@jimmyhuli
Vibe Investing & Vibe Coding
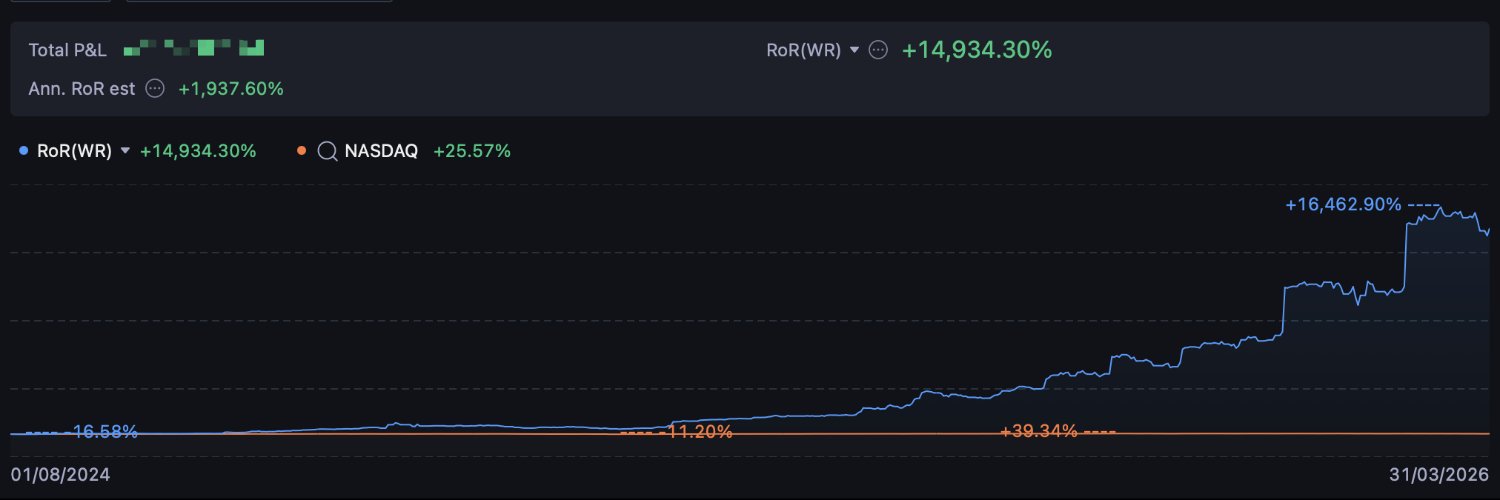
两年30倍,投资、分享美股的成长科技股
个人Substack: ,公众号:Jimmy狐狸
交流群持续开放,关注我发私信拉入群
我没有 WhatsApp,请务必留意诈骗账号
가입 April 2010
850 팔로잉 중 24.1K 팬
$NVDA $MRVL
AI Hyperscalers 已从"建设"阶段转入"变现"阶段,瓶颈随之转移。关键不再是有多少算力,而是每瓦电能跑出多少 token。
Memory wall 在扩大,不是在收窄:
- 过去 20 年,Peak FLOPs 每两年 +3x,但 memory bandwidth 只 +1.6x,capacity 只 +2x
- $NVDA Rubin 相比 Blackwell 推理算力 +5x,但 HBM bandwidth 只涨 2.8x,memory 仍是硬约束,且代际间差距没有收窄
HBM 成本持续攀升加剧了这个矛盾:
- HBM 占 B200 BOM 约 52%,Rubin 预计升至 62%,192 GB HBM 系统成本 $20 万以上,是等量 DDR5 的 5 倍以上
- Hyperscaler 数据中心 PUE 已接近物理极限(1.09–1.17),外围效率优化空间几乎耗尽
解法指向 offload engine:把 KV cache 卸载到更便宜的内存层,让 XPU 保持满载,而不是继续堆昂贵的 HBM。
Nvidia 内部数据:Vera Rubin NVL72 + Groq 3 LPX rack 相比 GB200 NVL72,每 MW token 吞吐量高 35x。
这直接利好 $MRVL:server DDR5 定价已升至约 $40/GB,DRAM-based CXL offload 相比堆 HBM 有明显成本优势,Marvell 的 CXL + custom silicon 正处在这个受益位置。
两条技术路径即将分叉: $NVDA 推 proprietary CMX,开放生态走 CXL(vendor-neutral)。
非投资建议!不是让你现在就买 MRVL
더 보기







