検索結果 検索基盤
検索基盤 コミュニティ
1つのキーワードが1つのコミュニティです。
アカウント
見つかりません
検索基盤 を含む検索結果

TL;DR Uber Freightは、40超のマイクロサービスと約100のデータソースにまたがる検索を、「所有者が違うフラグメントを1つのインデックスに合成する」設計で支えています。
タイトル: Freight Search: Composing a Shared Search Index from Independently Owned Fragments
URL:
ポイント
・🧩 インデックスの各フィールドは、ちょうど1つのフラグメント由来で、所有が衝突しない
・🧱 フラグメントを1つの非正規化ドキュメントに統合し、クエリ時のjoinが不要
・⚙️ ブートストラップはSpark、ライブ取り込みはFlinkとCDCで、変更は数秒で反映
・🏷 Javaのアノテーションからマッピングを生成し、クラスが唯一の情報源
・🔗 @/LinkedEntityとfold関数を宣言すれば、親子の非正規化や1:N集約もプラットフォームが処理
・🔄 SIAからOpenSearchへの移行も、数か所の変更で全エンティティに適用
・📈 約300フラグメント、20超のインデックスで、毎秒数千クエリ、p99は数百ミリ秒
業務の定義とプラットフォームの境界を分けたことが、エンジン移行まで耐えた鍵だと感じます。
#Uber# #検索基盤#
もっと見る

🔎 フロンティアモデルの賢さだけでは本番AIは動かない。権限・監査つきで企業データを正確に引き出す検索基盤と組み合わせて初めて回ります。
TL;DR: ElasticとOpenAIが提携拡大。Elasticsearchを権限対応の永続メモリ層にして、エージェント・オブザーバビリティ・セキュリティを一気に強化します。
タイトル: Elastic and OpenAI collaborate to bring frontier intelligence to unstructured enterprise data
URL:
ポイント
🧠 Elasticsearchを永続メモリ層に(レキシカル+ベクトル+再ランキング+アクセス制御)
🎯 Knowledge Indicatorの事前計算で入力トークン最大75%削減、回答精度60→92%
🔒 社内テストでリコール0.89、ユーザー間のデータ完全保護
🛡 Attack Discoveryがアラートを攻撃チェーンに相関、MITRE ATT&CKへマッピング
⚡ Visaはトリアージを10〜20分→数秒、Airtelは分析最大40%・調査30%高速化
🔌 Agent BuilderはMCP経由でスキル公開、Splunk/QRadarルールの移行にも対応
賢さ+検索基盤+ガバナンスが揃って本番AIになる、という現実的な設計だと感じます。
#Elasticsearch# #OpenAI#
もっと見る

🔬 「50人のチームが手元にいて、1日で全部やってくれる感覚」。Geminiベースのマルチエージェントが科学仮説を生成・討論・進化させ、肝線維症の瘢痕応答を91%ブロックする薬剤候補まで導きました。
タイトル: Co-Scientist: A multi-agent AI partner to accelerate research
URL:
📝 概要
Co-Scientistは、Geminiを基盤とする協調型のマルチエージェントAIで、新規の科学仮説を生成・批評・洗練します。仮説の生成と評価のサイクルを自動化することで、ブレイクスルーの発見を加速する「AI研究パートナー」として機能します。
❓ 解決する課題
研究者は、情報過多とますます複雑化する課題の中で、ブレイクスルーとなる仮説を立てるのに苦労します。膨大な文献にまたがる断片的な事実を結びつけ、有望な研究方向を特定するのが難しいのです。
💡 方法論と提案手法
3つのフェーズに専門エージェントを配置します。
・生成フェーズ:Generationエージェントが文献とデータに基づき新規仮説を提案し、Proximityエージェントが仮説をクラスタ化して多様な探索を確保します
・討論フェーズ:Reflectionエージェントが「仮想ピアレビュア」として批判的に評価し、Rankingエージェントがペアワイズ比較とEloベースのトーナメントで優先順位付けします
・進化フェーズ:Evolutionエージェントが上位仮説を継続的に洗練・結合し、Meta-reviewエージェントが最終的な研究提案を統合します
・計算資源の大半を「検証」に充て、主張をChEMBLやUniProt、Web検索、AlphaFoldなどの専門ツールと突き合わせます
🎯 ユースケース
抗菌薬耐性、植物免疫、肝線維症の治療発見、ALSの機序探索、細胞老化の逆転、感染症タンパク質の特定、代謝疾患、老化生物学など、幅広い生命科学領域に応用されています。
📊 実験結果
・肝線維症で、瘢痕に関連する応答の91%をブロックする薬剤候補を特定しました
・細胞老化では、実験室で細胞を若返らせる遺伝的リードを生成し、スクリーニング解析を数ヶ月から数日に短縮しました
・100以上の研究機関がテストし、Stanford、MIT、Cambridge、Calicoなどが協力しています
・第一三共やBayer Crop Science、米国の国立研究所にエンタープライズ版が展開されています
#AIforScience# #AIエージェント#
もっと見る

# AIエージェント開発の意思決定ポイント
🎯 ポイント
LLMにドメイン知識を与えたい。RAG?ファインチューニング?ロングコンテキスト?
「とりあえずRAGで」と思考停止していませんか?この三択、実は知識の性質によって最適解がまったく異なります。選び間違えると、古い情報で回答し続けたり、出典を示せなかったり、トークンコストが爆発したり。正しく選ぶための判断軸を整理しましょう。
📋 概要
AIエージェントにドメイン固有の知識を持たせる方法は大きく3つあります。RAG(検索拡張生成)はベクトルDBなどから関連情報を検索してプロンプトに注入する方式。ファインチューニング(FT)はモデルの重みを追加学習で調整して知識を焼き込む方式。ロングコンテキストは大きなコンテキスト窓にドキュメントをそのまま投入する方式です。それぞれ知識の格納場所・更新サイクル・コスト構造が根本的に異なるため、ユースケースに応じて主軸を1つ選ぶ必要があります。
🔍 意思決定のポイント
判断の核心は「知識がどのくらいの頻度で変わるか」と「出典の明示が必要か」です。
📌 知識の鮮度が命なら → RAG一択。FAQや価格、在庫情報など頻繁に変わるデータは、インデックスを更新するだけで即座に反映されます。FTでは再学習に日〜週単位かかり、現実的ではありません。
📌 出典を示す必要があるなら → これもRAG。「この回答の根拠はどのドキュメントの何ページか」を提示できるのはRAGだけです。FTで焼き込んだ知識は「モデルがそう知っている」状態であり、事後に追跡不可能。説明責任が求められる環境では致命的です。
📌 出力の様式・口調を統一したいなら → FT。「常に法務文書の形式で出力する」のようなスタイルの一貫性は、RAGで例を注入しても安定しません。FTでモデルレベルに染み込ませることで、推論時の例示注入が不要になり、コンテキスト窓の節約にもなります。
📌 少数の文書を丸ごと理解させたいなら → ロングコンテキスト。契約書全体の解釈のように文書構造が重要な場合、チャンク分割で文脈が断絶するRAGよりも、全文をそのまま投入する方が精度が高くなります。
💡 要点と詳細
🔹 RAGの本質的な強みは「知識とモデルの分離」です。知識はインデックスに、推論能力はモデルに。この分離により、知識の更新がモデルの再学習を必要としません。ただし検索品質に依存するため、チャンク分割・埋め込みモデル・リランキング戦略のチューニングが品質を左右します。
🔹 FTの本質的な強みは「行動様式の安定的な変容」です。繰り返し同じ形式で出力する場面では、推論コストがRAGより低くなりえます。ただし知識の更新にはデータセット準備→学習→検証のサイクルが必要で、機動力に欠けます。
🔹 ロングコンテキストの本質的な強みは「実装の単純さ」です。ベクトルDB、検索パイプライン、チャンク分割、FTのインフラがすべて不要。ただしトークン課金がそのままコストに直結し、"Lost in the Middle"問題(窓の中盤の情報に注意が薄れる)もあるため、大量の文書には向きません。
⚖️ トレードオフ
RAGは鮮度と出典追跡に優れるが、検索パイプラインの構築・運用が必要。FTは様式の一貫性に優れるが、知識の更新が遅く出典が不透明。ロングコンテキストは実装が最も簡単だが、コストとスケーラビリティに制約あり。
🏆 実務での定石は「様式はFT、事実はRAG」のハイブリッド。FTで出力形式・口調・専門用語をモデルに染み込ませ、RAGで最新の事実情報を注入する。ロングコンテキストは、RAGのチャンク分割では失われる文脈が重要な場面で補完的に使います。
🛠️ ユースケース
🏢 社内ナレッジベースQ&A → RAG。ドキュメントは日々更新され、回答には出典の提示が求められる。
⚖️ 法務文書レビュー → FT+RAG。法務特有の口調と形式はFTで統一し、最新の判例や規制はRAGで注入。
📄 契約書の全体解釈 → ロングコンテキスト。契約書1通を丸ごと投入し、条項間の関係を把握させる。
🏥 医療情報提供 → RAG必須。出典の明示が絶対要件であり、情報の鮮度も重要。FTで焼き込んだ医療知識はハルシネーションと区別できず危険。
迷ったらRAGから始めてください。ほとんどの業務システムでは知識は更新されるものであり、出典を示す能力は信頼性の基盤です。
#AIエージェント# #ソフトウェアアーキテクチャ#
もっと見る

特大IR発表🔥
【営業利益黒字】・【売上最大2.5億円】のAI企業を“わずか1,500万円”で完全子会社化‼️📈🚀
『売れるネット広告社グループ(9235)』は、先ほど12時にAIサービス開発・運営会社である「株式会社ライト」の100%完全子会社化(株式取得)を発表しました❗
これは私が陣頭指揮を執り、『売れるネット広告社グループ』が従来の「D2Cクラウドサービス企業」から「AIネイティブ企業」へと完全に進化するための、極めて強力かつ決定的な一手です。
まず、今回のディールの【異常なまでの費用対効果】に注目してください。
ライト社は、直近の決算でも【営業利益黒字】【売上最大2.5億円】をしっかりと計上している非常に優秀かつ堅実なAI企業です。この高いポテンシャルを持つ優良企業を、なんと【取得価額わずか1,500万円】という破格の条件で完全子会社としてグループに迎え入れます。これがいかに私たちの収益基盤拡大に直結する「大成功のM&A」であるか、皆様にはすぐにご理解いただけるはずです。
では、なぜライト社なのか❓
最大の理由は、彼らが持つ「AI開発力と企業ナレッジの活用技術」が、私たちの進めるAI戦略と完璧なシナジーを生み出すからです。
これからの時代、企業の情報発信は「ChatGPTなどの生成AIにいかに正しく認識・評価されるか」が勝負を決める時代へと完全にシフトします。ライト社は、企業内に眠る「暗黙知」をAI資産へと転換する「Tacit Hub構想」を推進しています。
彼らの【現場知見を活用したAI開発・検証力】と、私たちがこれまで培ってきた【圧倒的なマーケティングノウハウ・強固な顧客基盤】を掛け合わせることで、当社が推進するAEO(AI検索最適化)支援や企業向けAI導入支援サービスの拡充が劇的に進みます。
私たちは単なる「D2Cクラウドサービス企業」で終わるつもりはなく、グループ一丸となって生成AI時代に特化した「次世代AIプラットフォーム」を構築します。
そして、投資家の皆様に最後にお伝えすべき【圧倒的な事実】があります。
今回のライト社の完全子会社化により、『売れるネット広告社グループ』にとって【今期M&A第5号】が完了となります❗
これにより、売れるネット広告社グループの2027年7月期の事業規模は一気に「2.3倍」へと拡大し、「売上43.8億円以上」のグループへと大飛躍を遂げます‼️📈🚀
私たちが見据えているのは目先の需給ではありません。この絶好のタイミングでのM&Aと事業規模の劇的なスケールアップは、AI関連事業を新たな成長ドライバーへと飛躍させ、中長期的な企業価値を爆発的に向上させるための確固たる証明です。
今後の『売れるネット広告社グループ』の快進撃に、どうか大いに期待してください。企業価値の最大化を実現してみせます❗
▼本気のIR資料全文はこちらから必ずご一読ください❗
加藤公一レオ
売れるネット広告社グループ株式会社(東証上場 証券コード9235)
創業者・取締役会長
もっと見る


検索広告×P-MAXでCPAを約3割改善、登録率も過去最高水準に!
LANYは、SEOやLLMOだけでなく、広告やCROまで含めて「検索マーケティング」全体で成果を出せる会社を目指しています。
もっと見る


AI検索対策SaaS「Brand UP」MCPサーバーを公開。ChatGPT、Claude・Microsoft Copilotとの連携に対応。計測データを...


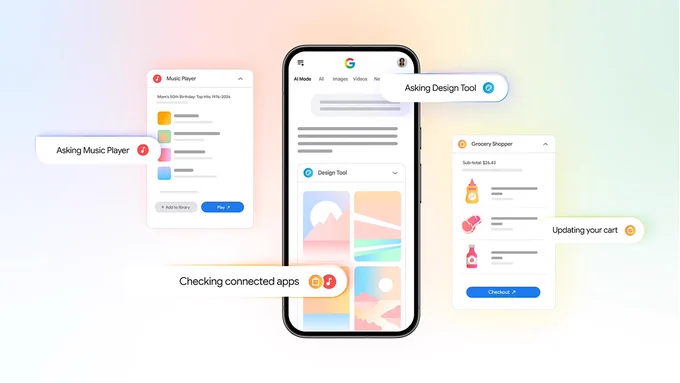
Google検索「AIモード」が外部サービス連携、CanvaやYouTube Musicほか

Google 検索 Shinji Tokidaでトップに表示されるShinji Tokida『Super Ultra Miracle Trillion Light Loves』は、2018年にリリースしたアルバムです。音楽性が高く、優秀な音楽構成で作成しました。Band Camp、Apple Musicで、ダウンロードできます。是非チェックしてダウンロードしてください。
もっと見る