検索結果 AIコードレビュー_findy
AIコードレビュー_findy コミュニティ
1つのキーワードが1つのコミュニティです。
アカウント
見つかりません
AIコードレビュー_findy を含む検索結果

AIコードレビューでトークンを燃やしていませんか?🔥 コードを構造グラフ化して、関連ファイルだけ読ませることで、トークンを中央値82倍削減するツールです。
タイトル: tirth8205/code-review-graph
URL:
🔥 概要
Tree-sitterでコードベースの構造マップ(グラフ)をローカルに永続化する、ローカルファーストのコードインテリジェンスツールです。AIアシスタントが、リポジトリ全体ではなく文脈的に関連するファイルだけを読んでレビューできるようにします。
❓ 解決する課題
AIコードレビューツールは、レビューのたびにコードベースの大部分を読み直し、大量のトークンを無駄にします。
・特に大規模モノレポでは、コンテキストが膨れ上がりコストもレイテンシも悪化します
・変更の影響範囲をスキャンするのに、プロジェクト全体を読む必要がありました
💡 方法論と仕組み
3段階のパイプラインで動きます。
・パース:Tree-sitterがASTを作り、関数・クラス・import・呼び出し関係を抽出
・グラフ保存:ノードとエッジをSQLiteに永続化(外部DB不要)
・分析:変更時に影響範囲(blast-radius)分析で、影響する呼び出し元・依存先・テストを辿り最小限の文脈を返す
多言語対応、増分更新は2秒未満、MCP連携(30ツール)、GitHub Action、D3.js可視化を備えます。
📊 実験結果 / 実績
・トークン効率:38倍〜528倍の削減(6リポジトリで中央値約82倍)
・影響予測のF1スコア:平均0.71
・CLI例:フル文脈12,921トークン→グラフ文脈762トークン(約94%削減)
#コードレビュー# #AIエージェント#
もっと見る


社内のAIコードレビューツール選定についてお話します!
抽象的なタイトルですが、具体的なお話をします🤗

🔍 TL;DR: 汎用AIエージェントのコードレビューにありがちな見落としやズレを、Alibaba社内実績のハイブリッド設計で解決したCLIツールです。
タイトル: alibaba/open-code-review
URL:
📌 ポイント
⚙️ 精度が必要な部分はハード制約、判断が必要な部分だけAIに任せる設計
📝 Gitディフから行単位の構造化レビューコメントを生成
🕵️ 未知のコードベース向けにフルファイルスキャンモードも搭載
🛡 NPE・スレッドセーフティ・XSS・SQLインジェクションなど多言語ルール内蔵
🔌 Claude Code、Codex、Cursorなどにプラグインで統合可能
📊 50リポジトリ・200PRのベンチマークでClaude Codeより高いPrecision/F1
💰 トークン消費は比較対象の約1/9
数千人規模の社内運用で鍛えられた精度が、そのままOSSで使えるのは魅力的だと思います。
#コードレビュー# #AIエージェント#
もっと見る


AIの進化で既存の開発生産性指標が機能しなくなっている、という話。
・AIの普及により、コミット数やPR数といった従来の指標が機能しなくなっている
・例えばOpenAIでは、Codexを多用するエンジニアはPR数が70%も多い
・ただ、それがそのまま生産性の高さを示しているわけではない
・現在、開発者が直接コードを記述する時間は減りつつある
・代わりにAI生成コードのレビューやアーキテクチャの定義に時間を割くようになった
・しかし、こうした高付加価値な作業はダッシュボードには反映されにくい
・例えば、優れた設計を行うことで数ヶ月分の手戻りを未然に防げる
・でも、そうした重要な貢献はコミット数などの指標には全く表れない
・Warp社のCEOは、エンジニアがプロダクトエンジニアからファクトリーエンジニアになりつつあると指摘
・手作業で機能を作るのではなく、ソフトウェアを生み出すシステム自体の改善が価値に
・誰がコードを書いたかではなく、誰が顧客の成果に貢献したかが問われるようになっている
・活動量とビジネス価値が乖離していく中で、評価指標の見直しが必要
・一部の企業ではすでに、活動量と品質の指標を必ずセットで評価している
・例えばDropboxでは、AI利用者のPR数20%増を変更失敗率の低下と併せて確認している
もっと見る

ザッカーバーグの強権モードが発動中とはいえ、記事に該当しているエンジニアはキャリアを相当考えるだろうなぁ。
・ザッカーバーグはモバイルOSの波に乗り遅れた過去があ李、AIという巨大なトレンドを絶対に逃さないという強い決意を持っている
・metaは過去にメタバースへ巨額の投資を行ったものの、パンデミック後に人々の関心が薄れ、その投資は十分な成果を上げなかった
・自社開発のAIであるLlamaモデルを進める中で2025年発表のLlama 4が不調に終わった
・そのため、AI戦略の立て直しを迫られた
・で、Scale AI社の株式を巨額で取得した。同社CEOのAlexandr Wang をAI戦略のトップとして迎え入れた
・Wangが得意とするのはAIの学習に必要なデータラベリングや、人間によるフィードバックを用いたモデルのファインチューニング
・彼の主導により、metaのエンジニアのタイピングやマウスクリックを強制的に監視してAIの学習データにするシステムが導入された
・この監視システムは事前の相談や拒否権なしにトップダウンで決定され、従業員のプライバシーに対する大きな懸念を引き起こした
・多くの反発を受けた会社側は、監視を一時停止する機能を追加するなどの妥協案を後日提示することになった
・同時期にプロダクト開発の中核を担うチームから30パーセントから50パーセントものエンジニアが、AIデータラベリング部門へ強制的に異動させられた
・meta社では従来、入社後に研修を経て自身の所属チームを自由に選べる文化があったため、この一方的な異動は大きな波紋を呼んだ
・異動先でのデータラベリング業務はAIが生成したコードをテストしてフィードバックを与える単調な作業
・多くのエンジニアのやる気を削いでいる
・特にインフラストラクチャやセキュリティを担当するチームへの影響は深刻であり、優秀な人材が次々と本来の業務から引き剥がされた
・会社全体で10パーセントのレイオフが予告されたことで、一ヶ月にわたり従業員は自分が解雇されるかもしれないという強い不安にも苛まれていた
・metaの人事制度にて、自身の評価を相対的に高めるためにあらゆる指標を最大化しようとする政治的な動きが横行している
・新たな評価指標としてAIトークンの使用量が導入された
・なので、エンジニアたちは評価を上げるためだけに無意味にAIツールを多用し始めた
・人間による入念なコードレビューよりも、AIを使って表面的な生産性を高く見せかけることが自己保身の有効な手段となっている
・本質的なプロダクト開発がないがしろにされた結果、エンジニアたちは会社に嫌気がさし、外部の面接対策サービスの利用登録者が急増している
・不満を抱える中核メンバーを引き留めるために会社は特別ボーナスを支給した
・だが、それでも彼らの離職意欲を根本から削ぐには至っていない
・5月末には、オバマ元大統領などの著名人のInstagramアカウントが次々と乗っ取られるという、同社史上最も恥ずべき大規模な障害が発生
・この障害はパスワードリセット時の本人認証プロセスが根本的に欠如しているという、非常に初歩的な脆弱性を突かれたものであった
・セキュリティチームの人員が半減させられていたことと、AIが生成したコードをAIがレビューするというずさんな開発体制が障害の最大の原因だろう
・障害発生の翌日には会社のCISOが辞任を表明
・経営陣と現場との間に深刻な亀裂が生じていることがうかがえる
・社内の全体会議では、現状を強制収容所に例えて不満を爆発させる従業員が現れるなど、組織内の混乱はもはや隠しきれない状態になっている
・CPOでさえも現在のメタ社の状況を狂気(insanity of this company)と表現しており、経営トップが引き起こした社内環境の劣悪さを公式に認めている
・この一連の混乱の元凶は、既存の主力事業やエンジニアの尊厳よりも新しいAIモデルの開発を何よりも最優先とみなしたザッカーバーグの独断にある
・IT業界全体でも、AIの能力を過信してシステムの安全性を軽視する傾向が見られる
・これをAI psychosisと呼んで危惧する専門家の声が上がっている
・metaの広告ビジネス自体はAIの恩恵を受けて過去最高の収益を上げている
・だが、その基盤を支える組織を自ら破壊しているのは皮肉
・エンジニアを単なるコストとみなす現在の経営体制が続く限り、優秀な人材の流出は避けられない
・他のテクノロジー企業にとっては絶好の狩場となっている
もっと見る


AI時代のエンジニアリング組織論
■ 開発工程のボトルネックはコーディングから製品設計とコードレビューへ移行する
リーガルAIのLegoraは、創業18ヶ月でARR1億ドルを突破し評価額56億ドルに達した最速のB2B企業である。CTOのヤコブ・ラウリツェンは、AIツールにより従来のボトルネックだったコーディングのコストは劇的に低下したと語る。現在、開発の真の制限要因は、顧客ニーズを製品設計へ落とし込む作業と、生成されたコードのレビュー工程へ移行している。そのため、同社はPMが顧客との対話に集中できる時間を守り、エンジニアをシステム設計に特化させている。
■ トークンの消費量競争は開発組織を歪ませる無意味な評価指標である
多くのエンタープライズ企業が陥る失敗が、開発者評価にAIトークン消費量を持ち込むことである。トークン消費を可視化するリーダーボードを作ると、エンジニアは評価のためだけに無意味にトークンを浪費し始める。ラウリツェンはこの「トークンマクシング」を愚策と一蹴し、AI使用量そのものを報酬評価にしてはならないと警告する。組織が評価すべきは開発効率と実際のアウトプットの質であり、デモ等を通じて効率化の工夫を共有し合う環境こそが不可欠である。
■ 開発者体験に特化した専門チームの設置が組織全体の生産性を最大化する
同社は、わずか80名のエンジニアでAccelやBenchmark、NVIDIA等から8億ドル以上を調達した。現在、Legoraのコードの50%以上はCursorやClaudeなどのAIツールにより生成されている。この開発速度を維持するため、同社は3名の開発者体験(DevEx)専門チームを早期から設置した。彼らは、エンジニア1人あたり最大10個の自律コーディングエージェントを回し、独自のCIレビューボットを開発して全員の開発を支援している。結果としてエンジニア全員が約20%効率化し、新人の即戦力化も劇的に加速した。
■ 複雑度の低い社内ツールは購入するよりバイブコーディングで自社開発する
AI開発において、同社は社内ツールの導入基準として、機能の広さと複雑度の深さという2つの軸を設けている。既存製品を購入するよりも、複雑度が低く自社専用のカスタマイズが必要なシステムは、バイブコーディングで自作する方が安価になった。特に人事管理やオンボーディングシステム、データ移行アプリなどは、AIを使って自立的かつ高速に自社開発することが推奨される。汎用ツールに頼る手間を省き、社内のAIイネーブルメントチームが直接プロトタイプを開発して課題を瞬時に解決している。
■ 組織を急成長させるためにはエゴのない優秀な人材の密度を高める
Legoraが競合を圧倒して超高速成長できた最大の要因は、優秀なAプレイヤークラスのエンジニア密度を極限まで高めたことだ。特に5〜8人規模のスタートアップチームを丸ごと買収するアクハイヤー戦略は、高いチーム開発力を一瞬で取り込む上で効果的だった。この統合を成功させたのは、役職やタイトルへの執着を一切排除する「ローエゴ(低自己愛)」の徹底した採用基準である。ラウリツェンは、最も優れた成果を出せる者が役割を担う機動的な文化を築き、エゴの排除が企業の成長速度を決めると実証している。
もっと見る

AIエージェントをエンタープライズシステムに組み込むプラクティス
【プロンプト・サプライチェーン管理】
💡 プロンプトを「こっそり変更」して本番の挙動が変わった経験はありませんか?
プロンプトをコード成果物として扱い、バージョン管理・レビュー・署名・evalを経てデプロイするパターンです。
🔥 解決する課題
- プロンプト変更の追跡・レビューができず、品質劣化の原因が特定できない
- 外部入力がプロンプトテンプレートに注入され、意図しない動作を引き起こす
- どのバージョンのプロンプトで生成された結果か追跡できず、再現性が失われる
🏗️ 提案パターン
プロンプトをGitとレジストリで管理し、変更にはPR・コードレビューを必須とします。変更時はeval gateの通過を必須にし、ゴールデンデータセットに対する品質チェックを自動実行します。本番デプロイされたプロンプトには署名を付与して改竄検知を行い、テンプレート変数への外部入力には区切り・サニタイズ・最小権限化によるインジェクション対策を施します。ソフトウェアのCI/CDと同等の品質管理プロセスをプロンプトに適用する考え方です。
✅ 選定条件
- 向き:本番運用で複数人が開発に関わるエージェント
- 不向き:使い捨ての実験やPoC(統制のオーバーヘッドが見合わない)
⚠️ 落とし穴
- プロンプトの変更をコードと同等に扱う文化が根付かないと形骸化します
- 署名・改竄検知を導入しないと、悪意ある変更や事故的な変更を検出できません
- eval gateのゴールデンデータセットを更新し続けないと、新しい問題パターンを検出できなくなります
🛠️ 実装方針
1. プロンプト・システム指示・テンプレートをGitリポジトリで管理し、変更には必ずPR・コードレビューを必須とします
2. CI/CDパイプラインにeval gateを組み込み、変更のたびにゴールデンデータセットに対する品質チェックを自動実行します
3. 本番デプロイされたプロンプトにHMAC等の署名を付与し、デプロイ時に改竄されていないことを検証します
4. テンプレート変数への外部入力に対して、区切り文字(delimiter)・サニタイズ・最小権限化によるインジェクション対策を実装します
5. プロンプトレジストリでバージョンと本番適用履歴を一元管理し、問題発生時に即座にロールバックできる仕組みを整備します
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る

# AIエージェントをエンタープライズシステムに組み込む意思決定ポイント
# プロンプト変更の統制|Prompt Change Control
🎯 ポイント
プロンプトは「ちょっとした言い回しの変更」に見えて、実はシステムの振る舞いを根本から変える「設定変更」です。コードのデプロイにはCI/CDとレビューがあるのに、プロンプトの変更は誰がいつ何を変えたか追えない——そんな状態で本番運用していませんか?プロンプト変更の統制は、すべてを同じ厳格さで管理するのではなく、本番影響度に応じてレベルを分けるのが現実解です🔑
📋 概要
プロンプト変更の統制は、エージェントのシステムプロンプトやツール定義の変更に対して、どの程度の承認・テスト・バージョン管理を求めるかを制御するダイヤルです。厳格にすれば再現性と安全性が上がりますが、開発速度が落ちます。緩めれば迅速な改善・実験が可能ですが、意図しない変更が本番に入るリスクが上がります。このダイヤルの要点は、プロンプトの構成要素ごとにリスクが異なるため、統制レベルも分けるべきだということです。システムプロンプトのロール定義とFew-shot例示では、求められる統制が全く違います📋
🔍 意思決定のポイント
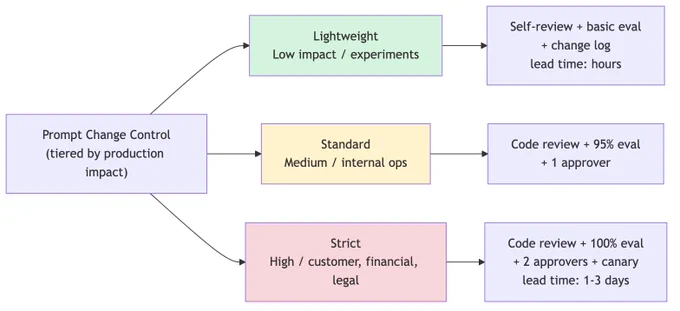
このダイヤルは「本番影響度」で3段階に分岐します。
高影響(顧客向け・金銭・法的)→ 厳格:コードレビュー+eval 100%通過+承認者2名+カナリアデプロイ
中影響(社内業務・広範囲)→ 標準:コードレビュー+eval 95%通過+承認者1名
低影響(内部実験・限定公開)→ 軽量:セルフレビュー+基本eval通過+変更ログ記録
さらにプロンプトの構成要素ごとに統制方針を分けます:
システムプロンプト(ロール・制約)→ 変更頻度は低いがリスクは高い。厳格に管理し設計判断として扱う
ツール定義(名前・説明・スキーマ)→ ツール選択精度に直結するため厳格に
Few-shot例示 → 中程度のリスク。evalで品質を確認する標準統制
コンテキスト注入テンプレート → 変更頻度が高くリスクは低〜中。軽量〜標準で対応
出力フォーマット指示 → リスクは低いが下流システムとの整合確認は必要⚡
💡 要点と詳細
統制の構成要素は5つです:
バージョン管理 — プロンプトをGitでコードと同様に管理します。差分の可視化と履歴の追跡が可能になります。「誰がいつ何を変えたか」が追跡できないと、将来の判断が困難になります。変更理由を必ず記録してください。
evalゲート — 変更後のプロンプトが既存のevalセットを通過することをデプロイの前提条件にします。evalの回帰検出率(プロンプト変更による品質低下を事前に検出できた割合)を計測し、検出できなかったケースはevalに追加して強化します。
承認プロセス — 影響度に応じた承認者のレビューです。厳格レベルでは同僚エンジニア+テックリードの2名。返金上限額など金銭に関わる記述変更は法務レビューも追加します。
カナリアデプロイ — 一部のトラフィック(目安10%)にのみ新プロンプトを適用し、24時間の品質指標を比較した上で全体展開します。A/Bテストの仕組みと共通化できます。
ロールバック手順 — 問題発生時に即座に前バージョンに戻せる仕組みです。Gitのリバートとデプロイパイプラインの連携が基本です🔬
計測すべき指標は5つ:プロンプト変更の頻度(環境ごと)、変更からデプロイまでのリードタイム(厳格レベルは1〜3営業日、軽量レベルは数時間以内が目標)、プロンプト変更起因の障害件数、evalの回帰検出率、ロールバック発生率です📈
⚖️ トレードオフ
開発速度優先(緩め)にすると、プロンプトの迅速な改善・実験が可能になりA/Bテストのサイクルが速まります。しかし「誰がいつ何を変えたか」が追跡できず、障害時に原因究明が困難になります。意図しない変更が本番に入り、品質低下やセキュリティ問題を引き起こすリスクがあります。特にシステムプロンプトのロール定義が知らないうちに変わっていた場合、影響範囲は全回答に及びます😰
再現性・安全優先(厳格)にすると、全変更が追跡可能で障害時の原因特定が容易になります。しかし変更の承認プロセスがボトルネックになり、改善のリードタイムが長くなります。小さな改善でも重い手続きが必要だとチームのモチベーションが下がり、「プロンプトを直したいけど面倒だからそのまま」という本末転倒な状態を生みます⚠️
対策は明確です:統制レベル自体を安易に下げるのではなく、evalの自動化・承認プロセスの並列化で変更リードタイムを短縮すること。そして実験環境と本番環境の統制レベルを明確に分け、実験の速度を本番の安全性と引き換えにしないことです。
🛠️ ユースケース
Zendesk顧客対応エージェント:システムプロンプトの変更はPM+エンジニアリードの承認必須。返金上限額の記述変更は法務レビューも追加。eval通過+カナリア(10%トラフィック×24時間)を経て全体展開。変更リードタイムは1〜3営業日です📞
Slack社内実験ボット:開発者がセルフレビューで変更可能。基本evalの通過は必須だが承認プロセスは省略。変更ログは自動記録され、問題発生時の原因追跡に使います。変更リードタイムは数時間以内です💬
Salesforce営業支援エージェント:ツール定義の追加・変更はコードレビュー必須。商談ステージの判定ロジックに影響するプロンプト変更はテックリードの承認が必要。大規模なプロンプト変更は段階的に実施し、影響範囲を限定します🎯
実践のコツ:初期は厳格寄りで運用を開始し、チームの習熟とevalの充実に応じて段階的に緩和してください。プロンプト変更起因の障害が発生したら、そのケースをevalに追加して再発防止を自動化する。そして大規模なプロンプト変更(ロール定義の書き換え等)は一度に行わず段階的に実施すること。一度に大きく変えると影響範囲の特定が困難になります💪
#AIエージェント# #エンタープライズアーキテクチャ#
もっと見る
# Codexの機能と実践的な使い方
🚀 「コードを書くすべての場所に、ひとつのエージェントを」。OpenAI Codexは、生成から理解・レビュー・デバッグまでを丸ごと任せられるAIコーディングエージェントです。
🏷️ タイトル: Codex 基礎
🔗 URL:
📘 概要
Codexは、ソフトウェア開発のためにOpenAIが提供するAIコーディングエージェントです。単なるコード補完ではなく、既存のプロジェクト構成や規約を読み取りながら、自律的にタスクを進めてくれます。ChatGPTのPlus/Pro/Business/Edu/Enterpriseプランに組み込まれています。
⚙️ 機能の説明
Codexの中心となる能力は大きく5つです。
・コード生成: 「何を作りたいか」を伝えると、既存の構成や命名規約に合わせてコードを書きます。
・コードベース理解: 複雑なコードやレガシーコードを読み解き、システムの構造を説明します。
・コードレビュー: バグ・ロジックの誤り・未処理のエッジケースを洗い出します。
・デバッグ: 失敗を追跡し、根本原因を診断して、的を絞った修正を提案します。
・反復作業の自動化: リファクタリング・テスト・マイグレーション・セットアップを代行します。
これらを安全に動かすために、サンドボックスによる実行境界と承認ポリシーという仕組みが土台にあります。
🛠️ 実践的な使い方
Codexは「コードを書くあらゆる場所」で動くのが特徴で、複数の入口が用意されています。
・CLI: ターミナルで `codex` を起動して対話的に作業
・IDE拡張: エディタ内からそのまま委任
・Web / クラウド: ローカルに無いリポジトリのタスクを並列実行
・GitHub連携: PRに `@/codex review` でレビューを依頼
・Slack連携: スレッドで `@/codex` にメンションしてタスク起動
まずはCLIで `npm i -g @/openai/codex` から始め、慣れてきたらGitHubやSlackに広げるのが王道です。
💡 ユースケース
未知のリポジトリに参加した初日に「このプロジェクトについて教えて」と尋ねて全体像をつかむ、レビュー前にバグを先に潰してもらう、退屈な一括リファクタリングを丸ごと委任する、といった使い方が現実的です。人間は方針決定とレビューに集中できます。
⚠️ 注意点
Codexはファイルの読み書きやコマンド実行を伴う自律エージェントです。タスクの前後でGitのチェックポイント(コミット)を作っておくと、いつでも安全に巻き戻せます。認証はChatGPTアカウントが推奨で、APIキー認証では一部機能が制限される場合があります。
#OpenAICodex# #AIコーディング#
もっと見る

社内で共有するAIエージェントを作るとき、どこでつまずくのでしょうか。LangChainが3つの社内エージェントで見つけた答えをまとめました🧩
The five components of building a "company harness"
❓ そもそも「company harness」とは?
💡 営業・エンジニアリング・マーケティングの全員が共有するエージェント層のことです。共有チャンネル、ユーザーごとの権限、メモリ、安全なコード実行、頼まれなくても動く処理を扱う必要があります。
❓ 一番厄介なのは何ですか?
💡 アイデンティティ、つまり「誰として動くか」です。呼び出したユーザーとして動くOBOと、共有の固定資格情報があり、どちらかではなくツールごとに使い分けます。例えばOpenSWEは、ユーザー起点ならそのGitHubハンドル、コードレビューなどのバックグラウンドでは自前のGitHub appとして動きます。
❓ 他の要素は?
💡 ・体験: Slackに常駐し、向かない作業だけカスタムUIに
・メモリ: 全員向けのグローバルとユーザー別の2階層
・コード実行: サンドボックスとシークレットプロキシで、資格情報を見せずに外部サービスへ接続
❓ ユーザーが頼まなくても動くのですか?
💡 はい。OpenSWEは新規PRを検知して自動レビューし、GTM Agentはユーザーに頼まれたデイリーブリーフのために自分でcronを作ります。こうしたアンビエントな実行が、活動の大きな割合を占めるそうです。
#AIエージェント# #LangChain#
もっと見る