搜索结果 HARVEY
HARVEY 贴吧
一个关键词就是一个贴吧,路径全站唯一。
用户
未找到
包含 HARVEY 的推特

更新:Harvey 的 DAU/MAU 已经突破 50%。
超过一半的客户每天都在使用 Harvey。


🔬 震惊,Harvey LAB 把 1671 道真实法律活儿做成了公开基准,专门考 AI agent 能不能干律师的事。
GitHub 1381 star,两百四十多个 fork,MIT 许可,Harvey 出品。
在法务岗或者做法律方向 AI 的人最头疼一件事:怎么判断一个 agent 到底靠不靠谱。拿几套选择题式的法律考试去测,分数很漂亮,可真实工作里 agent 要翻几百页文档、要交叉核对条款、最后还得交一份能直接给人看的东西,这些一条都测不出来。
Harvey LAB 给的是两样东西。一套任务集,每道题带着指令、配套文档和评分标准,覆盖 24 个以上法律执业领域以及合同相关的活;再加一套执行框架,负责把 agent 跑起来、打分、出报告。评分用的是全部通过式的标准,一条不达标这题就不算过,中间配合 LLM 评判。
仓库里那个并购 data room 的教程能完整走一遍流程:建任务、检查、跑 agent、打分、看报告,最后拉一个对比看板出来。项目方自己说这是个会持续扩的东西,九月中刚发了 v1.1.0。
考 AI 会不会做题容易,考它会不会干活难。
GitHub:
显示更多


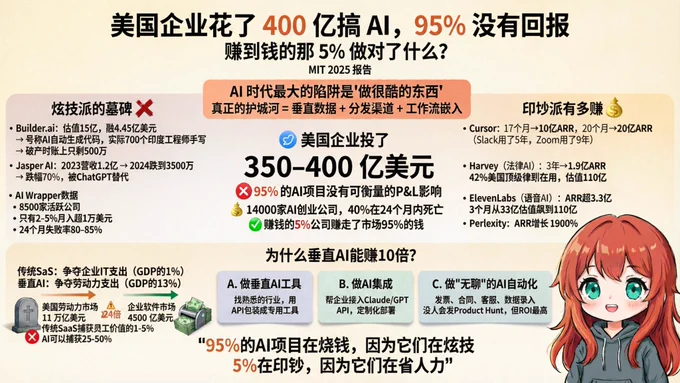
美国企业花了 400 亿搞 AI,95% 没有回报
赚到钱的那 5% 做对了什么?
AI 时代最大的陷阱是 “做很酷的东西” 🦊
Cursor 不酷,它只是让写代码变快了。Harvey 不酷,它只是帮律师省了时间。ElevenLabs 不酷,它只是让任何人都能做配音。
真正的护城河 = 垂直数据 + 分发渠道 + 工作流嵌入,不是模型本身 (Claude 和 GPT 不是你的,你也做不了,开发模型要花很多钱)
95% 的 AI 项目烧钱,因为它们在炫技
剩下 5% 在印钞,因为它们在省人力
MIT 2025 年的一份报告我看简中推几乎没人讨论,数据非常惊人:
1、美国企业在生成式 AI 上投了 350-400 亿美元,但 95% 的 AI 试点项目没有产生任何可衡量的 P&L 影响
2、14000 家 AI 创业公司有 40% 在 24 个月内死亡
与此同时,赚到钱的那 5% 公司却赚到离谱
先来看看炫技派们的墓碑 🪦
1、Builderai:微软投的,估值 15 亿,融了 4.45 亿美元
号称 AI 自动生成代码,实际上是后台靠 700 个印度工程师手写,破产时账上只剩 500 万
2、Jasper AI:AI 写文案的标杆。2023 年营收峰值 1.2 亿美元。2024 年暴跌到 3500 万。跌幅 70%。原因很简单:ChatGPT 的文案能力变好了,用户不需要一个"套壳"了
AI Wrapper 数据显示:8500 家活跃 AI Wrapper 公司
只有 2-5% 月入超过 1 万美元,24 个月累计失败率 80-85%
再看看赚钱的有多赚钱 💸
1、Cursor:零营销:17 个月做到 10 亿 ARR,又 3 个月翻到 20 亿 ARR
Slack 用了 5 年,Zoom 用了 9 年,Cursor 不到 2 年就做到了
2、Harvey(法律 AI):3 年做到 1.9 亿 ARR
42% 的美国顶级律所在用。估值 110 亿
3、ElevenLabs(语音 AI):ARR 超 3.3 亿
从 33 亿估值飙到 110 亿,只用了 3 个月
4、Perplexity(AI 搜索):ARR 自 2022 年以来增长 1900%
为什么垂直 AI 能赚 10 倍?
顶级 VC Bessemer给了一个清晰的框架:
传统 SaaS 争夺的是企业 IT 支出——仅占 GDP 的 1%
垂直 AI 争夺的是劳动力支出——占 GDP 的 13%
美国劳动力市场 11 万亿美元,企业软件市场 4500 亿美元,差 24 倍。传统 SaaS 捕获一个员工价值的 1-5%,AI 可以捕获 25-50%
Harvey 不是在卖 AI,它是在卖律师的时间
一个 AmLaw 100 律所的初级律师年薪 $20 万+,Harvey 替代掉他 30% 的工作,省下来的钱是任何 SaaS 订阅费的几十倍
而每个赛道都有“Cursor 时刻” 💡
▪️法律:Harvey 1.9 亿 ARR,Casetext 被 Thomson Reuters 以 6.5 亿美元收购
▪️医疗:Abridge 估值 53 亿(AI 环境记录),一家医院用 AI 做保险验证,年增收 230 万
▪️会计:Basis 估值 11.5 亿(AI 报税),CPA 事务所效率提升 30-50%
▪️房产:EliseAI 估值 22 亿,PropTech AI 投资年增长 42%
不是做更通用的 AI,而是做某个行业的"替代人力"
给我的启发是
1、数据"无聊"的 AI 其实最赚钱:
例如 AI 发票自动化、合同审核、销售线索生成,叙事不性感但有人月入 25 万美元
2、90% 的员工在用"影子 AI":
只有 40% 的公司有官方订阅,但 90% 的员工每天在用个人 AI 工具(牛马们自费开 Claude 写代码,我真的哭死)需求是真实存在的,只是企业产品没跟上
3、AI 公司到 1000 万 ARR 只需 2.5 年
传统 SaaS 需要 6 年
4、最大 ROI 不在销售和营销,在后台自动化
如果你想赚钱,3 条路线可以思考,或者和你的 AI 多讨论
A:做垂直 AI 工具
找一个你熟悉的行业(律师、牙医、房产中介)用现成 API 包装成行业专用工具,月费 SaaS。AI 一直强,重点看你有没有行业 know-how 和分发渠道
B:做 AI 集成
帮企业接入 Claude/GPT API,做定制化部署
MIT 数据说外购成功率高 3 倍,但企业不会自己接(或担心数据风控风险)他们需要人帮忙
C:做"无聊"的 AI 自动化
发票、合同、客服、数据录入。没有人会把这些发到 Product Hunt,但它们的 ROI 最高
今天早上我在公司开会时说:
赚聪明人的钱很难很难,因为聪明人自诩聪明,你能想到的一切他都会自己搭,最好赚的其实是傻子的钱
怎么找到傻子和如何赚到傻子的钱
think think 再 think
显示更多

本期 Jarsy 華語 X Space,我們邀請到幾位嘉賓,從不同背景從不同視角展開討論:AI 的模型與垂类應用,誰才是最終贏家。
🎤嘉賓陣容包括:
@mycharmspace|前 xAI 機器學習工程師
@ZongZiWang|Harvey AI 早期員工、曾任職Figma、Uber、Google
@qinbafrank |AI、Crypto 與 TMT 投資人
@mrblock|Angel Investor,知名播客主
@Wuhuoqiu|Amber Group Advisor,曾任職於 OKX Ventures、ABCDE Labs
@JarsyMandarin | 主辦方
⏰北京時間 8 月 13 日週四上午10點
直播鏈接
點擊鏈接設置提醒🔔
显示更多


开源模型正在把顶级 AI 变成一种「按需调用」的高价服务。企业让便宜模型处理大部分日常任务,只在规划、难题和审核环节使用 OpenAI、Anthropic 的旗舰模型。
模型厂商越来越难锁住客户,只能靠免费额度和补贴争夺用量。客服平台 Pylon 今年从一家供应商拿到约 160 万美元的免费 Token,还获得数月不限量使用。过去两周,约一半 AI 数据分析平台 Hex 的客户把 Kimi 接入工作流。法律 AI 公司 Harvey 则让 GLM-5.2 先处理任务,遇到难题再调用 Fable 5。
OpenAI 和 Anthropic 的高估值依赖两个前提:企业会大量使用顶级模型,也愿意长期支付高价。开放权重模型正在同时动摇这两个前提。
两家公司可能继续拥有最强模型,却只能拿到难度最高、数量更少的任务。更多 Token 消耗流向便宜模型后,它们的收入增长和定价权都会承压,还要继续用补贴换取客户。
《华尔街日报》认为,这场由开放权重模型推动的价格战,正在威胁 OpenAI 和 Anthropic 上市前的高估值。
显示更多

前段时间,美国风投机构Dimension Capital的几个合伙人来中国深度拜访了一圈AI公司,用于修正自己的投资判断,他们回去后发给出资人的内部信传得挺广的,全文翻译如下:
跨太平洋的AI棋局
1、稀缺催生进化
美国的出口管制本意是为了拖慢中国的AI发展,但结果却意想不到的制造出了一种进化压力,导致中国的AI实验室拥有了世界独有的竞争围栏。
因为缺少算力,中国团队被迫深入到极其底层的架构里去做工程优化,DeepSeek在刻意削弱性能的H800上训练模型,并绕过CUDA在更下面的PTX上编程,甚至要把每张GPU里的一部分流式多处理器专门分配给跨节点通信。
我们认为,这并不是美国工程师干不了的事情,而是因为两边的刺激机制不同。
美国的AI公司更愿意用资本解决问题,每多投入一美金,就能多买来一美金的算力,但在中国,因为始终没有充足的算力可供购买,所以形成的方案是,每多一个懂编译器的工程师,就能降低整个团队对于算力的需求。
最后形成的是一种覆盖全栈的效率文化,从系统、优化器、推理算法、一直延伸到芯片,这种能力可以持续积累,不像一次性的资本开支,用完就结束了。
2、中国开源模型完成了过去20年中国SaaS都没能做到的事情——进入西方生产环境
不到18个月,中国模型在OpenRouter上的Token消耗份额从不足2%飙升到了45%,Qwen成为Hugging Face上面最快突破10亿次下载的模型家族,大约80%的美国AI初创公司,已经在内部部署了至少一款来自中国的开源模型。
开源绕过了传统软件采购的审查,当模型可以免费部署,也就不存在「供应商」让你放进黑名单。
但吊诡的地方在于,中国的开源模型本质上是在承担西方的生产成本,而并没有拿走西方的生产收入。
因为可以自行部署那些开源模型,所以最主要的利润,仍然流向负责提供Token的云厂商。
所以中国人把模型价格打了下来,让竞争对手很难受,但最主要的受益者仍然是美国的其他商业公司,因为它们能用到更便宜的模型了。
这不是说中国AI公司有钱不赚,开源这种生态在客观上就是会把利润的最大头分配给云厂商,而非模型开发商。
3、中国前沿模型的内部竞争,比西方预计的更加激烈
我们的判断是,目前中国模型的第一梯队包括DeepSeek、Qwen、Kimi、Doubao和GLM,它们之间的差距非常小,洗牌也相当频繁。
五家实验室同时比拼发布速度和模型能力,而且全部开源(译注:豆包并没有开源),这与美国主要由两家闭源实验室主导的竞争环境截然不同。
我们在这一周里最明显的感受就是,中国模型之间的竞争,可能更甚于它们和美国模型之间的竞争。
4、今天,AI要从太平洋两岸来回跑两趟,才能最终落地到客户那里
现在的循环大致上是这样的:
美国的前沿实验室训练出SOTA级的模型;
中国的前沿实验室对这些模型进行蒸馏,然后开源;
美国的AI服务商再基于中国的开源模型进行微调,做成产品卖给美国企业……
Cursor所谓「自主研发」的Composer 2,被发现是用Kimi K2.5改的,Cognition的SWE-1.5看起来也像一个定制版GLM。
就在我们坐在从上海去北京的高铁上时,Harvey发布了自己的专有模型Harvey Tenet——它是对Kimi K3进行了后训练所得到的产物。
如果是一年前,这些公司大概率会选择Llama,或者Mistral。
如今,美国垂直AI行业的底层基座,正在变成中国的开源模型——而这些模型内部,又潜藏着来自美国前沿模型的智能。
5、数据层似乎也在发生类似的事情
Mercor、AfterQuery、Turing这些美国的数据标注公司,都已经公开披露与蚂蚁、阿里巴巴和字节跳动存在商业合作关系。
同时,我们也在中国看到了一批刚刚出现的新公司,它们没有再去做数据标注的生意,而是转为评测和验证基础设施。
比如UniPat。
这家公司成立于2025 年12月,创始人是一名北京大学博士生,此前曾在阿里、月之暗面和腾讯工作。
UniPat发布的 基准测试,已经开始被美国实验室引用到自己的模型报告中,它还声称,通过自己基于Rubric的监督方法训练一个小模型,也取得了很好的效果。
这种思路还是在用更高质量的监督替代更多算力,与我们在第一点中提到的现象完全一致:资源,尤其是算力受限的环境,会逼迫团队发展出不同的适应性能力。
我们在北京和上海见到了好几家这样的公司,绝大多数成立不到24个月,其中少数几家的收入已经很快的突破了1亿美金。
6、美国和中国面临的难题完全不同,而且恰好相反
2024年,中国新增的电力供给是429GW,美国大概是51GW。
根据预估,一直到2030年,中国每年新增的电力供给,都将在400GW以上。
美国的情况是,目前光是数据中心的扩建项目,就有241GW的电力缺口,因为电网接入的积压,需要排队等上5年时间。
中国真正的瓶颈,正如我们提到过的,是算力资源不足。
最直接的例子就是月之暗面:Kimi K3发布后不到两天,就因为推理能力不足而暂停了新用户注册。
所以:
美国芯片充裕,但越来越受制于电力;中国电力充裕,但一直都受制于芯片。
我们可以确信的是,中期AI局势很大程度上将取决于哪一侧的障碍先被推倒,是美国的电网容量先得到改善,还是中芯国际和华为的先进封装以及良品率提升得更快。
7、中美两国的AI产值差太远了
Anthropic在7月的年化收入超过了650亿美金,OpenAI的同期数字在400亿美金左右。
相比之下,中国收入最高的模型是字节跳动的Seedance,年化收入大概在20-30亿美金之间。
中国的纯语言模型公司,年化收入都还停留在数亿美金级别,比如DeepSeek正在接近5亿美金的水位。
消费端也有同样的困扰,豆包的月活用户已经达到3.45亿了,超过Qwen和DeepSeek之和,但每天产生的收入仍然不到100万人民币,而且基本全部都来自购物佣金。
中国的消费者不愿意为软件付费这个死结,我们也不知道该如何解开。
当然,拥有如此庞大的用户规模,最终完全可能找到具有中国特色的商业模式,这在十年前的消费互联网已经发生过一次了。
那就是羊毛出在猪身上,靠电商和广告来实现模型的商业化,中国的创业者身上有种实用主义精神,他们不会因为某种商业模式不够AGI而回避它。
8、硬件和半导体在脱钩,软件和数据在融合
两个国家的政策反应速度已经跟不上了:
美国的产品跑在中国的模型上;
中国的实验室在新马泰租用英伟达的GPU训练模型;
专家标注的数据则在两个方向上互相流动;
所以我们觉得「到底哪边在赢」是一个伪命题,在目前的状态下,两个体系已经高度相互绑定,以致于国家层面的胜负很难被清晰定义。
除非RSI(递归自我改进)的实现能从根本上改变整个系统结构。
9、中国的一些顶尖研究员相信他们已经拥有弱形式的RSI了
在此语境下的RSI,仍然受到算力限制。
更准确的说,这些系统如同RSI的早期雏形:
研究员自己介入其中,通过人工辅助的方式,加速模型到达原本最终也可能到达的能力,从而节省算力和时间。
打比方来讲,这一阶段的RSI,最接近1990年到2010年之间流行的「半人马国际象棋」:
机器加人类的组合,比单独的人类或单独的机器都更强。
10、接下来会有一个至关重要的分叉
假设RSI会随着算力规模的增长而进化,那么美国所处的位置就相当有利了。
目前,美国那两家顶级实验室各自运行有大约2GW的算力基础设施,同时每家已经锁单超过5GW,计划到2030年达到约30GW的水平。
理论上,这些公司拥有巨额收入和资本市场的全力支持,可以大力出奇迹的推动RSI,而中国根本没有足够的芯片追赶。
但另一种情况是:
如果真正的瓶颈并不在于算力,而是质量;
或者,这条技术线所需要的时间足够长,长到足以让中国的优化能力和替代芯片发展到可用水平;
那么过去18个月已经出现的趋势可能不仅会继续,还会加速:
美国前沿模型能力进一步商品化;
中国开源模型变得越来越无处不在;
美国垂直AI公司则获得新的机会——在外国开放权重模型上做微调和应用;
与此同时,大量新增的调用量和利润,会流向负责提供推理服务的公司,目前来看,主要就是超大规模云厂商和新型算力公司。
当然,这一判断建立在电力基础设施按中性预测发展的前提之上。
11、还有一种未来的可能性是,美国的前沿实验室不再对外提供最新版本模型的API了
现实是,目前这一代模型的能力,已经可以满足绝大多数商业需求了。
未来顶尖的高端模型,可能不会再按调用量定价,而是像交付SaaS系统那样,按结果定价。
这样做还有另一个效果:限制中国实验室的蒸馏行为。
美国公司的代价是要放弃不断增长的API调用收入,作为回报,它们可以切断太平洋对面的竞争威胁。
或者至少,这会迫使中国进行昂贵的预训练,从而进一步挤压中国已经存在的算力资源。
12、监管政策砍不断跨太平洋的暗通款曲
到了今天,如果还认为可以简单切断这种联系,实在是过于天真了。
中美两国的技术人员正在通过各种媒介「对话」:
模型蒸馏、开放权重、数据标注、推理服务,以及越来越多的软件执行框架和智能体基础设施。
眼下正在讨论的一些粗暴限制措施——实体清单、托管禁令、采购禁令——几乎肯定会抑制美国自身的创新,并让美国在这些领域失去领导地位。
而空出来的位置,必然会迎来快速跟进的中国竞争者。
13、西方一直在讨论的估值泡沫,在中国市场明显更加突出
中国AI公司的收入规模更低,却享有更高的估值倍数,这是资本市场的一大奇观。
月之暗面的估值是年化收入的115倍,智谱、MiniMax在上市之初也都是100倍,相比之下,Anthropic只有20倍。
我们的判断是,这可能源于中国的资本市场仍不够成熟。
过去二十年,这个市场更习惯于给消费软件公司定价,而现在才刚刚开始建立一套能够理解企业软件和开源商业模式的成熟估值框架。
对于合适的投资机构来说,中国内地和香港存在着相当大的机会,能够找到新兴行业的领先标的。
显示更多

韩国男子团体“防弹少年团”(BTS)周三(7月29日)宣布不会角逐2027年格莱美奖。 7位成员同步透过Instagram发声明表示,希望音乐本身受到喜爱、而不被地区或语言限制。
BTS曾连续三年入围格莱美奖,但目前未曾获奖。这次是他们第一次选择不报名,被视为在回应格莱美新增的“最佳亚洲流行音乐演出”奖。该奖项旨在表彰“源自亚洲市场、或在亚洲市场广受认可”的流行音乐演出,包括但不限于韩语、日语和华语流行音乐,且作品须“有意义地使用”一种或多种亚洲语言。
部分粉丝认为,该奖项等同于为亚洲音乐人设下一道族裔或语言门槛,将亚洲音乐隔离于主流奖项之外。也有网友指出,BTS今年发行的专辑《ARIRANG》,瞄准欧美及全球市场,歌词、歌名大量运用英文;选择不角逐格莱美,可能是因新奖项降低了该团获奖胜算。
《ARIRANG》是BTS成员完成兵役后睽违近4年推出团体新作,连续三周登上告示牌(Billboard)200专辑榜冠军,外界原本看好BTS能在明年首度抱回格莱美奖座。
格莱美执行长梅森(Harvey Mason Jr.)对BTS的声明表示遗憾。他表示,设立“最佳亚洲流行音乐演出”是希望让亚洲音乐人“获得专属舞台”。他也强调,报名特定类别奖项,还是可以同时角逐年度制作、年度专辑及年度歌曲等综合类奖项。
今年,Netflix动画电影《Kpop猎魔女团》的歌曲《Golden》夺下“最佳影视媒体歌曲”奖,成为首个获得格莱美奖的K-pop相关作品。有观察认为,尽管K-pop拥有庞大的全球粉丝基础,却未在格莱美受到相应重视。
💭格莱美新设“最佳亚洲流行音乐演出”,有人认为是“歧视”、也有人认为是给予肯定。你怎么看?
显示更多


AI世界杯来啦‼️AGI SUMMIT 2026(AGI 峰会)
2026 年 7 月 18–19 日 · 旧金山艺术宫
15,000 参会者 · 200 展商 · 200 演讲嘉宾 —
Anthropic × OpenAI × 斯坦福 × 伯克利——前沿阵容,同一个舞台。
可以用我的CODE和专属链接。 AI SUMMIT 见!
“CHRISAISUMMIT”
专属链接:
Luma:
Eventbrite:
重磅嘉宾 Top 15
1. Wendy Lu — Anthropic。工程负责人——Claude for Enterprise(企业版 Claude)。
2. Rohan Varma — OpenAI。Codex 产品负责人;前 Cursor 首位 PM——一年内 $0 → $10 亿。
3. Aengus Lynch — Anthropic。对齐研究员;Agentic Misalignment 研究第一作者,收录进 Claude 4 system card。
4. Raymond Chen — OpenAI。核心技术团队,infra 系统。
5. Dong Meng — OpenAI。工程——AI 基础设施扩展。
6. Prakhar Bhargava — OpenAI。前沿 AI 商业化(GTM)。
7. Zihan (Gavin) Zheng — OpenAI。生产级推理系统。
8. Christopher Manning — 斯坦福。斯坦福 AI 实验室(SAIL)主任、Stanford HAI 联合创始人,GloVe 之父、NLP 先驱。
9. Dan Klein — UC 伯克利。Scaled Cognition 联合创始人——融资 $1 亿。
10. Sebastian Thrun — 斯坦福。Udacity 与 Google X 创始人;谷歌自动驾驶之父。
11. Bin Yu — UC 伯克利。校长讲席教授——美国国家科学院院士。
12. Christopher Potts — 斯坦福。语言学系主任,NLP 与可解释性。
13. Marti Hearst — UC 伯克利。ACM & ACL 双 Fellow。
14. Surya Ganguli — 斯坦福。扩散模型共同发明人;两获 NeurIPS 杰出论文奖。
15. Ken Goldberg — UC 伯克利。机器人抓取领域先驱。
最新官宣嘉宾(10 位)
1. Wendy Lu — Anthropic。工程负责人——Claude for Enterprise。
2. Jon Chu — Khosla Ventures。合伙人——管理规模 $150 亿+。
3. Bin Yu — UC 伯克利。美国国家科学院院士。
4. Mykel Kochenderfer — 斯坦福。航空与自动驾驶的安全关键 AI。
5. Mahesh Sathiamoorthy — Bespoke Labs。联合创始人 & CEO——前 Google DeepMind。
6. Dan Klein — UC 伯克利。Scaled Cognition 联合创始人——融资 $1 亿。
7. Ken Goldberg — UC 伯克利。机器人抓取领域先驱。
8. Joseph Gonzalez — UC 伯克利。vLLM 与 Chatbot Arena 背后的教授。
9. Christopher Potts — 斯坦福。语言学系主任。
10. Larry Blyth — Harvey。法律 AI 产品负责人。
展商阵容
OpenAI · ElevenLabs · Tesla · AWS Startups
显示更多

AI世界杯🏆来啦‼️AGI SUMMIT 2026(AGI 峰会)
2026 年 7 月 18–19 日 · 旧金山艺术宫
15,000 参会者 · 200 展商 · 200 演讲嘉宾 —
戳链接锁票:
Anthropic × OpenAI × 斯坦福 × 伯克利——前沿阵容,同一个舞台。
🎤 重磅嘉宾 Top 15
1. Wendy Lu — Anthropic。工程负责人——Claude for Enterprise(企业版 Claude)。
2. Rohan Varma — OpenAI。Codex 产品负责人;前 Cursor 首位 PM——一年内 $0 → $10 亿。
3. Aengus Lynch — Anthropic。对齐研究员;Agentic Misalignment 研究第一作者,收录进 Claude 4 system card。
4. Raymond Chen — OpenAI。核心技术团队,infra 系统。
5. Dong Meng — OpenAI。工程——AI 基础设施扩展。
6. Prakhar Bhargava — OpenAI。前沿 AI 商业化(GTM)。
7. Zihan (Gavin) Zheng — OpenAI。生产级推理系统。
8. Christopher Manning — 斯坦福。斯坦福 AI 实验室(SAIL)主任、Stanford HAI 联合创始人,GloVe 之父、NLP 先驱。
9. Dan Klein — UC 伯克利。Scaled Cognition 联合创始人——融资 $1 亿。
10. Sebastian Thrun — 斯坦福。Udacity 与 Google X 创始人;谷歌自动驾驶之父。
11. Bin Yu — UC 伯克利。校长讲席教授——美国国家科学院院士。
12. Christopher Potts — 斯坦福。语言学系主任,NLP 与可解释性。
13. Marti Hearst — UC 伯克利。ACM & ACL 双 Fellow。
14. Surya Ganguli — 斯坦福。扩散模型共同发明人;两获 NeurIPS 杰出论文奖。
15. Ken Goldberg — UC 伯克利。机器人抓取领域先驱。
🆕 最新官宣嘉宾(10 位)
1. Wendy Lu — Anthropic。工程负责人——Claude for Enterprise。
2. Jon Chu — Khosla Ventures。合伙人——管理规模 $150 亿+。
3. Bin Yu — UC 伯克利。美国国家科学院院士。
4. Mykel Kochenderfer — 斯坦福。航空与自动驾驶的安全关键 AI。
5. Mahesh Sathiamoorthy — Bespoke Labs。联合创始人 & CEO——前 Google DeepMind。
6. Dan Klein — UC 伯克利。Scaled Cognition 联合创始人——融资 $1 亿。
7. Ken Goldberg — UC 伯克利。机器人抓取领域先驱。
8. Joseph Gonzalez — UC 伯克利。vLLM 与 Chatbot Arena 背后的教授。
9. Christopher Potts — 斯坦福。语言学系主任。
10. Larry Blyth — Harvey。法律 AI 产品负责人。
🏢 展商阵容
OpenAI · ElevenLabs · Tesla · AWS Startups
显示更多


定投的话是可以忽略涨跌,跌的时候多投点的。
作息效果出来了,昨儿也十点多睡的,这会儿醒了,八小时有了。
两年没去体检了,昨儿去了,最害怕的甲状腺没事,于是更好睡了~
人很容易物伤其类,两个好朋友查出甲状腺癌,堂哥打电话说他们分行一个00后也查出来了,让体检一定加甲状腺彩超,这些事给我吓到了真怕一查查出大问题,幸好没事,昨儿医生查完听她说情况我大松一口气🤣
几年前一个算命的师傅说我阳寿86,感谢他,如果是真的就其实挺高寿了
只要临终前脑力还在,体力弱点没事,精神别出问题,认知ok,别失能,生活质量就不会差,但希望别是那种一格电待机的情况,最好半格,还能做点喜欢的事。
现在就可以开始为养老做准备,从身体和心理上,经济上,社会支持上。
🌸身体运动+作息调整+饮食控制,昨儿查了骨密度挺好的没问题
🌸心理上自洽,远离NPD,远离内耗
🌸经济上能工作多久工作多久,最好是工作到86岁人生终章,有助于保持身心健康,社会价值锚定,以及社会联系,定投QQQ,小仓位个股,回调加仓,不用太久,10年,效果就会初显。
🌸社会支持上,爱好,社团,多圈子,保持老关系,新增新关系,每天出现在公司会议,健身房,偶尔闪现办公室,偶尔聚会,商务会议,很难变成孤僻老太🤪
身体健康,心理健康,经济健康,别的都随缘,不奢求暴富,不奢求被爱,老了不奢求长寿,骗子就骗不到我,还防渣男防套路hhh
截止到今天已经没有一段恋爱长过我和Harvey还有L哥共事的时间了,我希望能一直这样下去并且私心希望他们即使80了也不要退休。
显示更多