搜索结果 serverlessjp
serverlessjp 贴吧
一个关键词就是一个贴吧,路径全站唯一。
用户
未找到
包含 serverlessjp 的推特
用 Serverless 的可以看看这个网站
里面有各种云平台被刷爆的案例,啥平台都有,cf/vercel/google/aws/ 最近几个居然都是 cf 的 Durable Object,这玩意儿Vibe Coding 还是直接别用了吧
显示更多


OtterHub:基于 Cloudflare 与 Telegram 的 Serverless 私人文件存储工具


2.5GB 冷启动不到 2 分钟…………
我在前厂给大模型 serverless 部署的优化是 8GB 冷启动不到 20 秒。

Avarok Cybersecurity 开源了 Atlas,一个用 Rust + CUDA 从零写的大模型推理引擎。它不依赖 Python 和 PyTorch,项目方称 Docker 镜像约 2.5GB,冷启动不到 2 分钟,目前主要面向 NVIDIA DGX Spark 的 GB10 平台优化。
官网模型矩阵显示,Atlas 在单台 DGX Spark 上跑 Qwen3.5-35B-A3B 可到约 130 tok/s,跑 Qwen3.6-35B-A3B 约 71 tok/s。Atlas 官网和 Hugging Face 页面称,在同硬件下,Qwen3.5-35B 平均约 111 tok/s、峰值 130 tok/s,vLLM 约 37 至 38 tok/s。
这组「3 倍 vLLM」数据来自项目方公开基准。GitHub README 写明,测试使用的是「法国首都是哪」这类短 prompt,生成上限不超过 30 个 token,temperature 为 0.1。这个口径更接近短请求、低并发、快速响应场景,也正好对应 Atlas 想打的卖点:用更小镜像、更少依赖和更快冷启动,把本地大模型服务变得更轻。
Atlas 现在仍是早期项目,真实生产场景还要看后续长文本、高并发和复杂工具调用测试。GitHub 上已有用户反馈输出质量和工具调用稳定性问题,相关 Issue 截至 2026 年 5 月 11 日仍处于 Open 状态。对开发者来说,它更像一个值得关注的新推理底座,而不是已经能全面替代 vLLM 的成熟方案。
显示更多

Anthropic 发布全新的 MCP 规范:可将 MCP 服务器部署到云上
以前 MCP 服务器有个毛病:客户端得先握手拿一个会话 ID,之后每次请求都必须回到同一台机器
加机器扩容没用,serverless 也跑不了
新规范把这条规矩废了:握手和会话 ID 直接删除,每个请求自带身份信息,哪台机器都能接,挂个最普通的负载均衡器就行。
打个比方:
老 MCP 像打电话,你先拨号(initialize 握手),接线员给你一个分机号(Mcp-Session-Id),之后你每说一句话都靠这个分机号认人。想换个接线员?对不起,只有原来那位记得你刚才说了什么。
新 MCP 像寄快递,每个包裹上都贴着完整的寄件人、收件人和内容说明,谁拿到都能处理,不需要先跟谁打招呼。
显示更多

不买 VPS,也能搭一个轻量私人文件存储?
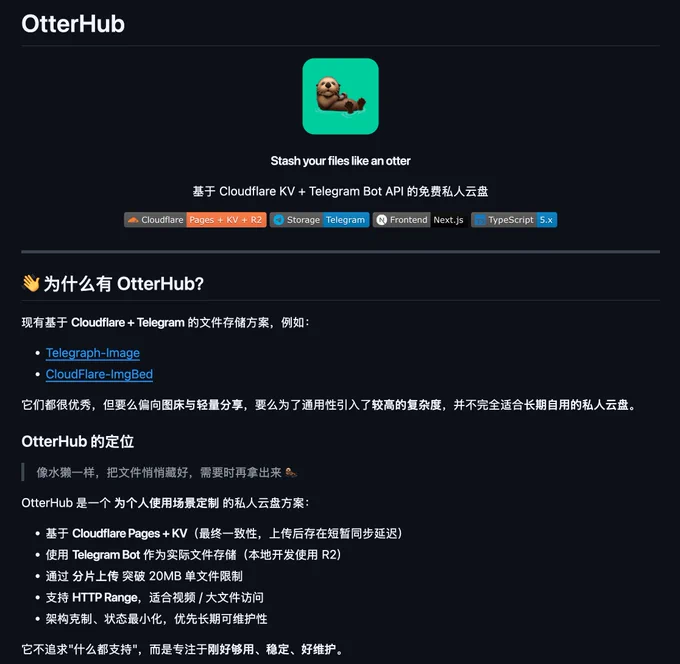
OtterHub:基于 Cloudflare 与 Telegram 的 Serverless 私人文件存储工具
用 Telegram 的机器人(Bot API)当作实际存储文件的后端仓库,用 Cloudflare 的 KV 数据库来记录文件名、标签等元数据
最后用 Cloudflare Pages 跑一个前端网页
只需配置现有云服务账号,就能以较低维护成本跑起来
显示更多

推荐这篇公告,一个重量级的开源模型托管合作。
首个 3T 级开源模型通过美国推理基础设施向开发者开放——后续模型同步首发。
Together AI 在 7 月 29 日宣布与 Moonshot AI 达成战略合作:Together AI 成为 Kimi K3 及未来所有 Moonshot 开源模型的美国托管平台。
合作内容
• Kimi K3 已在 Together AI 上线,通过 moonshotai/Kimi-K3 端点访问
• 未来所有 Moonshot 开源模型都将在发布当天同步上线 Together
• 支持微调:开发者可以用自己的数据对 Kimi 模型做后训练,同时可选择移除 MIT 许可证中的 attribution 要求
• 三层部署选项:Serverless(按量)、Provisioned Throughput(预留容量 + 99% SLA)、Dedicated Inference(专有实例)
定价
• 输入 $3.00 / 1M token(缓存 $0.30)
• 输出 $15.00 / 1M token
• FP4 量化推理
战略意义
Together AI 的推理栈已经为 Cursor、Y Combinator 和 Decagon 等公司的 agentic 和编程负载提供生产服务。这次合作意味着开发者可以通过一套 API 同时访问 Kimi K3、LLaMA、GLM 等所有主流开源模型,不需要为每个新模型配置新的 SDK 或账户。
Moonshot 端——Kimi K3 作为首个开源 3T 级模型,在国内已经通过 API 服务广泛部署,但美国开发者此前缺乏一个可靠的托管方案。Together AI 填补了这个空白。
原文:
#KimiK3# #TogetherAI# #OpenSource#
显示更多


AWS Lambda 现在支持 Self-managed S3 code storage
以前Lambda 部署代码时,会把 ZIP 包复制到 AWS 管理的存储空间,占用 Lambda code storage quota
现在:
Lambda 可以直接引用你自己 S3 Bucket 中的代码
不需要额外复制代码包
代码存储容量由你的 S3 管理
支持 Lambda Functions 和 Layers
这个变化对于拥有大量 Serverless 应用的团队尤其有价值:
多环境部署
大量 Lambda Functions
多个 Lambda Layers
CI/CD 自动化发布流程
不过需要注意:
1. 不会提升单个 Lambda 函数 ZIP 包大小限制(250MB unzipped)
2. Container Image 仍然使用 ECR
#AWS# #Lambda# #Serverless# #CloudComputing#
显示更多

我理解SaaS的逻辑,你要尽可能沟通协作,分享链接,添加人,一堆人七手八脚协同工作,一个流程要几个人分别走完,所以必须把infra撘到server上面去。
我不懂personal AI Agent要上云的逻辑,都是私密的东西,藏着自己的密码、联系人、文件、信息、所有authentication,你几乎不可能跟任何人分享你的AI Agent接入端口,完全是你自己的专属禁脔。
这玩意儿上云的唯一逻辑, 就是一个hosted container永远不断电,你自己的电脑有1%的概率断网或者断电,这样一些long horizon tasks可以24小时跑在上面。
问题是,绝大多数人早就养成了自己电脑24小时不关机的习惯,这种任务放在本地完全正确,完全不用全塞进你给我管理的container里面。
所以我说,muse和cue以及dots迟早会被反噬,迟早还会都放在本地跑,
单纯一个原因,就是一个桌面级virtual machine非常昂贵,有OS license授权,有GPU,有额外的各种资源,整个OS巨大,不能像linux kernel一样裁剪到2GB左右运行,
费钱,费CPU,费GPU,费内存,费硬盘,一切都费,跟你跑一个serverless、一个S3 storage或者某个巨大database instance或者专门request/response的EC2根本比不了,theoraticallly这东西的成本价就他妈压根降不下来,而运行的又是你自己的那点私密工作。
所以我说,muse、cue、dots这个商业模式是彻底跑不通的,就是他妈太贵了,绝大多数人是受不了的,
最后肯定还是跑在你本地,最实惠,最方便,最卫生。
显示更多