檢索結果 deepseek多模态
deepseek多模态 貼吧
一個關鍵字就是一個貼吧,路徑全站唯一。
用戶
未找到
包含 deepseek多模态 的搜尋結果

DeepSeek 多模态大语言模型的论文《Thinking with Visual Primitives》已经公开
底座是 DeepSeek-V4-Flash,MoE架构,总参数量 284B,激活参数量 13B。
自研 DeepSeek‑ViT 视觉编码模型,14×14 patch,输出后 3×3 空间压缩,再接入 LLM。
模型在回答时不仅进行文字推理,还会同时通过画框、打点等“视觉原语”进行思考。
在极低的 Token 成本下,其效果能和 GPT-5.4、Claude 以及 Gemini 在一些前沿指标上对齐,甚至有的指标能反超。
顯示更多

左边两台算力舱在移植 DeepSeek 多模态未审查版
第三台在把 Qwen 3.8 27B 的未审查版的上下文扩展到 900K,做性能对比测试
第四台在修复 Qwen 3.8 Flash Next 未审查版的输出多语言混合的问题
右下角那台小的用来阅读英伟达的论文
这 5 台算力仓都在干活,等他们干活的时候,我 3D 打印一把赛博朋克的激光枪吧😎
顯示更多

Deepseek 的多模态模型全量了。
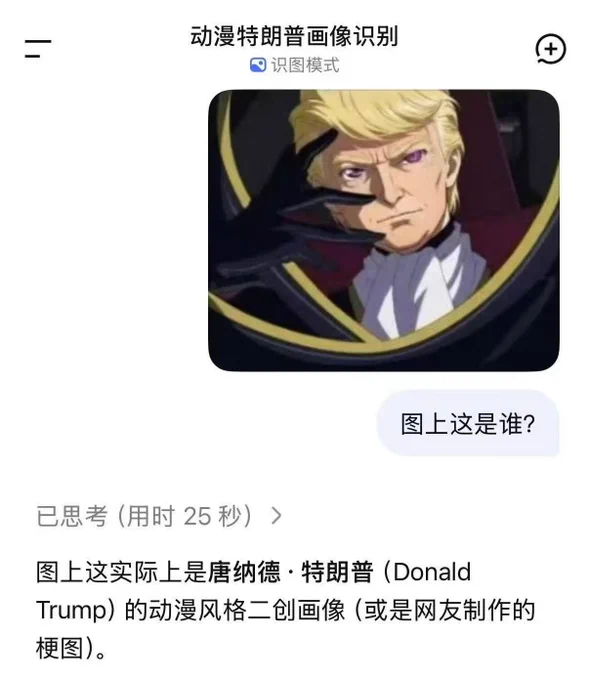
目前可以在网页版的识图模式尝试,看起来是一个单独的多模态模型


我在尝试用 Claude Code 接 deepseek v4 pro,但是 deepseek 不是多模态模型,不支持图片输入。
有解决办法吗?


腾讯这次把 WorkBuddy 当战略级资源砸下去,逻辑很清晰:不抢“最强模型”的牌,抢“办公入口”的牌。底层云端 7×24 托管重复活、中层 100+ 领域专家可训练专属模型、顶层跨部门复用 AI 专家,微信/企微发一句话就能调度——这套“数字员工”架构,本质是把 Agent 从个人提效工具升级成组织级资产。
和海外三家的差异,不是谁聪明,是“从哪长出来”:
Claude(Anthropic):从“代码仓库+长上下文”长出来。Claude Code / Cowork 强在复杂工程推理、跨文件重构、远程沙箱隔离,是给开发者和高知白领用的“私人员工”,但脱离 GitHub/Slack 体系就残血,且不碰微信企微。
OpenAI ChatGPT Work / Codex:从“ChatGPT 订阅池”长出来。优势是研究摘要、多模态生成、轻量 Codex 脚本化调用,云端零门槛,但中文办公链路(文档/审批/IM 催办)要靠插件拼,普通员工配置成本不低。
Grok(xAI):从“X 广场+Cursor 工程血统”长出来。Grok Bot 定位“永远在线的 AI 队友”,编码和实时舆情强,但企业办公连接器弱,国内合规与本土 IM 基本是空白。
WorkBuddy:从“微信关系链+腾讯文档/企微/乐享”长出来。别人卖 Agent,腾讯卖“你老板同事客户都在的地方”——聊天即指令、不迁移现有 OA、按月收“数字员工”费、接微信支付 AI 专属卡和 SkillHub 第三方技能市场,闭环做得最像 SaaS 而不是 demo。
短板也直白:模型层靠混元+DeepSeek+GLM 多模型切换,单模型推理上限打不过 Claude Opus 级;代码深度不及 Claude Code;海外扩展受数据驻留限制。但腾讯要的不是 AGI 皇冠,是避免腾讯文档/企微在 AI 时代沦为被 Agent 调用的管道——把入口、账号、支付、技能交易全攥手里,未来企业买 AI 人力首先想到的是“租腾讯的数字员工”,不是“装个 Claude”。
下面这个work buddy的上手搭建教程还是非常实用的,可以参考。
顯示更多


Deepseek正式推出多模态模型!
DeepSeek-V4-Flash-Vision-Exp
🔹 它在文本、代理、推理和世界知识能力上与 DeepSeek-V4-Flash 相当。
🔹 在多模态代理基准测试上,相对于 V4-Flash 实现了重大飞跃,多模态代理性能接近 Opus-4.8。
顯示更多



就在DeepSeek V4山雨欲来的前夜,晚点LatePost的更新爆了不少料:
- 最近半年,DeepSeek的核心员工,包括DeepSeek第一代模型作者王炳宣、DeepSeek-OCR系列作者魏浩然、DeepSeek-R1作者郭达雅、Janus-Pro贡献者阮翀等人,都被各家大厂给挖走了,更不用说已经在小米做出了成果的前研究员罗福莉;
- 尽管如此,DeepSeek依然不怎么卷,同行的每周工作时间都奔着80小时去了,DeepSeek的大多数员工还是遵循着早上不打卡、下午6-7点走人的规律,因为老板梁文锋相信一个人每天高质量输出的时间不会超过8小时,员工加班疲劳引起的昏庸工作质量,反而会浪费宝贵的算力资源,给公司造成损失;
- 搞AI和做量化之间的关系其实相当紧密,2016年,DeepMind的创始人哈萨比斯就组建过量化团队,希望能为刚刚脱离Google的公司创收,结果没赚到钱,而幻方则是倒过来的,也是在同一年开始用GPU的深度学习算力去干实盘交易,成功让梁文锋以30岁的年纪实现财富自由,再才组建了DeepSeek;
- 2023年的时候,梁文锋小范围见过一些投资人,但提出的构想类似OpenAI和微软的投资协议,投资方需要接受一个回报上限,这在投资者看来是没道理的,所以见完一轮之后,没有任何机构愿意投DeepSeek,而在大模型火了之后,梁文锋把和投资人建联的通道直接关闭了;
- 在公司里,梁文锋参与最多的是基模架构工作,然后就是充当不同团队之间的粘合剂,DeepSeek内部鼓励交叉协作,一个团队的周会也会向其他团队开放,这种开放组织很容易被规模扩张给破坏,所以DeepSeek对于核心团队的增加相当谨慎;
- 去年以来,外部世界发生巨变,既有DeepSeek-V3/R1的一炮走红,也有竞争烈度的大幅升级,DeepSeek没有加入任何战局,依然在自己重视的效率优化(注意力机制)、架构改进(mHC)和非主流探索(OCR)上面努力,梁文锋甚至招进了一些神经科学和脑科学背景的顾问,对人脑原理兴趣大增;
- 这也意味着DeepSeek错过了去年最重要的两条主线,一个是AI Coding,这里不只有商业价值的爆发,还引发了以龙虾为代表的Agentic应用形态,DeepSeek-V3.2完全被其他国产模型盖过了风头,另一个是多模态生成,从GPT-4o到Nano Banana再到Seedance 2.0,全都颠覆性的创造了海量增长,但梁文锋认为多模态「不是智能的主线」;
- 外界期待DeepSeek每次出手都能像去年年初那样石破天惊,这可能有些强人所难,也未必是梁文锋的目标,而他也需要稳定团队抗拒财富诱惑的心力,猎头给DeepSeek员工开出2-3倍的薪水,而且这还是建立在DeepSeek本身工资就不低的前提下,确实也有员工做出了跳槽去参与更确定性的、持续参与业界最强模型工作的选择;
- 留下的人当然还是占了大多数,他们习惯了相对宽松的研究氛围,也愿意做非竞争驱动的探索,在DeepSeek的价值体系里,原创的排序是要比最强更靠前的,它们本质上并不冲突,有时候实现了原创也就自然实现了最强,但在进入Agentic版本后,工程能力变得更重要了,而这正好进入了DeepSeek没有过多投入的地方;
- 于是梁文锋也比较少见的做出了应变回应,最近一段时间,他开始启动了对公司的估值,这意味着可以给团队更有刺激性的财富预期,同时也开始招揽模型策略产品经理,明确要求深度使用过Claude Code、OpenClaw、Manus;
- 坚持该坚持的,改变该改变的,至于什么是该坚持的、什么是该改变的,这个判断还是得由梁文锋来拿捏,「奇迹之所以是奇迹,就是因为它不常发生,是小概率事件。在中国这个崇尚竞争和结果说话的环境里,敢于追求独特目标的 DeepSeek 的存在本身,是一个令人惊喜的小概率事件。」
顯示更多

有 DeepSeek 的,赶紧试一下,多模态模型终于来了。
这次是随机抽选,给灰度测试权限。现在打开 DeepSeek 页面,看看有没有识图模式,有就是被抽到了。
顯示更多