

Max For AI
@MaxForAI
Head of hype @lobehub
Prev @listenhub @Sapient_Int
没啥好看的,也就发点AI相关的内容🫡
同名小红书4万粉丝,公众号01Founder(长文首发)
观点仅代表个人
更多请访问网站⬇️(欢迎商务、合作
3K 正在關注 41.3K 粉絲

未来几年真正有价值的Agent项目只会剩下Agent清算所和Personal Agent。
剩下的都是过眼云烟而已。


看起来OpenAI即将公布新的ChatGPT订阅方案👀
目前ChatGPT Pro 的5x和20x已经改名了,现在分别叫Pro Standard和Pro More,定价页也删掉了之前 5x / 20x Plus 用量的描述。
顯示更多

是的,其实几个问题就能问出来之前到底有没有做过harness了

这周帮其他团队电话面试了几个应聘垂直业务 agent 研发的候选人,基本上我开头一个问题就能初筛掉 90% 的面试者:
/goal 命令是如何实现的?
真正做过 harness 的人才知道 goal 有多难搞:完成判断、验收标准、状态持久化、异常兜底、预算控制、上下文压缩不丢任务、缓存命中不被打乱。。。
顯示更多

妈的被资本做局了....
o nice!!我们即将拥有一次reset!!
今天在外面玩了一天,然后发现大家都被Tibo骗光了额度😂
早上说重置,但等了一天重置却还没来


o nice!!我们即将拥有一次reset!!

o yes… we’re back in action and we’ll reset usage limits for all paid users across codex and ChatGPT work
sorry about the brief disruption!
(and yes we have a special spare codex when things are down to help us out)
顯示更多
我开始怀疑Anthropic是歧视黄种人了.....
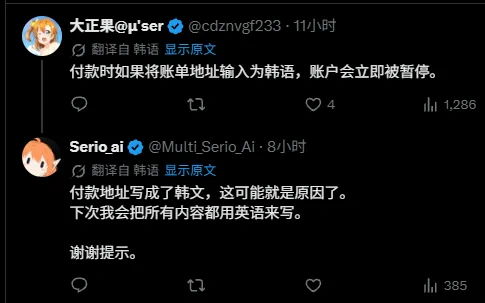
刚看到韩国朋友表示,自己的账号突然被 Anthropic 直接停用了。
没有提前警告,账号直接显示This organization has been disabled.
更离谱的是,评论区有别的韩国人提醒他:可能是因为付款时,Billing Address 用韩文填写了。
博主自己一看,还真是韩文地址,于是怀疑这可能触发了 Anthropic 的风控。
但韩国本身就是 Claude 官方支持地区,Anthropic 也没有公开说韩文地址会导致封号。
而且今年 GitHub 上已经出现过不少类似投诉:正常 Pro 用户突然收到 suspicious signals / Usage Policy 的封禁邮件,有人甚至连官方申诉页面都进不去。
模型越来越强是一回事,但账号风控如果还是这种宁可错杀、不太解释、申诉又困难的状态.....
A/畜什么时候死啊。。。。。
顯示更多

언행불일치는 그 회사 사장만 하는 줄 알았는데.
클로드 Pro 결제 직후 개막차단 당하는 사람들이 꽤 있다곤 들었는데 그게 제가 될 거라곤.
Oai의 상냥한 경고랑 다르게 시작부터 불꽃꺼져싸다구 맞으니 그 성능이 얼마가 됬든 쓰고 싶은 생각이 팍 사라져 버리네요. 그래놓고 이의제기 신청했는데 '이의제기는 1회밖에 안됩니다.'경고 안내 넣어놓은 것도 그렇고 이게 과연 고객한테 물건을 파는 기업의 태도인가 싶구요. 연휴에 카드사 대응 될 지 모르겠는데 그냥 카드사 분쟁 환불 절차 들어가는 게 빠를 거 같군요.
누워서 눈 감을때마다 짜증나서 깨는 걸 반복하다가 그냥 안 자고 제사 지내러 갈 생각.
顯示更多

我开始怀疑Anthropic是歧视黄种人了.....
刚看到韩国朋友表示,自己的账号突然被 Anthropic 直接停用了。
没有提前警告,账号直接显示This organization has been disabled.
更离谱的是,评论区有别的韩国人提醒他:可能是因为付款时,Billing Address 用韩文填写了。
博主自己一看,还真是韩文地址,于是怀疑这可能触发了 Anthropic 的风控。
但韩国本身就是 Claude 官方支持地区,Anthropic 也没有公开说韩文地址会导致封号。
而且今年 GitHub 上已经出现过不少类似投诉:正常 Pro 用户突然收到 suspicious signals / Usage Policy 的封禁邮件,有人甚至连官方申诉页面都进不去。
模型越来越强是一回事,但账号风控如果还是这种宁可错杀、不太解释、申诉又困难的状态.....
A/畜什么时候死啊。。。。。
顯示更多
언행불일치는 그 회사 사장만 하는 줄 알았는데.
클로드 Pro 결제 직후 개막차단 당하는 사람들이 꽤 있다곤 들었는데 그게 제가 될 거라곤.
Oai의 상냥한 경고랑 다르게 시작부터 불꽃꺼져싸다구 맞으니 그 성능이 얼마가 됬든 쓰고 싶은 생각이 팍 사라져 버리네요. 그래놓고 이의제기 신청했는데 '이의제기는 1회밖에 안됩니다.'경고 안내 넣어놓은 것도 그렇고 이게 과연 고객한테 물건을 파는 기업의 태도인가 싶구요. 연휴에 카드사 대응 될 지 모르겠는데 그냥 카드사 분쟁 환불 절차 들어가는 게 빠를 거 같군요.
누워서 눈 감을때마다 짜증나서 깨는 걸 반복하다가 그냥 안 자고 제사 지내러 갈 생각.
顯示更多

我服了...美团龙猫居然中秋夜发模型....
刚刚,LongCat-2.5-Preview 正式上线了👀
1.6T 总参数,约 48B 激活,100 万 Token 上下文,原生多模态,而且这次明显是冲着长流程 Agent 去的。
官方直接点名了 Terminal、浏览器、GUI、电子表格、设计工具这些场景。
价格和之前LongCat2.0一样
现在限时价是输入 $0.30 / 1M Token,缓存输入 $0.006 / 1M Token,输出 $1.20 / 1M Token。
更离谱的是,美团可能也知道大家中秋晚上没事干,直接给所有现有用户送了 500 万免费 Token,拿去试 LongCat-2.5-Preview。
所以我今晚估计得加个班了……
其实现在这种模型,我已经不太在意参数又大了多少。反而最想测的是,它能不能真的连续跑几十步,在浏览器、Terminal、表格和 GUI 之间来回操作,最后还能记得自己一开始到底要干嘛。
毕竟 500 万 Token 都塞我手里了,不烧白不烧对吧
顯示更多

LongCat-2.5-Preview is now live.
1.6T parameters. ~48B active. A 1M-token context window.
Natively multimodal. Built to take on long-horizon tasks.
From terminals and browsers to GUIs, spreadsheets, and design tools.
Try it now:
🚀 API:
💬 Chat:
顯示更多

很多人可能还没意识到,中国大模型其实已经进入了一段尴尬期。
什么叫尴尬期呢?
你如果养过猫,尤其是布偶这种猫,应该知道它从小长大的时候,会经历一段尴尬期。
旧毛掉了,新毛还没完全长出来,看起来多少有点别扭。
但再过一段时间,等新毛长齐了,漂亮的那个状态又会回来。
我觉得现在国内大模型差不多就是这个阶段,核心主要是有三个问题。
第一个,就是模型越训越大,但训练算力开始有点跟不上了。
现在大家都在往更大的模型走,5T、8T、10T 这种规模也开始被摆到台面上。
比如阿里在本次的云栖大会上提到,未来可能会训练 5T 到 10T 参数规模的模型。
Kimi、GLM 也都在继续往更大规模走。
但问题是,模型规模可以继续往上加,训练卡没有那么容易增加。
大家都知道 Scaling 还没有完全走到头,但在国内,算力确实已经越来越容易变成一个现实限制。
第二个是推理,或者说模型上线之后怎么稳定提供服务。
之前梁文锋在那个所谓流出的DeepSeek投资人会议纪要里也提到过,国内之前为什么很多 MoE 模型会把激活参数控制在几十 B,一个重要原因就是推理资源。
因为模型训出来是一回事,能不能长期、稳定、大规模地给用户用,是另外一回事。
虽然那个会议纪要出来之后,Kimi 也发了 K3 这种2.4T参数的模型,但这个问题还是没有被缓解。
一些新模型(就比如K3还有刚发的Step5Preview)刚上线的时候速度很好,但很快可能就会遇到限速、排队、额度收紧之类的情况。
这说明推理算力的问题其实还没有完全解决。
我们的团队们很难像 OpenAI 那样,时不时直接给用户 reset 一轮额度。
因为模型越大,每多放一点额度,背后都对应着真实的推理成本。
第三个,就是价格和定位的问题。
模型越做越大,推理成本越高,价格自然也很难一直维持在原来的水平。
但国内模型之前比较明显的两个优势,一个是开源,一个是性价比。
所以如果价格慢慢往上涨,就会出现一个新的问题:
如果价格差距越来越小,那用户为什么一定要选择国内模型?
尤其到了 Agent 时代,一次任务消耗的 Token 可能会比普通聊天高很多,价格会变得比以前更敏感。
最后很可能还是会回到一个很朴素的问题:效果差不多的情况下,谁便宜就用谁。
那就会有人选择赔本赚吆喝喽,当然我没有特指某些模型哈。
包括 DeepSeek 自己,其实也经历过价格调整。
所以我觉得,国内大模型现在确实处在一个比较微妙的阶段。
模型做大之后,推理算力又会成为新的限制。
推理成本上升之后,价格也需要调整,但价格一上去,又会影响原本的性价比优势。
有点像猫长大的尴尬期。
旧毛已经开始掉了,新毛还没有完全长出来。
接下来这段时间,得看国内厂商怎么把这几个问题一起解决掉(下一条我会聊这个)。
顯示更多


中秋快乐!刚刚看到一篇新论文 Memory Attention,感觉可能是个划时代的新注意力架构,给大家分享一下。
MA这篇的核心是Transformer 里的 V,可能根本没必要每次都重新算。
所以直接开始动 Attention 里最经典的 QKV 结构了。
传统 Attention 里,每个 token 都要从当前 hidden state 重新计算:
Q = XWq
K = XWk
V = XWv
但本文作者 @Jo1uck 问了一个很朴素的问题:
V 里面有多少东西,真的需要每次根据上下文重新算?
同一个 token 在不同句子里,显然存在大量可以复用的信息。
于是他们参考 Engram 这类 Memory 架构,给每个 token 建了一套可学习的 memory,然后更激进地把独立的 value projection 直接干掉:
V = K + Memory[token]
K 负责保留上下文信息,Memory 负责保存 token 自身可以复用的信息。
这样推理时,原来计算 V 的一次矩阵乘法,基本就变成了:查表 + 加法(这会大幅减少计算量)。
然后事情开始变得有意思了。
因为 Memory 只跟 token ID 和层数有关,所以甚至可以提前知道要读哪块数据,直接把这部分参数扔到 CPU,GPU 需要的时候提前 Prefetch。
实验里,MA-Offload 模型总参数是普通模型的 2.08 倍,但 GPU 上实际常驻的参数反而比普通 Transformer 少了 7.38%,推理延迟基本维持在同一水平。
训练上,在两个不同规模实验里,达到相同 loss 所需 token 数分别提升到了 1.42× 和 1.16× 的 token efficiency,也就是大约少用 29.6% 和 13.8% 的训练 token。
下游平均成绩也基本都比对应的 Standard Attention 更高。
更骚的是,作者还提出了一个 MA-Recall:
既然历史 V 可以通过 K + token memory 重新构造,那么理论上甚至不用一直保存完整的 V Cache,只保存 K 和 token ID,在需要的时候把 V 重建出来。
按论文的理论计算,这部分 KV Cache 可以砍掉接近一半,不过目前还只是分析,没有进入实际推理实验。
我觉得这篇的方向挺值得关注的。
过去大家做 Memory,更多是在 Transformer 外面继续加东西。
Memory Attention 开始反过来问:既然 Memory 已经能记住这些东西,那 Transformer 里面原来那些计算,是不是可以直接删掉?
当然论文自己写的也很克制:MA 用了更多参数,所以目前的收益还不能证明全部来自架构本身,而不是单纯的参数量增加。
但如果这条路继续成立,下一代模型的变化可能不只是 Attention 越做越复杂。
也可能是我们用了快十年的 QKV,终于开始有人认真考虑:哪些东西其实根本不用算。
顯示更多


Could this be a direction for future model architectures?
Introducing Memory Attention (MA).







