

Michael Guo
@Michaelzsguo
Building AI agents and AI-native orgs. Demystifying AI in practice. EN/中文 (Selected build notes, experiments, and practical tips at the website link.)
434 正在關注 12.1K 粉絲
AI Coding Agent 写代码的速度,已经远远超过了传统开发基础设施的承载能力。Git 的分布式架构和完整仓库复制机制,正在成为严重的扩展瓶颈。
有意思的是,Anthropic 和 OpenAI 不约而同地开发了自己的版本控制系统,一家叫 Scion,另一家叫 Pando。
两家公司遇到了同一个问题,却选择了截然不同的技术路线:Anthropic 的 Scion:重新设计版本控制系统,替代 Git。OpenAI 的 Pando:保留 Git 协议和客户端,重新设计服务器后端。
把这两套方案放在一起对比,很有意思。
顯示更多


OpenAI 在招人,还有一些新岗位即将开放。不过申请之前,先好好琢磨一下这位 OpenAI 员工的建议。
Wulfie Bain 负责面向创业公司的应用 AI 工程团队。从 BCG、自己创业到 OpenAI,他看过数千份简历。他发现,有些很优秀的候选人,简历却没能体现出自己的实力。
他的建议打眼一看好像是老生常谈, 但常常被忽略:
- 尽量简洁。 理想是一页,但内容是否相关,比硬凑页数更重要。简历本身也在展示你的书面表达能力,以及能不能分清主次。
- 删掉无关经历。 留下的每段经历,都要让人看懂它和岗位有什么关系。高中时再值得骄傲的成绩,到今天也未必还需要写进去。
- 写清成果。 “重新设计了一个 Agent 的架构”,还看不出价值;“把延迟降低了 2 秒,并改善了客户满意度”,才说明你带来了什么。如果做销售,就讲收入。
- 让人容易扫读。 重点加粗,每段经历里最有说服力的成果放在最前面。招聘者面对一大堆简历,要能很快看出为什么值得约你面试。
他还建议:能找到内推当然好,但不认识人,也要去官网申请。他自己就是这样进入 OpenAI 的。
顯示更多

Tips for people applying to open/upcoming roles on my team at @OpenAI (hiring!!): part 3, CV edition
1. Keep it concise
2. No irrelevant experiences
3. Show impact, not action
4. Make it easy to skim
Some (pretty cool) roles coming soon. Here's how to stand out ⬇️
顯示更多
腾讯混元4即将发布,发展速度不可谓不快。突然发现,把腾讯和 Meta 这几年的 AI 旅程放在一起看,两家公司几乎走出了同一条曲线。
两家都有国民级产品和庞大的生态:一边是微信、QQ、游戏和腾讯云,另一边是 Facebook、Instagram 和 WhatsApp。但已有的产品优势,并没有让两家在大模型上一路顺风。Meta 经历了 Llama 4 的失意,腾讯也对混元的研发体系进行了重整。
接着,两家都引入了关键人物。Meta 请来 Scale AI 创始人 Alexandr Wang,成立 MSL,重建 AI 技术栈;腾讯请来前 OpenAI 研究员姚顺雨,把模型、数据和基础设施重新梳理。随后,一边推出 Muse Spark、Muse Wonder,另一边接连发布 Hy3、Hy4 preview。
再往产品看,又碰上了:Meta 做出了个人 Agent Muse,腾讯做出了办公 Agent WorkBuddy。一个帮你处理生活中的任务,一个帮你完成工作。两家都在把原本让用户聊天、获取信息的入口,延伸成替用户执行任务的入口。
顯示更多


国内大公司可以把个人账号带到公司使用?

当 Agent 越来越能包办我们手里的任务,怎么保持批判性思维,不让自己的脑袋也跟着“变懒变胖”?
Anthropic 的 Addy Osmani 写了篇文章,介绍了几套很有益的“体操”:
- 问 AI 之前,先写下自己的判断。 哪怕只是一个粗糙的猜测。读过一个流畅、完整的答案后,就很难再想象其他可能了。
- 让 AI 从反面挑战你。 对拿不准的问题,让不同模型分别提出反对意见,再自己判断。追问一句:什么情况会证明这个结论是错的?然后去验证。
- 先定验收标准,再看结果。 测试全绿,具体证明了什么?还有什么没测到?收到“已完成”时,先看它实际执行的命令和输出,再看总结。
- 检查自己到底懂了多少。 让 Agent 列出它替你做的决定和假设;随机挑几行代码,试着解释;读完文档,关掉它,凭记忆复述主要论点。也可以让 AI 出题考你。
- 用自己的话写清需求。 给谁用、哪些不做、怎样才算完成。来回改了两轮还不对,就停下来重写需求,让 Agent 追问你没想清楚的地方。
- 给重要技能留一点手动练习。 每周不用 Agent 写一点代码,或亲手做一件你不愿忘记怎么做的事。每月盘点一次:哪些事情已经不再亲自做了,哪些能力还想保留。
顯示更多

DeepSeek V5计划用国产芯片进行预训练!这也意味着,DeepSeek和华为正在一起解决CUDA之外的软件路径:华为提供CANN底层平台,DeepSeek补齐自己模型所需的计算库、通信库和算子。对DeepSeek来说,先让自己的训练流程在国产芯片上高效跑通,就已经能减少对CUDA的依赖。
顯示更多

DeepSeek V5计划用国产芯片进行预训练!
据报道,DeepSeek下一代大模型V5计划采用华为昇腾950作为核心训练算力,目标在2027年落地。此前双方在推理端的合作,将进一步延伸到从头训练模型。
国产芯片不是早就能跑DeepSeek了吗?为什么训练要晚这么久?
从工程上看,推理是使用已经训练好的模型,主要做前向计算,权重通常不变,可以通过量化、优化算子、拆分部署逐步适配。华为早在2025年就用昇腾910B、910C承接DeepSeek的推理需求,但也经历了数月的联合优化。
预训练还要反向传播、计算梯度、更新参数,保存更多中间数据,并让大量芯片反复交换数据、协同工作。显存、通信、数值稳定性、故障恢复,任何一个环节跟不上,都可能让整个集群的效率掉下来。能把模型跑起来,距离高效、稳定地把模型训练出来,还有很长一段工程距离。
其实这段距离已经在逐步缩短。今年已有研究团队在昇腾集群上完成DeepSeek-V4系列的全参数后训练和领域继续预训练。这些工作建立在已有模型之上;这次V5的计划,则把目标推进到了基础预训练。
芯片方面,昇腾950分为950PR和950DT:PR偏重推理中处理输入的Prefill阶段,DT面向训练和逐字生成的Decode阶段。按华为公布的规格,950DT配备144GB内存,访存带宽4TB/s,芯片互联带宽2TB/s,FP8峰值算力约1 PFLOPS,也就是每秒约1000万亿次浮点运算。大容量内存、高带宽互联,以及对FP8等低精度格式的原生支持,都是支撑大模型训练的重要条件。
软件也在补齐。DeepSeek近期公开了面向昇腾的DeepGEMM计算库和DeepEP通信库,前者优化矩阵计算,后者处理MoE模型中不同专家之间的数据交换。两者都尽量对齐原有接口,减少迁移时需要重写的代码。要让国产芯片承担预训练,这些底层工程和芯片本身一样关键。
顯示更多

DeepSeek V5计划用国产芯片进行预训练!
据报道,DeepSeek下一代大模型V5计划采用华为昇腾950作为核心训练算力,目标在2027年落地。此前双方在推理端的合作,将进一步延伸到从头训练模型。
国产芯片不是早就能跑DeepSeek了吗?为什么训练要晚这么久?
从工程上看,推理是使用已经训练好的模型,主要做前向计算,权重通常不变,可以通过量化、优化算子、拆分部署逐步适配。华为早在2025年就用昇腾910B、910C承接DeepSeek的推理需求,但也经历了数月的联合优化。
预训练还要反向传播、计算梯度、更新参数,保存更多中间数据,并让大量芯片反复交换数据、协同工作。显存、通信、数值稳定性、故障恢复,任何一个环节跟不上,都可能让整个集群的效率掉下来。能把模型跑起来,距离高效、稳定地把模型训练出来,还有很长一段工程距离。
其实这段距离已经在逐步缩短。今年已有研究团队在昇腾集群上完成DeepSeek-V4系列的全参数后训练和领域继续预训练。这些工作建立在已有模型之上;这次V5的计划,则把目标推进到了基础预训练。
芯片方面,昇腾950分为950PR和950DT:PR偏重推理中处理输入的Prefill阶段,DT面向训练和逐字生成的Decode阶段。按华为公布的规格,950DT配备144GB内存,访存带宽4TB/s,芯片互联带宽2TB/s,FP8峰值算力约1 PFLOPS,也就是每秒约1000万亿次浮点运算。大容量内存、高带宽互联,以及对FP8等低精度格式的原生支持,都是支撑大模型训练的重要条件。
软件也在补齐。DeepSeek近期公开了面向昇腾的DeepGEMM计算库和DeepEP通信库,前者优化矩阵计算,后者处理MoE模型中不同专家之间的数据交换。两者都尽量对齐原有接口,减少迁移时需要重写的代码。要让国产芯片承担预训练,这些底层工程和芯片本身一样关键。
顯示更多
大模型已经可以通过“外科手术”式的操作(weight space programming)改写模型权重。在这项能力上,头部闭源模型的表现远胜于开源模型。谷歌的新模型 Carbon 表现尤其不俗。
顯示更多

这简直是匪夷所思。
一个 MIT 一年级博士生 Rikiya Takehi,和团队做了一组实验:让 GPT-6 Astra 直接读懂、修改,甚至从零写出另一个神经网络的权重。
他们先从小游戏开始。把四个网络的原始权重交给 Astra,不告诉它游戏名称,也不提供选项,它竟然全部认了出来:打砖块、Pong、吃豆人和 Freeway。这四个网络的结构、输入和可选动作都一样,区别藏在权重里。
接着是修复行为。一个经过强化学习训练的小车网络,只会往坡上冲,始终卡住。Astra 看了权重、场景描述和一次失败记录,在不能调用工具的情况下,一次回复就写出了补丁。只改动 3.5% 的权重,小车就学会了先倒车,再加速冲坡,在 1,024 次测试中全部成功。
他们还让 Astra 从零写权重。给它打砖块的规则、源码和网络结构,不允许训练,也不允许试玩。它直接把“预判球的落点,再移动挡板”的策略写进网络,最终得分超过训练了 5 亿步的 PPO 网络约 20 倍。
然后,他们把同一个问题推到了语言模型上:能不能直接修改 Qwen3.5-0.8B 的权重,让它更擅长数学?
Astra 在检查权重和观察答题表现后,发现这个小模型经常陷入推理循环。它把问题定位到两层 MLP 中的一个方向,只修改了 0.016% 的权重,没有梯度下降,也没有重新训练。
在最多 50 次前向调用的预算内,修改后的模型在相同采样设置下,MATH-500 得分从 7.9% 升到 48.1%,GSM8K 从 13.8% 升到 67.1%。连指令遵循测试 IFEval,也从 21.0% 升到 62.3%。
他们把这个方法叫作 Weight-Space Programming,权重空间编程:让大模型根据任务,直接检查和改写神经网络里的数字。
顯示更多

anthropic这resident脱产研究的职位薪水比资深工程师还高!


Applications are now open for the Anthropic Residency, a paid, fixed-term research program for academics, technical founders, and staff-level engineers who want to make AI safe and beneficial for everyone. No ML background is required.
Apply by November 22:
顯示更多
AI Coding Agent 写代码的速度,已经远远超过了传统开发基础设施的承载能力。Git 的分布式架构和完整仓库复制机制,正在成为严重的扩展瓶颈。
有意思的是,Anthropic 和 OpenAI 不约而同地开发了自己的版本控制系统,一家叫 Scion,另一家叫 Pando。
两家公司遇到了同一个问题,却选择了截然不同的技术路线:Anthropic 的 Scion:重新设计版本控制系统,替代 Git。OpenAI 的 Pando:保留 Git 协议和客户端,重新设计服务器后端。
把这两套方案放在一起对比,很有意思。
顯示更多
这简直是匪夷所思。
一个 MIT 一年级博士生 Rikiya Takehi,和团队做了一组实验:让 GPT-6 Astra 直接读懂、修改,甚至从零写出另一个神经网络的权重。
他们先从小游戏开始。把四个网络的原始权重交给 Astra,不告诉它游戏名称,也不提供选项,它竟然全部认了出来:打砖块、Pong、吃豆人和 Freeway。这四个网络的结构、输入和可选动作都一样,区别藏在权重里。
接着是修复行为。一个经过强化学习训练的小车网络,只会往坡上冲,始终卡住。Astra 看了权重、场景描述和一次失败记录,在不能调用工具的情况下,一次回复就写出了补丁。只改动 3.5% 的权重,小车就学会了先倒车,再加速冲坡,在 1,024 次测试中全部成功。
他们还让 Astra 从零写权重。给它打砖块的规则、源码和网络结构,不允许训练,也不允许试玩。它直接把“预判球的落点,再移动挡板”的策略写进网络,最终得分超过训练了 5 亿步的 PPO 网络约 20 倍。
然后,他们把同一个问题推到了语言模型上:能不能直接修改 Qwen3.5-0.8B 的权重,让它更擅长数学?
Astra 在检查权重和观察答题表现后,发现这个小模型经常陷入推理循环。它把问题定位到两层 MLP 中的一个方向,只修改了 0.016% 的权重,没有梯度下降,也没有重新训练。
在最多 50 次前向调用的预算内,修改后的模型在相同采样设置下,MATH-500 得分从 7.9% 升到 48.1%,GSM8K 从 13.8% 升到 67.1%。连指令遵循测试 IFEval,也从 21.0% 升到 62.3%。
他们把这个方法叫作 Weight-Space Programming,权重空间编程:让大模型根据任务,直接检查和改写神经网络里的数字。
顯示更多
@manateelazycat Linus 一直有力排众议的魄力。很多时候,他直来直去,甚至略显粗鲁,对那些不认同的观点毫不留情地怼回去。虽然有时让人不太舒服,但往往话糙理不糙。Linux 也的确需要和得益于这样一位敢于坚持原则、不轻易妥协的定海神针。
顯示更多
Linus 对 Linux 社区里把反 AI 上升到意识形态的倾向,再次回应!措辞斩钉截铁,一点都不含糊:Linux 不是反 AI 项目,有意见可以 fork,也可以离开。 他还说:没人强迫你用 AI,但你也不能因为自己反感,就阻止别人使用。
Linus 甚至直接说:“Linux 不是、从来不是、以后也不会是什么‘社会正义斗士’项目。”
我很欣赏这种不和稀泥的做法。一个技术社区可以容纳不同态度,但负责人得守住判断标准。否则,对工具的讨论很容易变成对立场的审查,最后大家忙着证明自己站在哪一边,反倒没人关心技术有没有变得更好。
顯示更多

像 Diogo Almeida 一样:
>> 2008 年,代表菲律宾拿下国际数学奥林匹克铜牌。
>> 做过 Google Brain 研究工程师,也曾把《英雄联盟》打到北美前 30、《炉石传说》打到前 2。
>> 加入 OpenAI,参与把 RLHF 用于语言模型训练,成为 2022 年 InstructGPT 论文的共同作者。
>> 参与 ChatGPT、GPT-4 的研发后,继续追问:AI 已经这么聪明了,为什么那么多日常工作仍然无法自动化?
>> 离开 OpenAI,与 Sasha Sheng、Erik Gafni 联合创办 TypeSafe AI,埋头做了两年。
>> 2026 年 9 月,带着 Jev 和 DCVC 领投的 4000 万美元种子轮走到台前。
>> 做一个直接供软件调用的模型:输出选择、分数和置信度,让代码接着执行,把 AI 放进一个个具体的判断环节。
>> 发布约三周后,Jev每天已处理数万亿 token,29.4% 的 Fortune 500 企业找上门来。
>> 今天又宣布完成 a16z 领投的 8.7 亿美元 A 轮融资,估值 75 亿美元,红杉和 DCVC 参投。
发完消息,留下一句:“我们现在想睡觉了。”
顯示更多

Muse 推出已经一个月了,开局相当亮眼。截至 10 月初,下载量已超过 560 万次。按 Apptopia 的估算,在美加 iOS 市场,Muse 首发 12 天就获得了 180 万次下载,超过了 ChatGPT 当年同期的 130 万次。
这背后既有 Meta 强大的分发能力,也离不开 AI 负责人 Alexandr Wang 和团队的投入。
这位 19 岁从 MIT 辍学、创办 Scale AI 的年轻人,接手 Meta 的 AI 业务后,面对过不少质疑。
今年 1 月,连 Meta 前首席 AI 科学家、图灵奖得主 Yann LeCun 都公开批评他“经验不足”。一个靠 AI 数据业务起家的年轻创业者,能不能带领顶尖的 AI 研究团队,确实是外界一直关注的问题。
几个月后,他带领的团队交出了 Muse Spark,如今又有了 Muse。
回头看他去年接受 Shawn Ryan 采访时的一段回答,或许更容易理解他的做事方式。
主持人问:你十六七岁就能把博士难住,是什么感觉?会不会觉得自己特别聪明?
Wang 说,很多人都很聪明,他并不觉得自己天生就比别人聪明多少。但他小时候特别专注于数学,后来是物理,到了高中,又把大量时间投入编程。
他用了一个词:“overdo”,就是比别人投入更多的时间和精力,多走一英里,甚至十英里。只要持续这样做,进步就会比别人快很多。
很多成功人士事后分享的经验,难免有些马后炮的味道。但 Wang 去年谈这些时,还没有今天的 Muse。
如今再回头看他所强调的专注和“overdo”,就不难理解他和团队为什么能在这么短的时间里做出 Muse,并取得这样的开局了。
顯示更多

马克·扎克伯格在夏威夷Kuai岛建了一座私人庄园,地下还规划了一个约 465 平方米的防空洞。
据报道,这座私人庄园土地购置加上建设费用,预计超过 2.7 亿美元。地下空间设有生活区、机械设备间和逃生出口,门用金属和混凝土打造,整个庄园还规划了自己的能源和食物供应。
被问到是不是在建“末日地堡”时,他说:“就是一个小避难所,像地下室一样。”
465 平方米,大约相当于四五套普通公寓。他口中的“小”,确实和我们普通人理解的不太一样。
顯示更多

硅谷 AI 人才市场好像很火爆,懂技术、会做内容的人,被开出了500万到5000万美金惊人的身价。
一位叫 adel的创作者发帖,说现在 AI 创业公司最难招的一类人,要同时具备四种能力:
- 常年泡在网上,知道最新趋势;
- 有审美,能创作新媒体内容;
- 懂 AI,也懂技术;
- 能把事情高质量地做出来。
单看每一项,似乎都能找到人,但凑在同一个人身上,就很稀缺了。
随后,swyx 接话:在前沿 Agent 实验室,这类人才的薪酬包行情是 500万到5000万美元。swyx 本名 Shawn Wang,是在旧金山发展的新加坡华人,也是 AI Engineer 大会的联合创办人、Latent Space 的联合主持人,长期推动 AI 工程师社区。交际广, 对业界的行业自然很熟。
这个数字一出来,评论区连熟悉的AI技术圈面孔都坐不住了。
poteto,也就是 Lauren Tan,曾在 Meta、Netflix 和 Cursor 工作,广受欢迎的/poteto-mode的作者,留下了一个「👀」。
Theo 则直接问:「能帮我牵个线吗?」他是开发者圈知名的技术 YouTuber,也是 T3 Chat 的创始人。
当然,这个数字也有人当场质疑。AI YouTuber Matthew Berman 就回复:「5000万?不可能。」
不管怎样, 把技术讲明白、把内容做好,再把事情落地,这几种能力叠在一起,确实开始是 AI 公司的香饽饽了。
顯示更多


going rate for this role is between 5-50m comp package btw at the frontier agent labs
自从去年底跟 AI 较上劲以来,我还从来没看过一次电视。这部片子居然让我有了久违的追剧冲动。
AI or Crazy Rich? 帮我选一个。😂
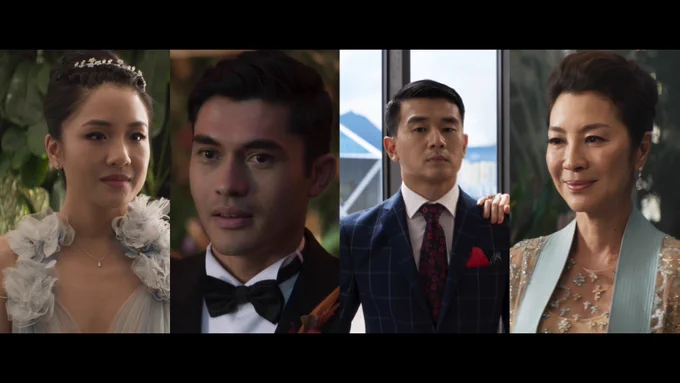

Not just rich — crazy rich.
From Jon M. Chu and Adele Lim, #CrazyRichAsians# will continue as an HBO Original Series starting production in 2027. Constance Wu, Henry Golding, Ronny Chieng, and Michelle Yeoh reprise their roles based on Kevin Kwan's bestselling books.
顯示更多
马斯克昨天发帖说,他感觉SpaceX 未来价值超过当前全球经济规模几个数量级。
这边,网名叫「Masa’s Son」(孙正义儿子)的账号,直接贴了一张马斯克过去「说到的」和「做到的」对照表,确实有点残酷!
顯示更多


敏捷开发年代,“两张披萨团队”(two-pizza team)非常时髦:两张披萨够吃差不多八到十个人。
到了 AI 时代,Dan Shipper 开始提出“两块披萨团队”(two-slice team)了:一两个人就够。
他给这两个人安排的角色是“海盗”和“架构师”。海盗用 AI 快速尝试,不断做、不断扔,从一堆粗糙原型里找到有价值的东西;架构师再把它打磨成可靠、优雅、可以继续扩展的系统。
按他的经验,一两个人已经能推进得很快,再加人,协调成本和想法分歧反而会拖慢进度。
顯示更多







