搜索结果 v32
v32 贴吧
一个关键词就是一个贴吧,路径全站唯一。
用户
未找到
包含 v32 的推特

Protocol Watch 创始人 Christine D. Kim 表示,Bitcoin Core v32 已于 8 月 20 日完成功能冻结,开发者目前主要进行 Bug 修复和小规模优化,正式版本预计于今年 10 月发布。v32 的主要更新包括通过多 CPU 核心并行处理将区块验证速度最高提升约 3 倍;引入全局交易队列及速率限制,提高节点在交易量突然激增时的稳定性;同时加入基于 Mempool 状态的手续费估算机制,以减少手续费高估。此次更新不涉及 Bitcoin 网络层面的协议规则变更。
显示更多


《吴说 8 月技术月报:BIP-110 分叉失败,Glamsterdam 进入公开测试,Solana 加速至 350ms,L2 开启 200ms 竞争》8 月区块链要点:Bitcoin BIP-110 矿工支持率仅约 2.5%,相关少数链短暂运行后基本停滞。Bitcoin Core v32 完成功能冻结,区块验证速度最高提升约 3 倍。以太坊 Glamsterdam 进入公开测试阶段,Hegotá 推进候选方案筛选。Solana、BNB Chain、Polygon 和 Arbitrum 等网络同期推进共识、扩容、Gas 模型、ZK 证明及安全相关更新。阅读全文:
显示更多

《爸爸不在家》第7集
夜晚里屋门半开,妹妹偷听得发抖🍆
妈妈被按在沙发上后入,巨乳晃动,哭着让他射满。白浆灌进宫口后,群P开始全沦陷
#AI短剧# #家庭伦理# #巨乳# #群p# #荔枝短剧# #成人短剧#
👇🏻点击下方解锁全集👇🏻
显示更多


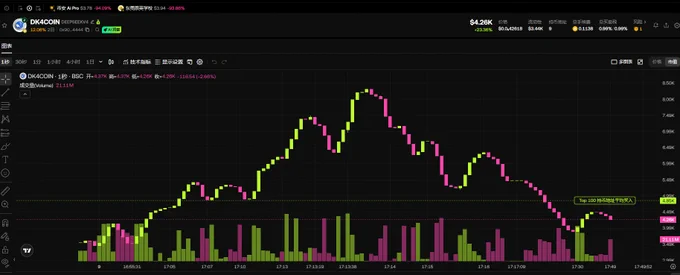
Meme 骗局提个醒
在群里在传 DeepSeek-V3.2 源码里有个钱包私钥,并且有人用这个地址创建了 "DK4COIN"代币
听起来很有噱头,但去 HuggingFace 查了一下发现不对劲
DeepSeek-V3.2 是25年12月1日开源的,文件里确实附带了一个测试钱包私钥
对应地址是 0x27327c754b5ee4df315f7cc74c2dc4358690d2a8
但这个 meme 代币是4月7号才创建的
也就是说,这是有人拿到了四个月前就公开的私钥,最近才去创建代币,然后包装成"DeepSeek官方钱包"的叙事来炒作
和 DeepSeek 本身没有任何关系,所以这个meme 没有任何意义,纯纯的叙事套壳
显示更多


🐳 DeepSeek 刚开源了 DeepSelect,大模型里“从海量候选中挑出前 K 个”这一步,比 PyTorch 自带的 torch.topk 快 2 到 20 倍。
它是给 DeepSeek 稀疏注意力 DSA 和采样器用的 TopK 内核,而 DSA 就用在 DeepSeek V3.2、V4 和 V4.1 上。仓库昨天才建,今天就发了 1.0.0。
稀疏注意力的思路是每一步只看最要紧的那部分 token,挑哪几千个就靠 TopK;生成时从约 12.8 万的词表里采样,也要先挑出前 K 个候选。
DeepSelect 把这两个场景分别做了优化:批大小、词表大小随便设,K 最多到 4096,每一行还能单独设长度上限,接口同样返回 values 和 indices 两个张量。默认开着 NaN 检查,发现坏数值直接终止程序。
如果你在做推理框架、抠每一步的开销,可以拿仓库自带的基准测试跑一遍对比。
GitHub:
显示更多


我汇总整理了一下各个模型现在的input和output价格,minimax定价很低,但deepseek和grok定价更低,数据排名却很差.
说明minimax m2.5只少从开发者实践后用量上看,很可能强于grok4.1和ds v3.2.
国内最赚钱的模型还是kimi2.5 ,output定价最高2.2u.
真正最强看来是claude,大家都舍不得用,实在太贵,除非特别难的编程任务.
input价格比其他家的output都要高,3u/m.
output更是高达15u/m.
显示更多

除了单日霸榜,MiniMAx凭借编程能力,完成了周数据的霸榜.按照目前速度,最终会到2.6T以上,相当于Kimi2.5的俩倍.


我分析了世界杯决赛22个人的八字,梅西或将再次夺冠封神?
之前算卦不靠谱,因为因素太多了,这次尝试算全队的八字来分析决赛那天的运势(仅以前三柱估计),仅供娱乐。
首先确认了决赛的时间是在2026年7月19日美国东部时间15:00左右,对应丙午年乙未月甲午日,木火旺,喜木火的球员将获得极大的能量加持,状态神勇,胜率更高。
那么可以通过分析双方队员的八字来看哪队喜木火人数更多,以及分析亚马尔和梅西的八字来粗略估计冠军。
八字排盘和喜用分析系统:使用人生K线v3.2引擎,防止ai幻觉错误排盘。信息搜集和分析模型使用claude-opus-4.8,具体分析结果如图2-3,信息如下:
1)阿根廷9名球员在此日的五行环境顺遂,其中迪布·马丁内斯、德保罗、恩佐·费尔南德斯三位关键球员更属"强喜",而西班牙仅有8人喜木/火,阿根廷小胜。
2)梅西的甲辰日主遇甲午日,天干纯甲比扶,是极为应景的"比劫得令"状态,加上他整个2026年火运食伤正旺,才华将获得最大表现。亚马尔八字也喜木火,也将全力发挥,双方打平。
3)西班牙的三名"忌木火"球员中,罗德里(庚金身弱)和法比安·鲁伊斯(庚金身弱)在强木火日最受压制,恰好两人都是核心中场,影响较大。阿根廷小胜。
总结:阿根廷9人 略胜 西班牙8人,猜测阿根廷小胜,分差可能很小,仅为1分。
显示更多


魔法! DeepSeekV4 上下文内存压缩到1/10!
大家都知道 DeepSeekV4 是支持1M上下文的, 而且经过了极度优化, 如果要真的用到1M上下文, 显存占用只需要10G左右, (对比之下 DeepSeek-V3.2 大概需要84G显存). 然后我刚看到了FlashMemory这个论文, 直接能把显存占用压到 1.3GB! 甚至输出效果不降反升!
哥们你骗兄弟可以, 骗自己就没意思了, 真的吗? 压缩后反而性能上升? 我赶紧看了论文细节:
咱们先复习一下传统做法: 模型每吐出一个字,都要把之前的几十万字重新看一遍(这就是全局注意力).
FlashMemory 的做法是: 预测未来需要什么, 它内置了一个神经内存索引器(Neural Memory Indexer, 其实就是个小模型了),能够主动预判接下来生成内容时需要用到历史文本里的哪些片段. 然后预先准备好这些片段, 接下来只要做到命中率超高, 那么这个提升就绝对有效. 即它的假设是, KVCache里面的东西并不是生成每个字的时候全都需要的, 只需要按需提前加载即可.
很像做作业的时候, 把参考资料摊满桌子, 然后优化了一下就是把参考资料需要用到的部分直接拍照, 用的时候看照片就行了.
那么听上去很简单, 但实际的难点在于, 训练一个专用的索引器小模型, 需要把 DeepSeek-V4模型加载到显存里一起炼. 相当耗费算力.
于是这篇论文第二个亮点来了, 它搞了个解耦训练. 他们把这个索引器当成一个标准的"双编码器(Dual-encoder,类似做搜索推荐的模型)"来单独训练. 在这个过程中,根本不需要把庞大的 DeepSeek-V4 基座模型加载到显存中. 这让训练成本断崖式下降,且兼容标准的检索(Retrieval)训练框架. (简单来讲就是它是通用方法训练的, 通过query预测需要检索哪些长句子. 所以其实是个通用模型)
听上去靠谱, 那也只是显存占用少了, 怎么就性能还提高了呢? 答案是注意力降噪. 因为每次只提取和当前生成最相关的记忆块(Chunks)放入显存,模型在运算时就看不见那些无关的冗余信息了.天然地起到了一种"去噪"作用,这也是为什么显存占用少了,模型准确率反而略微提升的原因.官方测试在长文本评测集(如 LongBench-v2 等)上的准确率平均最终提升了 0.6%.
(其实还有数据如何逐出显存和如何预测数据实现预加载, 这部分也很棒, 很有启发性. 建议看原论文, 篇幅原因写不下了)
论文地址:
项目地址:
#FlashMemory# #DeepSeekV4# #FlashMemoryDeepseekV4#
显示更多


