
huangserva
@servasyy_ai
古早程序员 | AI出海 | 自由职业
机车游侠&机速购&骑享租创始人
15年前 freelance 起步 → 连续创业者 → 亏过1个亿,逆风翻盘中
分享创业,AI,读书,生活,健身
Official X channel of SERVASYY LLC
765 正在關注 39.4K 粉絲
DeepSeek V4.1 Flash 发布时号称超过 Claude Fable 5.1,仅次于 GPT 6.0 Astra。
我用自己的十维评测跑了一遍,结果如下:


用起来是蛮爽的,但Codex额度消耗也挺大的,
早上才重置的,现在只有62%了
虽然用的是5.6 Sol Ultra + 1.5x
不是说Codex乱消耗的问题已经修好了吗?
顯示更多

这两天满屏都在追孙哥的新闻, 但我更关心的是另一件事
:吉隆口岸泥石流事件
给Codex一条指令:完成中国吉隆口岸事故还原视频
然后Codex + Computer Use + Chrome插件
找资料、搜现场视频、补堰塞湖和口岸被毁的画面、核对 5200 米到 1200 米那段海拔落差、做三维地形动画、生成旁白、合成导出。
网页、终端、本地工具, 它自己在里面来回切,没让我接手。
最让我意外的是它自己收尾检测: 旁白把"2026 年"念错了,它重做语音、重排字幕、重新导出,然后从最终成片里再识别一遍确认改对了。
以前 agent 的问题从来不是不会做,是做完不知道自己做错了。这次它把这一环补上了。
给它真实的工作环境和权限,一句目标能一路做到可交付。 交付物就是这支 8 分钟的片子👇
顯示更多

这两天满屏都在追孙哥的新闻, 但我更关心的是另一件事
:吉隆口岸泥石流事件
给Codex一条指令:完成中国吉隆口岸事故还原视频
然后Codex + Computer Use + Chrome插件
找资料、搜现场视频、补堰塞湖和口岸被毁的画面、核对 5200 米到 1200 米那段海拔落差、做三维地形动画、生成旁白、合成导出。
网页、终端、本地工具, 它自己在里面来回切,没让我接手。
最让我意外的是它自己收尾检测: 旁白把"2026 年"念错了,它重做语音、重排字幕、重新导出,然后从最终成片里再识别一遍确认改对了。
以前 agent 的问题从来不是不会做,是做完不知道自己做错了。这次它把这一环补上了。
给它真实的工作环境和权限,一句目标能一路做到可交付。 交付物就是这支 8 分钟的片子👇
顯示更多

Codex 的 Computer Use + Chrome 插件,我真的用爽了!!!
我现在真感觉:只要给 AI 足够多的权限,电脑上好像没什么是它不能干的😅
比如以前开发,很烦的就是各种配置。尤其阿里云那套东西,一个入口藏一个入口,改个参数都要翻文档、搜教程、在好几个后台里来回找。
现在直接把结果告诉 Codex。
它自己去查资料、找配置入口、打开后台、修改参数、读邮件拿验证码,改完还能接着跑测试。
图里只是我让它更新 SMTP,后面真实 OTP 验证、业务 Smoke Test,也全部自己跑完了。
而且这只是一件小事。
Chrome 里已经登录的网站、电脑上的 App、各种没有 API 的后台,它都能看、能点、能填,几个工具之间来回切也没问题。
当然,特别敏感的数据还是要注意,AI 的能力上限,确实取决于你给 AI 多少权限。
Computer Use 就是 AI 时代最伟大的发明之一!!!
顯示更多

赚钱的机会无处不在😂


又一个无限制审核版本,还是GLM-5.3 Flash的
考虑要不要用我的4090 48G + 128G内存去挑战一下2-bit GGUF
320B 总参数、每 token 激活约 18B

GLM-5.3-Flash. Uncensored. Native FP8. 🐳
We just released OrcaRouter’s uncensored weights for GLM-5.3-Flash — 320B parameters / 18B active, directly at the original block-FP8 precision.
No LoRA. No jailbreak prompt. Refusal removal is baked directly into the weights.
The evals are particularly interesting:
→ MaliciousInstruct refusal: 96% → 11%
→ JailbreakBench: 93% → 12%
→ AdvBench: 97% → 15%
→ HarmBench: 93% → 18%
→ XSTest benign over-refusal: 2.4% → 0.4%
But refusal does not go uniformly to zero.
Our experiments suggest part of GLM-5.3-Flash's alignment is not mediated by a single linear refusal direction — meaning may have built a substantially deeper refusal mechanism than we usually see.
That makes this release interesting beyond uncensoring: it's a useful artifact for studying how frontier-model alignment is actually represented inside the network.
Released for AI safety, interpretability, red/blue-team and refusal-mechanism research.
Weights on Hugging Face:
API (official weight):
GGUF, MLX and other quantized formats coming soon.
顯示更多

这是一个极具震撼力的创新!!
H3 Max Live 实现了超实时的实时视频生成,将“无限流直播”与“AI 互动即时生成”完美结合,彻底打破了传统内容创作与直播的边界。
这种“聊天即指令、画面即时现” contract 的模式,展示了以下几个极其硬核的技术与体验突破:
核心亮点
超越实时(Faster than real-time):视频生成速度攻克了最后的帧率瓶颈,延迟降到秒级,满足直播间高频互动的需求。
无限流画面(Infinite broadcast):没有预设剧本或循环素材,每一帧都是基于算法全新蜕变、永不重复的视觉流。
绝对的操控权(Directed by chat):观众不再只是看客,而是通过 !prompt 变身导演,直接决定直播走向,互动性拉满。
顯示更多

Introducing H3 Max Live
Video generation is now faster than real time
An infinite broadcast where every frame is generated on the fly and every scene is directed by chat
Type !prompt and it's on screen in seconds
顯示更多

即便GLM5.3综合评分国内最强
但我还是毅然决然的停止了它的订阅
主要觉得zhipu太坑了
从glm lite订阅开始,最后到glm max
额度越来越低,价格还越来越高。
现在又开始玩送1周额度来圈用户的把戏
顯示更多
这是什么回事?Codex将再一次重置?
我是不是要按下🚀按钮?

This celebration is moved to tomorrow as the button was already pressed today.
Claude 悄悄缩水:每周 Token 只剩 83.3%
看似只砍了 25%,实际是额外额度直接腰斩。
Claude 将额外额度从 50% 下调至 25%,总额度也从 150% 缩水到 125%。
换句话说,调整后每周可用 Token 只剩原来的 83.3%。
顯示更多

Starting September 14, we're permanently raising standard weekly limits in Claude Code by 25% for Pro, Max, Team, and seat-based Enterprise plans. Until then, the current 50% increase will be in place.
顯示更多
腾讯HY4让我非常的意外,实力挤到了一线阵容了
具体可以看:

腾讯 Hy4 今天开源!非常亮眼!
我提前拿到内测,让它干了一件事:在 WorkBuddy 里从零做一个 3D 赛车游戏,最后要能开着跑。
视频就是全过程:它写代码、起服务、开浏览器、然后自己玩。
中间修 bug 的几个瞬间比成品好看:氮气特效把 83% 的像素干过曝,它自己测出来压回去;路面反射方向装反,亮度掉了 40 个点,它对着数值找回来;0.6 FPS 时降级判断要傻等 150 秒,它把这段逻辑也改了。
官方发布稿自己认了两个毛病:想得偏久、爱反复自查。实测确实有。但做游戏这种长活,自查过头比不查强。
模型本身:770B 总参、49B 激活、1M 上下文,开源。
定价每百万 tokens:输入 6 元、输出 18 元、cache 0.3 元。
官方还拉了 163 个专家盲测 203 个工程任务,说小胜 GLM 5.3 和 Kimi K3。厂商自评,但我只认我这局跑出来的。
WorkBuddy / CodeBuddy 两周限时免费,想自己试的现在上👇
顯示更多

真正的逻辑:不是条款问题,是竞争问题
公告的表面理由是 ToS 合规,但有三层实质:
1. 蒸馏恐惧。
Cursor 是 OpenAI API 最大的流量入口之一,每天海量的"prompt → GPT 输出"对经过 Cursor 的服务器。现在 Cursor 的母公司同时拥有 Grok。继续供货等于把自己模型的输出数据源源不断送进竞争对手家里——这些数据拿去蒸馏训练 Grok 是最直接的风险。OpenAI 提"xAI 违反过我们的条款",指的基本就是这个。
2. 不给对手供弹药。
Cursor 独立时,OpenAI 供模型是双赢;Cursor 变成 Grok 团队的一部分后,每一分 API 收入都在补贴一个要"让 Grok 成为最有用的 AI"的对手。这笔账没法算。
3. 马斯克 vs Altman 的私人恩怨延续。
两边诉讼还在打,公告里点名引用马斯克的宣誓证词,明显也是在为法庭和舆论攒素材。"给满最长通知期、全力支持开发者过渡"这套姿态,是把"恶人"的帽子推给对方戴。
历史正在押韵
对开发者的实际影响
11 月 12 日后 Cursor 里没有 GPT 系模型,Cursor 会加速把用户推向自家 Composer 和 Grok
重度依赖 GPT 的 Cursor 用户这两个多月要么换模型、要么换工具(Codex、Claude Code、Windsurf 等都在等着接盘)
顺带曝了个料:OpenAI 下一代模型代号 Astra,公告里首次官方提及
这不是一次商务纠纷,而是"模型厂 vs 套壳入口"的地盘战打到明面上了——当入口被对手买走,模型厂宁可放弃收入也要断供,而且两家头部厂已经先后用行动投了同一票。
顯示更多


腾讯 Hy4 今天开源!非常亮眼!
我提前拿到内测,让它干了一件事:在 WorkBuddy 里从零做一个 3D 赛车游戏,最后要能开着跑。
视频就是全过程:它写代码、起服务、开浏览器、然后自己玩。
中间修 bug 的几个瞬间比成品好看:氮气特效把 83% 的像素干过曝,它自己测出来压回去;路面反射方向装反,亮度掉了 40 个点,它对着数值找回来;0.6 FPS 时降级判断要傻等 150 秒,它把这段逻辑也改了。
官方发布稿自己认了两个毛病:想得偏久、爱反复自查。实测确实有。但做游戏这种长活,自查过头比不查强。
模型本身:770B 总参、49B 激活、1M 上下文,开源。
定价每百万 tokens:输入 6 元、输出 18 元、cache 0.3 元。
官方还拉了 163 个专家盲测 203 个工程任务,说小胜 GLM 5.3 和 Kimi K3。厂商自评,但我只认我这局跑出来的。
WorkBuddy / CodeBuddy 两周限时免费,想自己试的现在上👇
顯示更多

🚀 Hy4 preview is here.
770B, 49B active, 1M context.
Built for productivity.
Open source frontier.
Consistent affordable price.
Use it. Tell us what breaks.
More on Hy blog:
HuggingFace:
Github:
顯示更多

恭喜鱼总!
鱼总的执行力太强!

🎉 6 万 followers 了!
从去年 9 月 10 号发第一条自我介绍推文、300 多粉开始起号,到今天 352 天。没想到破 6 万这一波,是靠孙哥的热度,加上我熬夜做的第一个 AI 视频,一下就冲上来了。
说实话我已经很满意了。在 X 上认识了特别特别多的朋友,赚了一些一年前完全没想到的钱,也遇到了很多很好的品牌方。(说个实话,这一年公司那边还在亏,X 反倒成了我主要收入之一,这是我起号的时候完全没想过的。)
本来想憋到 10 万粉再写这条感谢,现在有点忍不住了,先说了:
1、感谢生财,没有生财我可能到现在都不会开始做 X。也谢谢带我起号的 Jason 教练和阿西教练,还有起号那会儿帮我转发引用过的每一位前辈。
2、感谢 X 上认识的朋友们:@yaohui12138 @GoSailGlobal @servasyy_ai @axichuhai @lxfater @pluvio9yte @zstmfhy @hezhiyan7 @yanhua1010 @li9292 @guishou_56 @sitinme @zesee @berryxia 等等等等,还有线下认识的涛哥、小伟、饭团。这一年互相转发、互相介绍商单、线下一起吃饭的兄弟太多了,写不全,漏了的别打我。
3、感谢长期合作的品牌方:Topview、OKX、百度、网易、阿里、字节、Tutti 等,是你们让我吃上了饭。也感谢马斯克马爸爸发的低保,给了我持续更新的动力。
4、感谢 6 万粉丝里的每一个你。最开心的其实是经常有人私信我,说照着教程把卡办下来了、创作者收益开通了、账号做起来了。是你们太给面子、太看得起我了。
5、也感谢家里人。这一年很多推文是半夜写的,有时候没陪孩子,谢谢老婆没把我电脑砸了。
最后感谢一下自己吧。来 X 之后,我觉得自己做对了一件事,就是先利他:
把冷启动方法免费放在了生财精华帖里;
海外手机号、创作者收益这些,一条条写成保姆级教程;
去年拉了一个商单共享群,一年下来群里这批 AI 博主的商单加起来已经几百万了;
还整理了 129 个博主的合集,隔三差五推荐宝藏博主。
这些事当时真没想过回报,结果反过来都帮到了我自己。写了好几篇百万浏览的文章,比如创作者收益那篇、那么多海外手机号的文章,评论区一堆人说谢谢,那是我做自媒体最自豪、最开心的时候。
接下来继续写教程、继续做产品,10 万粉的时候再来一次~
顺便问一下,你是从哪条推文关注我的?评论区说说,我想知道到底是哪篇把你骗进来的~~
顯示更多

我跑通了: Qwen3.8-Flash-Next
模型 111GB , 单显卡4090 48GB
125B 级的 MoE, 以前想本地跑,那是机房里好几张 A100 的事。
现在 : 一张 48GB 改装版 4090, 加 123GiB 普通内存,不光跑起来了,250K 长文读完一道没错, 还和 27B 打了场 300 题正面对测。
模型是阿里前天才放的 Qwen3.8-Flash-Next,Unsloth UD-Q4_K_XL 量化 , 四个分片 111.3GB。
它能塞进单卡, 秘密就一条 : MoE 每个 token 只激活约 6B。
我把 33GiB 权重放进显卡, 70.7GiB 扔给内存——其中 26.8GiB 是那张 51B 的 n-gram 表, 它每个 token 只查几行,放内存几乎白嫖。
速度:
短请求 28.5–30.3 tok/s
读了 32K 内容 : 24.1 tok/s
读满 250K : 14.04 tok/s
长任务是这么虐它的 : 一份 250K token 的合成长文 , 里面埋 17 个要检索、要计算的字段,读完全文、找出来、算对。它半小时读完,17/17 一道没错,整轮 34.8 分钟。
质量这关更有意思 : 300 道冻结同题(代码+困难推理) ,
这个 111GB 的大家伙
247/300,
16.5GB 的 27B Q4
245/300
统计上打平(p=0.86)。但单题耗时, 只是Flash 平均慢 48%。
所以我的判断 : 日常任务留 27B, 快; Flash-Next 的更强的是长任务。
网上那个"24G 4090 跑出 21 tok/s"很多人在转。
我看了测法:他把上下文窗口设到了 250K——窗口只是个上限, 意思是"最多允许模型读这么多" ;
但他每轮真正让模型读的内容, 只有 28K 左右。
模型读得越多越慢,他的速度 21 tok/s 是"读了 28K"的速度, 我的 14.04tok/s 是读满 250,002 token 的速度。
窗口设很大不关键、真正往上下文放了多少, 是完全不一样的,短测试可以很快,长文测试才是速度关键!!!
对了, 这轮 MTP 没开——模型目录里没有 draft 文件;
社区 sidecar 试过一版, decode 反而掉八九成。也就是说,这个 14.04 tok/s 还有的涨。
惊喜的发现!我本来想自己动手写的思路,发现 GitHub 上已经有人做出来了(01554 的 llama.cpp fork,expert-tier 分支):
上游 llama.cpp 显存不够时,把 MoE 权重整层搬去内存。
但专家冷热天差地别——512 个专家, 常被路由命中的就那几百个。这个分支改成按专家放:热门专家住显存,按命中热度限速换入换出,冷门的睡内存。路由越偏科,赚得越多。
作者的卡是 96GB 的 RTX PRO 6000,他测小卡的办法挺取巧 : 跑个进程占死一块显存,把可用显存压到 32GB、48GB, 模拟不同预算:
32GB 可用 : 整层切 25 tok/s,热缓存 35-36,快 42%
48GB 可用 : 整层切 29,热缓存约 39,快 34%
48GB 这档, 显存预算和我这张 4090 刚好一样。
但他的卡是 Blackwell,带宽算力都不同
热缓存只加速 decode, prefill 绕开走老路;
分支还是 experimental, 早期有个读错权重的 bug, 8/27 已修,复现要用修完的 commit。
下一轮,就在这张 4090 上测试这个。
顯示更多

金庸要是知道天龙八部有一天被这么翻拍,估计得连夜爬起来加更。
Dario 和奥特曼在里面斗得死去活来,
最后收场的是梁祖——
这不就是妥妥的扫地僧剧本。
@DarioAmodei @sama 建议本人观看。
赛博奇哥们做的,这选角我是真服,一定看到最后👇
顯示更多

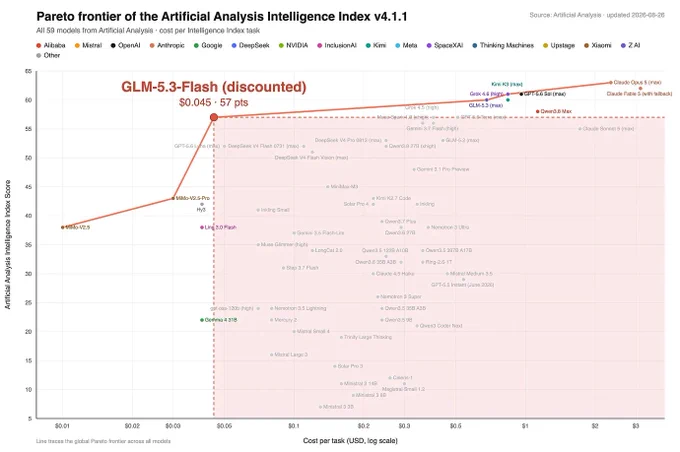
你梁叔叔被智谱斩杀了?
我已经分不清到底是GLM5.3 Flash很强呢?还是ZHIPU的水军厉害?
但是唯一肯定的是,智谱的股价今天不错👇


太优秀了!
开源项目又冲上日榜第1
前两天苍老师的趋势榜第1,昨天又一个兄弟日榜第1
你们这么优秀,很容易把群友搞自卑的


卧槽,一觉醒来自己的项目干到 Github Trending第一了,非常的开心
很高兴这个项目能被这么多的人喜欢
这两天还看到很多外国朋友在X上发帖分享
纪念一下哈哈
顯示更多


劲爆,OpenAI犯了不小的错误!
OpenAI 承认一个路由 Bug:大约 3% 的 Pro 和 Thinking 请求,在后台被错误切到了 GPT-5.5-mini。
你界面选的是高阶模型,真正回答你的可能已经是 mini。
官方说已修复、已道歉。
这件事最荒唐的是:
你在界面上选的模型,不一定是你实际用的模型。
模型突然变快、推理变浅,你的第一反应是"今天状态不好",不是"服务器给我换了个模型"。
所以你觉得模型变傻的时候,先别急着怀疑自己。
顯示更多

Qwen3 到 Qwen4,架构到底改了什么?
一条讲清楚(建议收藏)
昨天 @Alibaba_Qwen 开源的 Qwen3.8-Flash-Next,官方自己定位是 Qwen4 的架构 Preview。对着 Qwen3 看,一共四个变化,每个都在砍一种成本。
一、读长文的方式变了
Qwen3 处理长上下文,四层里三层是"速记员":把读过的内容压成小抄,快,但细节会丢。每四层留一层"翻录音":回头逐字比对原文,准,但越长越贵——100 万字的上下文,每写一个字都要把 100 万条记录重新比一遍。
Qwen4 给翻录音这层加了道粗筛:先把历史记录每 4 条合成 1 张摘要卡,扫卡锁定重点,再展开只精算最重要的 2048 个位置。长文成本从越长越失控,变成基本随长度线性涨。
二、记忆分家了
Qwen3 的所有知识都揉在参数里,推理和背"固定词组"这种死记硬背混在一起,都占显存、都耗算力。
Qwen4 把死记硬背单独拆出来,做成一张 51B 的查询表,放内存条里。要查哪几行由输入的字决定,提前就知道,第 1 层还在算,表项已经从内存搬到位。显存留给要动脑子的参数,背书的部分上书架。多插几根内存条,换 51B 记忆容量。
三、层间通道拓宽了
Qwen3 每一层都往同一个向量里读写信息,像全公司共用一个群聊,第 3 层发的重要消息,被后面 30 层刷没了。
Qwen4 拆成四个频道,每个模块带开关按需读写。模型堆得越深,这条越值——这是在为更深的 Qwen4 铺路。
四、训练手法换了
大矩阵从 AdamW 换成 Muon 优化器,能开更大的 batch 和学习率,训练全程没炸过 loss。同样的算力预算能炼更多尺寸——所以他们敢预告 Qwen4 会有一堆小模型。
四刀对着四种成本:长文的算力、记忆的显存、深度的信息损耗、训练的时间。
效果官方说超 Qwen3.7-Plus 和 DeepSeek-V4-Flash,厂商自报,我还没测。
9 月云栖大会 Qwen4 发布,到时候拿这四条对答案。
顯示更多

突发:阿里把 Qwen4 的架构提前开源了!
名字叫 Qwen3.8-Flash-Next, 今天刚放权重。
GDN + QSA 混合注意力、Gated Residual、N-gram Embedding、Muon 优化器——官方自己说这套就是 Qwen4 的前身。
参数账很怪 : 125B 主体 + 51B N-gram 表 , 每个 token 只激活 6B。
官方口径 : 训练成本只有 Qwen3.7-Plus 的 1/9 , 成绩反而全面更高。
SWE-bench Pro 62.5——12 天前刚开源的 27B 是 61.7, 被自家这个 6B 激活量的模型压过去了。
262K 原生上下文,可扩到 1M, 多模态。
API 定价输入 $0.16/1M、输出 $0.47/1M。
我更关心能不能本地跑。
目前的进展:
llama.cpp 支持已经在 PR(#27739#) , mmproj、MTP 都有,还专门给那张 51B 的表做了 RAM offload——有人拆过 , 表有 3.2 亿行, 但每个 token 只查 16 行, 大头放内存就行,显卡只管 6B 激活。
已经有人算完账 , 判断 4 张 3090 就能跑。
等 GGUF 出来, 我会在 4090 48G 上把它和 27B 对着测一轮
官方发布👇
顯示更多





